
四參數羅吉斯生物檢定的附加功能
本附加功能為四參數羅吉斯方法增加了 ANOVA / CI error term 設定。Sequential(預設)讓每個 F 檢定使用各自巢狀模型的殘差;Pure Error 則與 EP 5.3 軟體一樣,對三項有效性 F 檢定(迴歸、非平行性、失擬)和效價信賴區間統一使用飽和模型的殘差。Pure Error 要求資料中有一定的重複。曲線參數和效價估計值保持不變。
最後審閱
核心要點
四參數羅吉斯生物檢定的誤差項選項用於選擇:有效性 F 檢定和效價信賴區間使用依次巢狀模型的殘差,還是如 EP 5.3 那樣使用單一的純誤差項。
本頁內容
生物檢定 — 四參數羅吉斯方法
新增功能:可選的 ANOVA / 信賴區間誤差項(「Sequential」與「Pure Error」)
新增內容
四參數羅吉斯方法新增了一項可選的誤差項約定,與平行線法和斜率比法中已有的同類約定相似,並根據本方法自身的模型結構做了調整。該選項控制由哪一個變異數估計值同時用於三項有效性 F 檢定和效價信賴區間(而不像兩種線性方法那樣只用於信賴區間),這反映了本方法 ANOVA 的結構特點。無論選擇哪種約定,配適的曲線參數和效價點估計值都不受影響。
法規與統計背景
四參數羅吉斯(4PL)檢定用一條S形曲線配適每個製劑的反應隨對數劑量的變化,該曲線由上漸近線、下漸近線、斜率因子和拐點決定。構建有效性檢定時需比較三個巢狀模型:零模型(水平線)、所有製劑共用同一條曲線形狀的模型(僅拐點可以不同,效價估計值即由此產生),以及對每個製劑分別獨立配適的完全獨立曲線模型。
與其他生物檢定方法一樣,符合歐洲藥典(Ph. Eur.)第 5.3 章「生物檢定和試驗結果的統計分析」的商業軟體,通常用同一個共享誤差變異數項來構建全部三項有效性 F 檢定以及效價信賴區間,即其「Pure-error ANOVA」約定。本工具原有的預設做法則是為每項 F 檢定使用各自更貼合的誤差項。
數學原理
約定 A ——「Sequential」(本工具原有的預設設定)。三項 F 檢定中的每一項,都由其所檢驗的那一對巢狀模型構建,並以該比較自身的殘差變異數作為分母:
F(Regression) = MS(共享曲線相對水平線所解釋的部分) / MS(共享曲線配適的殘差)
F(Non-parallelism) = MS(獨立曲線相對共享曲線所解釋的部分) / MS(獨立曲線配適的殘差)
F(Lack of Fit) = MS(飽和配適相對獨立曲線所解釋的部分) / MS(飽和配適的殘差,即純誤差)
同樣,效價信賴區間使用共享曲線模型自身的殘差,從而合併了少量不顯著的非平行性。
約定 B ——「Pure Error」(新增選項;即 EP 5.3 的「Pure-error ANOVA」)。三項 F 檢定和效價信賴區間始終共用同一個分母,即完全飽和的、每個製劑 / 劑量組一條曲線的配適殘差:
F(任一檢定) = MS(該檢定所比較部分的解釋量) / MS(來自飽和配適的純誤差) —— 每次分母相同
原理:為何有兩種約定,以及各自的適用場合
這兩種約定回答的問題略有不同,與兩種線性方法的情形完全一樣:Sequential 約定根據與該比較相關的具體變異性來判斷每項檢定的顯著性;Pure Error 約定則對每項檢定提出同一個根本問題——「這一偏離與純重複雜訊相比如何,且不合併任何其他因素?」——並進一步把效價信賴區間與這一儘可能最窄的誤差估計值繫結。
對於配適良好且有效的檢定,兩者的差異通常很小。當存在少量不顯著的非平行性或失擬時,差異會更明顯:Sequential 約定會把這部分額外變異併入相應檢定(及效價區間)的誤差項,而 Pure Error 約定則有意在所有地方將其排除。
與其他方法一樣,選擇「Pure Error」主要用於使結果與符合 EP 5.3 的商業軟體或基於其 Pure-error ANOVA 約定的既有已驗證方法保持一致。在無需與外部結果比對的情況下,本工具原有的 Sequential 預設設定仍然是完全有效的選擇。
輸出中哪些會變化,哪些不會
受影響的內容:
- 三項有效性檢定(Regression、Non-parallelism、Lack of Fit)的 F 值和 P 值
- ANOVA 表中新增「Error Term」欄,標明所使用的約定和自由度
- 效價信賴區間的 Lower CL 和 Upper CL,以及新增的「CI Error Term」欄
不受影響的內容:
- 每個製劑的配適曲線參數(上 / 下漸近線、斜率因子、拐點)
- 估計的相對效價比
- 為每個製劑顯示的配適模型方程
在哪裡找到此功能
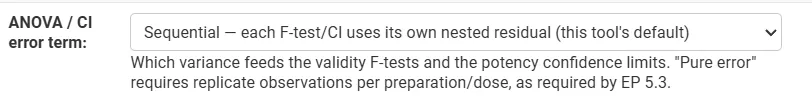
在四參數羅吉斯方法工具的輸入表單中,標有「ANOVA / CI error term」的欄位提供兩個選項:「Sequential — each F-test/CI uses its own nested residual (this tool's default)」和「Pure error — single saturated-model residual for all F-tests and the CI (EP 5.3 default)」。Pure error 選項要求飽和模型(每個製劑 / 劑量組一次配適)至少有一個殘差自由度,即資料中要有一定的重複。
與已發表參考資料的驗證
該選項已用一項已發表的破傷風抗毒素血清學檢定進行核對,該檢定在十個二倍稀釋梯度上比較一個標準品和一個供試血清製劑,每個劑量設兩個重複。
來源:European Pharmacopoeia, 5th Edition (2005), Chapter 5.3, worked example 5.4.1.a — 轉載自 Stegmann Systems 的 PLA 3.0 已發表範例報告(Document-3567,「PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf」)
指標 | 已發表值(PLA/EP 5.3) | 計算值(Pure Error 選項) |
Regression F (df=3) | 9785.4821 | 9788.5262 |
Non-parallelism F (df=3) | 0.48912 | 0.4884 |
Lack of Fit F (df=12) | 0.62266 | 0.6216 |
效價比 | 1.45886 | 1.45880(修約後:1.4588) |
樣本效價估計值(IU/ml) | 0.58354 | 0.5835 |
95% CI(樣本效價,IU/ml) | 0.55511 – 0.61343 | 0.5544 – 0.6127 |
在兩種約定下,曲線形狀參數(上 / 下漸近線、斜率因子、拐點)和效價點估計值都與已發表報告幾乎完全一致,證實配適本身不受該選項影響,符合設計預期。採用 Pure Error 選項計算的 F 值和信賴區間與已發表數值接近,存在少量殘餘差異(主要體現在信賴區間),原因是已發表報告在最終計算前將中間值修約到了三位小數。本工具原有的 Sequential 預設設定不以匹配這份「Pure-error ANOVA」報告為目的,已另行驗證其內部一致。
參考文獻
- 歐洲藥典(European Pharmacopoeia, Ph. Eur.)第 5.3 章「Statistical Analysis of Results of Biological Assays and Tests」(第 5 版,2005 年及後續版本)。
- 美國藥典(United States Pharmacopeia)通則 <111>「Design and Analysis of Biological Assays」。
- Stegmann Systems GmbH,PLA 3.0 已發表的計算範例:「PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf」—— https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel_logistic_potency_assays__3PL__4PL__5PL_/PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf
常見問題
什麼是四參數羅吉斯(4PL)生物檢定?
4PL 檢定用一條S形曲線配適每個製劑的反應隨對數劑量的變化,該曲線由上漸近線、下漸近線、斜率因子和拐點定義。有效性檢定比較三種模型:水平線模型、僅拐點不同的共享形狀模型(由此得到效價估計值),以及為每個製劑分別配適的完全獨立曲線。
4PL 檢定中的 Sequential 與 Pure Error ANOVA 有什麼區別?
在 Sequential 約定中,每項 F 檢定使用其所比較的具體巢狀模型的殘差,效價區間使用共享曲線的殘差。在 Pure Error 約定中,三項 F 檢定和效價區間共用同一個分母:完全飽和配適的殘差。兩種約定下配適曲線和效價估計值相同。
4PL 檢定何時應使用 Pure Error 選項?
使用 Pure Error 主要是為了使結果與符合 EP 5.3 的軟體或基於其 Pure-error ANOVA 約定的既有已驗證方法保持一致。對於配適良好且有效的檢定,兩種約定通常差別不大;當存在少量不顯著的非平行性或失擬時,差異會增大。其他情況下,Sequential 預設設定仍然有效。
如何在 Zometric Statistical Software 中選擇誤差項?
在四參數羅吉斯方法的輸入表單中,透過 ANOVA / CI error term 欄位選擇 Sequential(預設)或 Pure error。Pure error 選項要求飽和模型至少有一個殘差自由度,即資料中必須有一定的重複。