
ARIMA(Box-Jenkins 預測)
ARIMA 使用自迴歸項(p)、差分項(d)和移動平均項(q),以及可選的季節項(P, D, Q, s)和常數項,為等間隔測得的序列建模。當數值依賴於先前的數值,或序列存在趨勢或季節性時使用。ACF 和 PACF 圖可指導階數選擇。輸出包括參數估計、Ljung-Box 檢定、殘差 ACF/PACF、MAPE、MAD、MSD,以及帶預測限的預測值。
最後審閱
核心要點
ARIMA 對等間隔時間序列配適 Box-Jenkins 自迴歸積分移動平均模型,並給出帶預測區間的未來值預測,可捕捉延續效應、趨勢和季節性。
用途
ARIMA 對等時間間隔(每日、每週、每月)測得的序列配適 Box-Jenkins 自迴歸積分移動平均模型,並給出帶預測區間的後續值預測。當每個值都依賴於其之前的值,或序列存在趨勢或重複的季節性,而移動平均或指數平滑等較簡單的方法又不能很好地捕捉這些特徵時,可使用它。執行之前,序列的自我相關(ACF)圖和偏自我相關(PACF)圖有助於選擇模型階數。
主要功能
- 非季節性自迴歸項(p)、差分項(d)和移動平均項(q),以及適用於任意季節週期的季節項(P, D, Q),例如具有年度規律的月度資料取 12,具有周規律的每日資料取 7。
- 可選的常數項:未差分序列的平均水準,或已差分序列的平均漂移(趨勢)。
- 參數估計,附標準誤、T 值和 p 值,便於剔除不需要的項。
- 殘差檢查:殘差平方和與均方,落後 12、24、36 和 48 處的修正 Box-Pierce(Ljung-Box)卡方檢定,以及殘差的 ACF 和 PACF 圖。
- 按所選信賴水準給出帶預測下限和上限的預測值;透過預測起點可從較早的列開始預測,並將預測值與實際發生的情況比較。
- 配適精度指標 MAPE、MAD 和 MSD,可與其他時間序列工具比較。
- 可選的附加輸出:每次迭代的估計值、估計參數的相關矩陣、反向預測值,以及四合一殘差圖。
統計方法
模型為 φ(B)Φ(Bˢ)(1−B)ᵈ(1−Bˢ)ᴰ yₜ = C + θ(B)Θ(Bˢ) aₜ,其中 B 為後移運算元,φ 和 θ 分別是 p 階和 q 階的非季節性 AR 和 MA 多項式,Φ 和 Θ 分別是 Bˢ 的 P 階和 Q 階季節性 AR 和 MA 多項式,s 為季節週期,C 為常數,aₜ 為殘差(隨機衝擊)。差分 (1−B)ᵈ(1−Bˢ)ᴰ 在配適 AR 和 MA 項之前去除趨勢和季節性,因此序列開頭會損失 d + D·s 個觀測。
參數採用帶反向預測的 Box-Jenkins 最小平方法估計:對初始值迭代修正以使殘差平方和最小,並對序列做反向預測以提供其樣本前的值。殘差均方 MS = SS / DF,其中 DF = 差分後的觀測數 − 估計參數個數。每個係數的 T 值為該係數除以其標準誤,p 值取自按殘差 DF 計算的 t 分配。對於含常數項的未差分模型,還會報告製程平均 C / (φ(1)Φ(1))。
Ljung-Box 統計量 Q = n(n+2) Σ rₖ² / (n−k) 由截至各落後期的殘差自我相關係數 rₖ 計算,並與卡方分配比較,該分配的 DF 為落後期數減去估計參數個數;p 值大於 0.05 表示沒有證據表明殘差中仍存在自我相關。預測值由配適方程遞推得出;提前 h 期的預測區間為預測值 ± z·√(MS·Σψⱼ²),其中對模型的前 h 個 ψ 權重求和,因此區間隨預測期的延長而變寬。
輸入欄位和選項
欄位 | 說明 |
Variable (Y) | 必填。存放序列的欄,按時間順序排列,間隔相等。 |
Autoregressive order (p) | 非季節性 AR 項的個數(0 至 10,預設 1):有多少個先前的值延續到當前值。 |
Difference order (d) | 非季節性差分的次數(0 至 3,預設 0)。對於趨勢漂移或增長的序列,取 1。 |
Moving average order (q) | 非季節性 MA 項的個數(0 至 10,預設 0):有多少個先前的隨機衝擊延續下來。 |
Include seasonal terms | 勾選以新增下面的季節階數。模型合計至少需要一個 AR 或 MA 項。 |
Seasonal AR order (P) / Seasonal difference order (D) / Seasonal MA order (Q) | 季節階數(P 和 Q 為 0 至 5,D 為 0 至 2)。對於 s = 12 的月度資料,D = 1 對應同比變化的建模。 |
Seasonal period (s) | 含季節項時必填:一個季節內的觀測數(具有年週期的月度資料為 12,季度資料為 4,具有周週期的每日資料為 7)。 |
Include constant term | 預設勾選。對於無漂移的已差分序列,請取消勾選。 |
Number of forecasts | 預測起點之後要預測的期數(0 至 1000;0 = 不預測)。 |
Confidence level (%) for forecast interval | 預設 95。 |
Forecast origin (row) | 可選。預測從該列之後開始,使用截至該列的資料;留空 = 序列末尾。可用它對照已有的資料驗證模型。 |
Results to display | 最終估計值、差分資訊、殘差平方和、觀測數;或者另外加上每次迭代的估計值、估計參數的相關矩陣或反向預測值。 |
Residual plots (four in one) | 新增常態機率圖、殘差與配適值圖、直方圖以及殘差與順序圖。 |
Title | 輸出中顯示的標題。 |
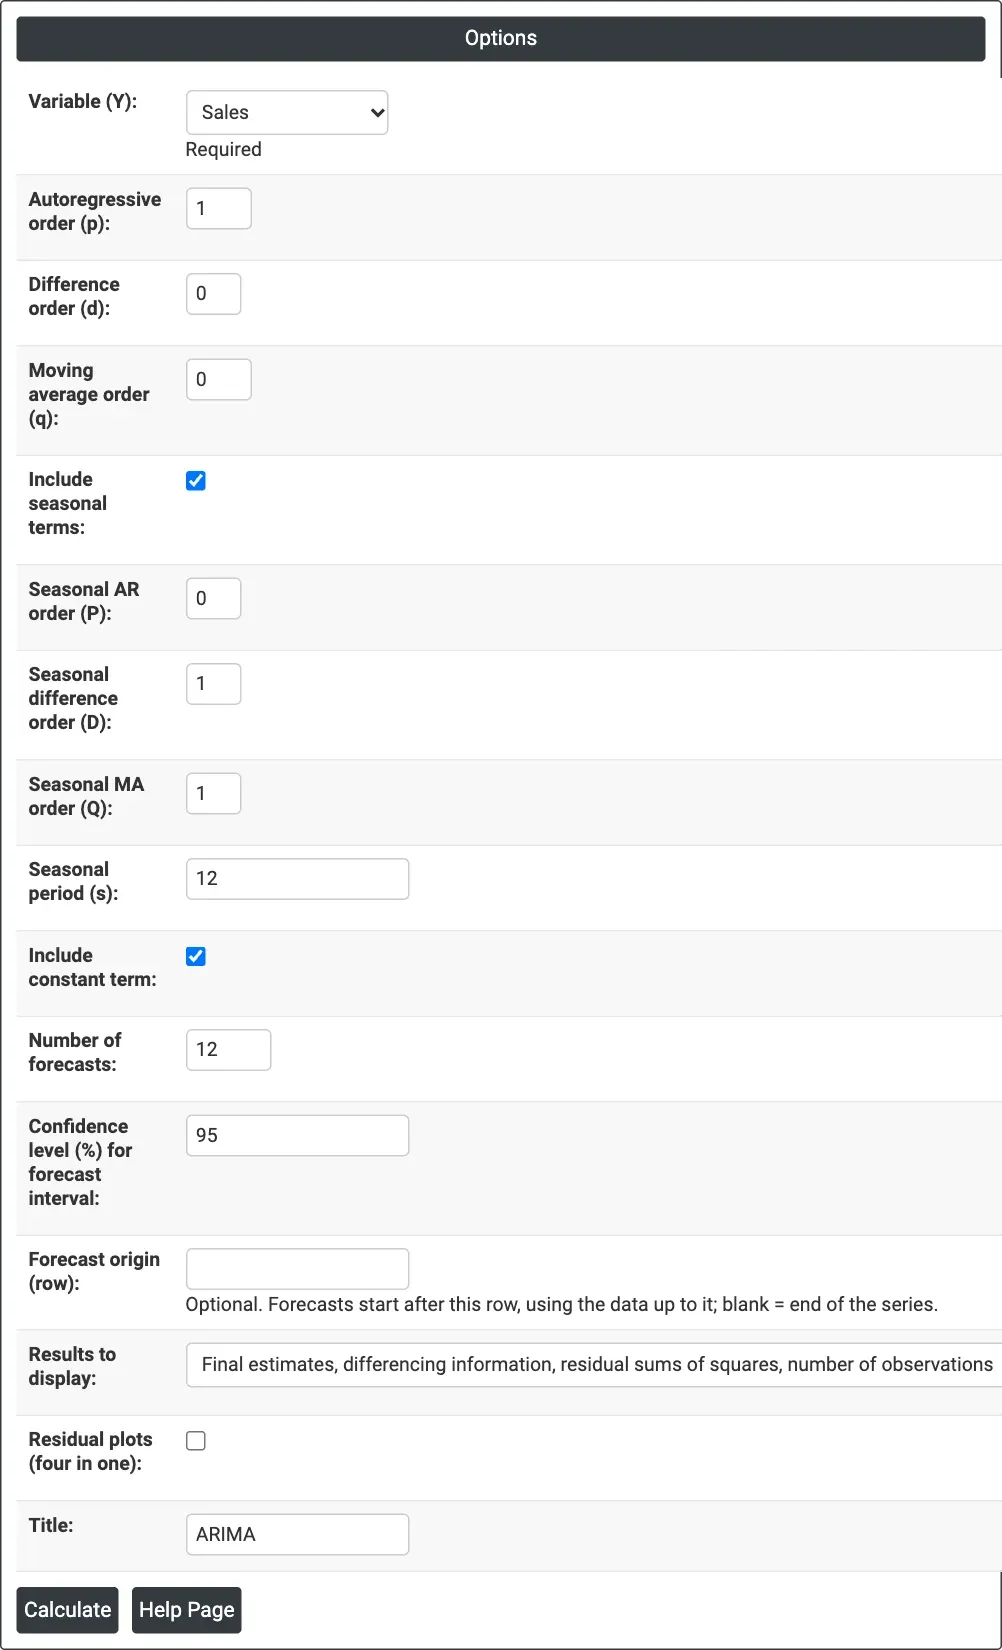
圖 1 — 月度銷售額範例:Variable (Y) = Sales,含常數項和 12 個預測值的季節性 ARIMA(1, 0, 0)(0, 1, 1)12 模型。
輸出說明
- ARIMA plot — 序列及其配適值、預測值和預測區間帶;MAPE、MAD 和 MSD 顯示在標題下方。
- Final Estimates of Parameters — 每個 AR、SAR、MA 和 SMA 項及常數項,附 coefficient、SE Coef、T-Value 和 P-Value(含常數項的未差分模型還有 Mean)。
- Residual Sums of Squares — 殘差的 DF、SS 和 MS。
- Modified Box-Pierce (Ljung-Box) Chi-Square statistic — 落後 12、24、36 和 48 處的 Chi-Square、DF 和 P-Value(超過序列長度的落後期不予列出)。
- Forecasts — 期數、預測值,以及預測下限和上限。
- ACF and PACF of Residuals — 虛線界限之內的條形表示不再存在自我相關。
- 在 Results to display 和 Residual plots 中選擇的可選表格和圖形,以及透過 Download 匯出 PDF。
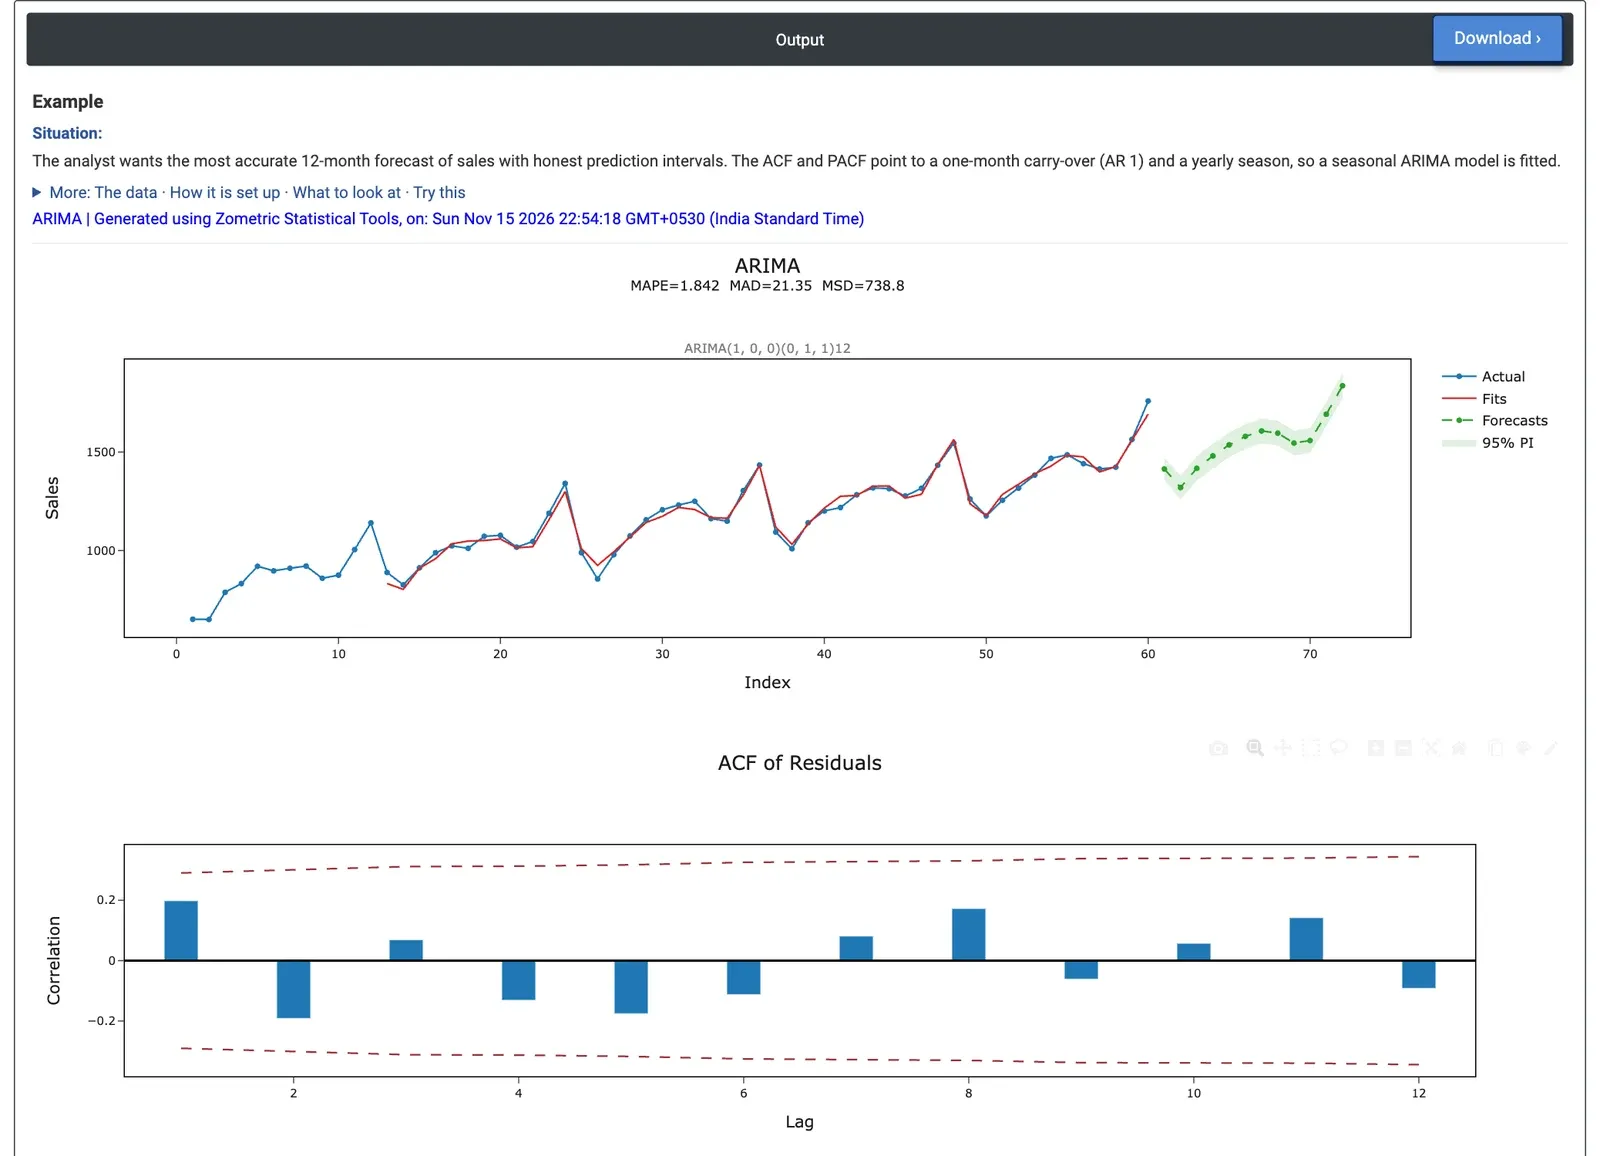
圖 2 — 月度銷售額範例的 ARIMA 輸出:配適值和 12 個月預測及其 95% 預測區間帶,以及殘差的 ACF。
計算範例
某分析人員有 60 個月的銷售額資料(2020 年 1 月至 2024 年 12 月),希望得到帶可靠預測區間的 12 個月預測。ACF 和 PACF 顯示存在一個月的延續效應和年度季節性,因此模型取含常數項的 ARIMA(1, 0, 0)(0, 1, 1)12:Autoregressive order (p) = 1,Seasonal difference order (D) = 1,Seasonal MA order (Q) = 1,Seasonal period (s) = 12,Number of forecasts = 12。
兩項都明顯必要:AR 1 = 0.481(SE 0.104,T = 4.63,p < 0.001)和 SMA 12 = 0.805(SE 0.144,T = 5.59,p < 0.001),常數為 69.34(平均同比增長)。殘差 MS 為 788.1,DF 為 45(60 個月 − 季節差分損失的 12 個 − 3 個參數)。落後 12、24 和 36 處的 Ljung-Box p 值分別為 0.214、0.319 和 0.254,均大於 0.05,因此殘差看起來像隨機雜訊,模型已捕捉到該規律。配適很接近:MAPE 1.84%,MAD 21.35,MSD 738.8。
2025 年 1 月(第 61 期)的預測值為 1,414 個單位,95% 預測區間為 1,359 至 1,469,到 2025 年 12 月(第 72 期)升至 1,837,區間為 1,774 至 1,899。為在採信模型之前對其進行驗證,可設定 Forecast origin (row) = 48,用截至 2023 年 12 月的資料預測 2024 年,並將預測值與 2024 年的實際銷售額比較。
常見問題
什麼是 ARIMA 模型?
ARIMA 是針對等時間間隔測得的序列的 Box-Jenkins 自迴歸積分移動平均模型。自迴歸項延續先前的值,差分去除趨勢,移動平均項延續先前的隨機衝擊。對於重複出現的季節性,可新增季節項,例如具有年度規律的月度資料取週期 12。
什麼情況下應使用 ARIMA 而不是指數平滑?
當每個值都依賴於其之前的值,或序列存在趨勢或重複的季節性,而移動平均或指數平滑等較簡單的方法又不能很好地捕捉時,使用 ARIMA。配適之前,序列的自我相關(ACF)圖和偏自我相關(PACF)圖有助於選擇模型階數。
如何檢查 ARIMA 模型配適得是否良好?
檢查每一項的 p 值是否表明它是必要的,並檢視落後 12、24、36 和 48 處的 Ljung-Box 卡方檢定:p 值大於 0.05 表示沒有證據表明殘差中仍存在自我相關。殘差的 ACF 和 PACF 條形應保持在虛線界限之內。MAPE、MAD 和 MSD 概括配適精度。
如何在採信 ARIMA 預測之前對其進行驗證?
將預測起點設在較早的列,使模型根據截至該點的資料進行預測,然後將這些預測值與實際發生的情況比較。在計算範例中,把起點設為第 48 列,即用截至 2023 年 12 月的資料預測 2024 年,以便與 2024 年的實際銷售額比較。預測區間隨預測期的延長而變寬。