
增強 Dickey-Fuller 檢定(ADF 檢定)
增強 Dickey-Fuller 檢定以定態序列為對立假設,檢定時間序列是否存在單位根(非定態)。在使用 ARIMA 或其他假定定態性的模型之前應先做此檢定。可選擇常數項、常數項加趨勢、二次趨勢或不含任何項,並按 AIC、BIC、t-stat 或固定值選擇落後期。序列不得有遺漏,且至少有 6 個值。輸出包括檢定統計量、p 值、落後期數和臨界值。
最後審閱
核心要點
增強 Dickey-Fuller(ADF)檢定用於判斷時間序列是定態的還是存在單位根,幫助在 ARIMA 建模之前決定是直接對原始資料建模、對趨勢建模,還是先對序列做差分。
用途
增強 Dickey-Fuller(ADF)檢定用於判斷時間序列是否定態,即序列是圍繞固定平均值(或固定趨勢)波動,還是遊走而不迴歸。許多預測模型,尤其是 ARIMA,都假定序列是定態的。在配適此類模型之前先執行該檢定,以決定是直接對原始資料建模、對趨勢建模,還是先對序列做差分。
主要功能
- 以定態序列為對立假設,檢定存在單位根(非定態序列)這一虛無假設。
- 檢定迴歸有四種形式:圍繞常數項、常數項加線性趨勢、常數項加線性與二次趨勢,或兩者都不含。
- 可按 AIC、BIC 或最後一個落後項的 t 統計量自動選擇落後差分的個數,也可使用您輸入的固定個數。
- 報告檢定統計量、p 值、所用落後期數以及 1%、5% 和 10% 的臨界值,並按您設定的顯著水準給出通俗易懂的結論。
統計方法
該檢定配適迴歸 Δyₜ = α + βt + γ·yₜ₋₁ + δ₁Δyₜ₋₁ + … + δₖΔyₜ₋ₖ + εₜ,其中 Δyₜ = yₜ − yₜ₋₁。常數項 α 和趨勢項 βt 是否納入,取決於 Regression type(二次選項會增加 t² 項)。檢定統計量是 γ 的 t 比值。若序列存在單位根,則 γ = 0;統計量為較大的負值,表示序列被拉回其平均值或趨勢,因而是定態的。該統計量不服從通常的 t 分配:p 值採用 MacKinnon 近似分配計算,臨界值取自 MacKinnon 表,兩者均針對所選的迴歸類型。
落後差分 Δyₜ₋ᵢ 用於吸收短期自我相關。Maximum lag 預設為 min(n/2 − 3, 12·(n/100)^¼),向下取整。使用 AIC 或 BIC 時,工具配適從 0 到最大值的每一個落後期,並保留準則值最低的一個;使用 t-stat 時,從最大落後期開始逐個剔除落後期,直到最後一個落後期滿足 |t| ≥ 1.645;使用 Fixed 時,則恰好採用最大落後期。N Observations 是迴歸中剩餘的列數:n − 所用落後期數 − 1。計算使用 statsmodels 的 adfuller。序列不得有遺漏,且至少有 6 個值。
若 p 值低於顯著水準,則拒絕存在單位根的虛無假設,序列視為定態;否則序列很可能是非定態的,需要做差分(或加入趨勢項)。顯著水準只會改變這句結論;臨界值始終按 1%、5% 和 10% 顯示。
輸入欄位和選項
欄位 | 說明 |
Variable | 必填。存放序列的數值欄,按時間順序排列。 |
Regression type | Constant(檢定圍繞平均值的定態性),為預設值;Constant and trend(檢定圍繞趨勢的定態性);Constant, linear, and quadratic trend;或 None(不含常數項和趨勢)。 |
Lag selection method | AIC(使 Akaike 資訊準則最小),為預設值;BIC(使 Bayesian 資訊準則最小);t-stat(當最後一個落後項的 t 統計量不顯著時剔除該落後期);或 Fixed(恰好使用 Maximum lag)。 |
Maximum lag | 可選。AIC、BIC 和 t-stat 搜尋的上限,或 Fixed 時恰好使用的落後期數。留空則使用 min(n/2 − 3, 12·(n/100)^¼)。 |
Significance level | 預設值為 0.05(0.001 至 0.5)。將 p 值與其比較以得出結論。 |
Title | 輸出中顯示的標題。 |
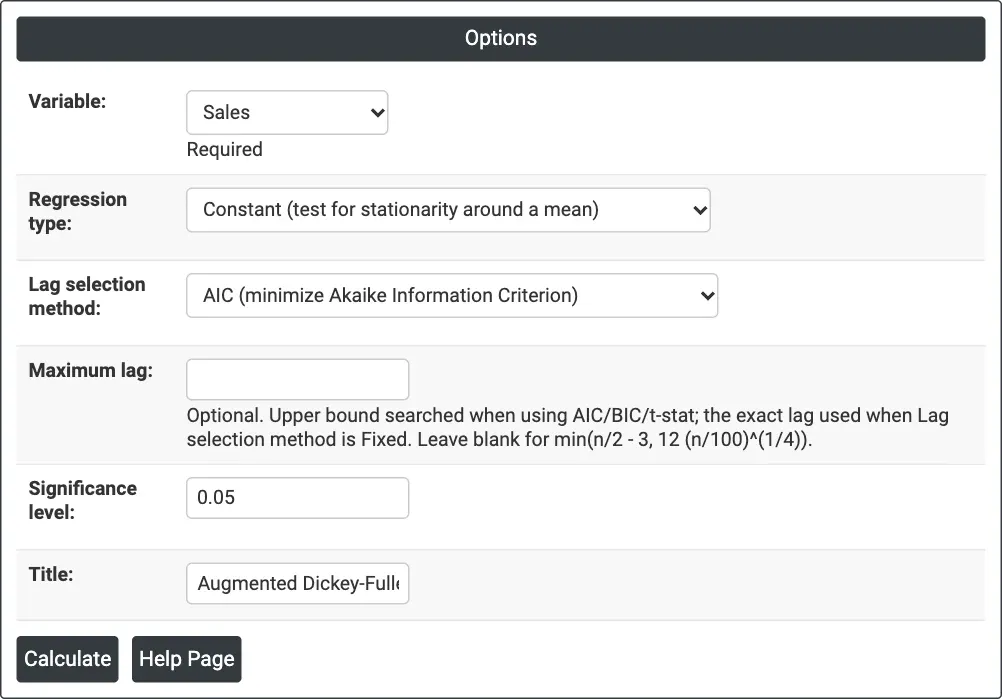
圖 1 — 僅含常數項、按 AIC 選擇落後期、顯著水準為 0.05 時對月度 Sales 的檢定。
輸出說明
- Test — 變數、檢定統計量、p 值、所用落後差分個數、搜尋的最大落後期以及檢定迴歸中的觀測數。
- Critical Values — 所選迴歸類型下檢定統計量在 1%、5% 和 10% 水準的臨界值。若統計量低於(比其更負)某一水準的臨界值,則序列在該水準下是定態的。
- Conclusion — 一句話結論,將 p 值與顯著水準比較,並說明序列很可能是定態還是非定態。
- 可透過 Download 匯出 PDF。
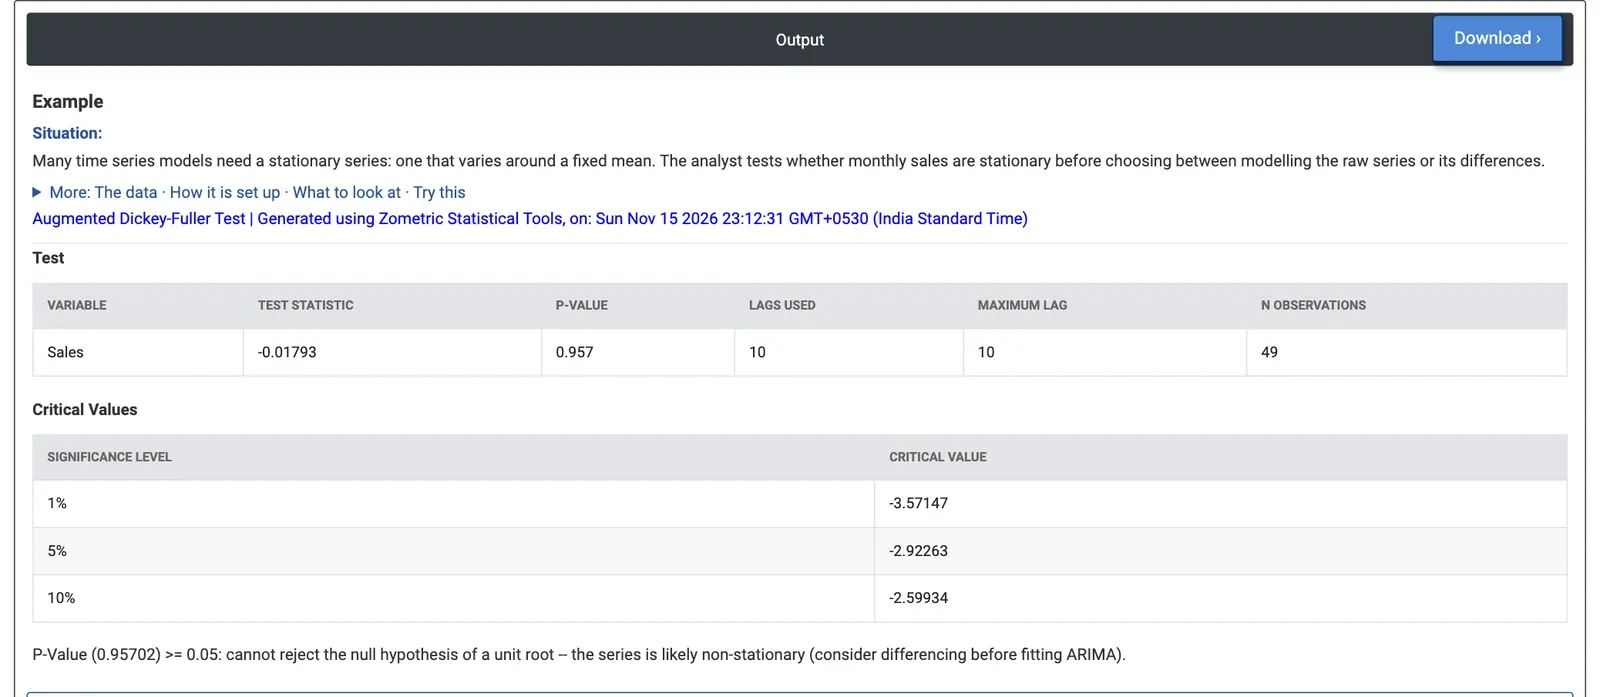
圖 2 — 圍繞固定平均值檢定月度銷量:統計量為 −0.018,p 值為 0.957,因此序列不定態。
計算範例
一家消費電子經銷商的銷售分析師擁有 60 個月的銷量資料(2020 年 1 月至 2024 年 12 月),並計畫做 ARIMA 預測。分析師首先檢定銷量是否定態。分析師選擇 Variable = Sales,並保持 Regression type = Constant、Lag selection method = AIC 和 Significance level = 0.05。
搜尋的最大落後期為 10,AIC 保留全部 10 個,檢定迴歸中剩餘 49 個觀測。檢定統計量為 −0.018,p 值為 0.957;5% 臨界值為 −2.92,統計量與之相去甚遠。無法拒絕存在單位根的虛無假設:銷量並非圍繞固定平均值波動,這與資料圖一致,圖中銷量逐年增長。
當 Regression type = Constant and trend 時,統計量變為 −7.78,對應 5% 臨界值 −3.50(p 值低於 0.001),使用 9 個落後期。圍繞一條直線趨勢,序列是定態的,因此增長是穩定的。對模型而言,這意味著要麼加入趨勢項,要麼做差分;如 ARIMA 頁面所示,採用 12 個月差分並含常數項的季節性 ARIMA,既能處理增長,也能處理年度週期模式。對 Advertising Spend 使用常數項進行檢定,結果相同(統計量 0.13,p 值 0.968)。
常見問題
增強 Dickey-Fuller 檢定能說明什麼?
ADF 檢定用於說明時間序列是否定態,即序列是圍繞固定平均值或趨勢波動,還是因存在單位根而遊走不迴歸。虛無假設為存在單位根。許多預測模型,尤其是 ARIMA,都假定序列是定態的,因此該檢定可指導是否對資料做差分或對趨勢建模。
如何解讀 ADF 檢定的 p 值?
若 p 值低於顯著水準,則拒絕存在單位根的虛無假設,序列視為定態。否則序列很可能是非定態的,需要做差分或加入趨勢項。等價地,若檢定統計量低於(即比其更負)某一水準的臨界值,則序列在該水準下是定態的。
ADF 檢定應選擇哪種迴歸類型?
選擇 Constant 可檢定圍繞固定平均值的定態性,選擇 Constant and trend 可檢定圍繞直線趨勢的定態性,另有二次趨勢選項,或選擇 None 表示不含常數項和趨勢。在銷量範例中,序列圍繞平均值並不定態(p = 0.957),但圍繞趨勢是定態的(統計量 -7.78,p 值低於 0.001)。
ADF 檢定如何選擇落後期數?
落後差分用於吸收短期自我相關。使用 AIC 或 BIC 時,配適從 0 到最大值的每一個落後期,並保留準則值最低的一個;使用 t-stat 時,逐個剔除落後期,直到最後一個落後期的 |t| 至少為 1.645;使用 Fixed 時,恰好採用最大落後期。預設最大值為 min(n/2 - 3, 12 x (n/100)^0.25)。