
自動製程能力分析
自動製程能力分析省去了手動常態性檢查。它執行 Anderson-Darling 檢定:p 值達到或高於閾值(預設 0.1)時,計算常態 Pp、Ppl、Ppu 和 Ppk;低於閾值時,透過最大概似法配適候選非常態分配,選出配適最佳者並採用 z 分數法。輸出顯示所走路徑、配適直方圖、各項指數以及期望和觀測 PPM。
最後審閱
核心要點
自動製程能力分析使用 Anderson-Darling 檢定常態性,並根據常態模型或配適最佳的非常態分配自動計算 Pp 和 Ppk,同時記錄所走的路徑。
用途
自動製程能力分析省去了先手動檢定常態性、再另行選擇常態或非常態能力模型的步驟。該工具自行執行 Anderson-Darling 常態性檢定:資料透過檢定時,自動將計算轉入標準常態能力指數;未通過時,則轉入最佳配適的非常態分配(從應用的候選分配庫中選取)——最終產生一份報告,並在頂部記錄路徑判定結果。
主要功能
- 自動執行 Anderson-Darling 常態性檢定——無需單獨的常態性檢查步驟。
- 當常態假設被拒絕時,自動選擇配適最佳的非常態候選分配,所用分配配適庫與應用中其他非常態能力工具相同。
- 可配置常態性 p 值閾值,使用者可據此調整工具預設走常態路徑的保守程度。
- 在輸出中直接報告所走路徑(常態還是非常態,以及採用哪種分配),使路徑判定過程透明、可稽核。
- 支援可選的 Factor 欄以及「Compare selected columns as separate groups」模式,與應用中其他能力工具保持一致。
統計方法
常態性採用 Anderson-Darling 檢定評估(以 scipy 的 anderson() 對照常態參考分配),使用標準小樣本修正 AD = A²·(1 + 0.75/n + 2.25/n²),p 值由修正後 AD 統計量的 D'Agostino–Stephens 分段經驗近似公式匯出。
路徑判定規則:若 Anderson-Darling 的 p 值大於或等於常態性 p 值閾值(預設 0.1),則視資料為常態——工具透過移動全距法(MRbar/d2,或中位數移動全距變體)估計 σ_overall,並據此計算基於 z 的標準效能指數 Pp、Ppl、Ppu、Ppk。若 p 值低於閾值,則工具改為通過最大概似法配適應用支援的每一種候選非常態分配(Weibull、3-Parameter Weibull、Exponential、2-Parameter Exponential、Gamma、Logistic、Loglogistic、Lognormal,以及 Smallest/Largest Extreme Value 分配),按適合度排序,並自動選出配適最佳者。
在非常態路徑下,計算所選分配自身的 CDF 在 LSL 和 USL 處的取值,得到尾部機率 p_lsl 和 p_usl,再透過常態分配反函數(norm.ppf)將其轉換為等效的標準常態 z 分數——即「z 分數法」。隨後利用這些 z 分數,在熟悉的 Cpk 尺度上報告能力:Pp = (z_usl − z_lsl) / 6,PPL = −norm.ppf(p_lsl) / 3,PPU = norm.ppf(p_usl) / 3,Ppk = min(PPL, PPU)——這樣,偏態分配的真實尾部風險先被捕獲,再以應用中通用的類 Cpk 單位表達,而不是把原始常態 Z 分數誤用於非常態資料。
PPM(百萬分之幾)數值有兩種報告方式:「期望」PPM 來自配適分配在各規格界限之外的尾部機率,「觀測」PPM 則直接統計原始樣本中實際落在規格界限之外的比例。
輸入欄位和選項
欄位 | 說明 |
Choose columns | 待分析的反應欄。 |
Factor | 可選。當資料為單一 Response 欄加一個 Factor 欄時,用於比較各組的能力。 |
Compare selected columns as separate groups | 選擇 2 欄或更多欄時,對每欄分別執行能力分析並並排比較。 |
LSL / USL | 規格下限和規格上限,應用於每個所選欄。 |
Normality p-value threshold | 預設 0.1。若 Anderson-Darling 的 p 值達到或高於此值,則假定常態來計算能力;低於此值,則自動選擇並改用配適最佳的非常態分配。 |
Download as Excel | 可選。將報告匯出為 Excel 工作簿。 |
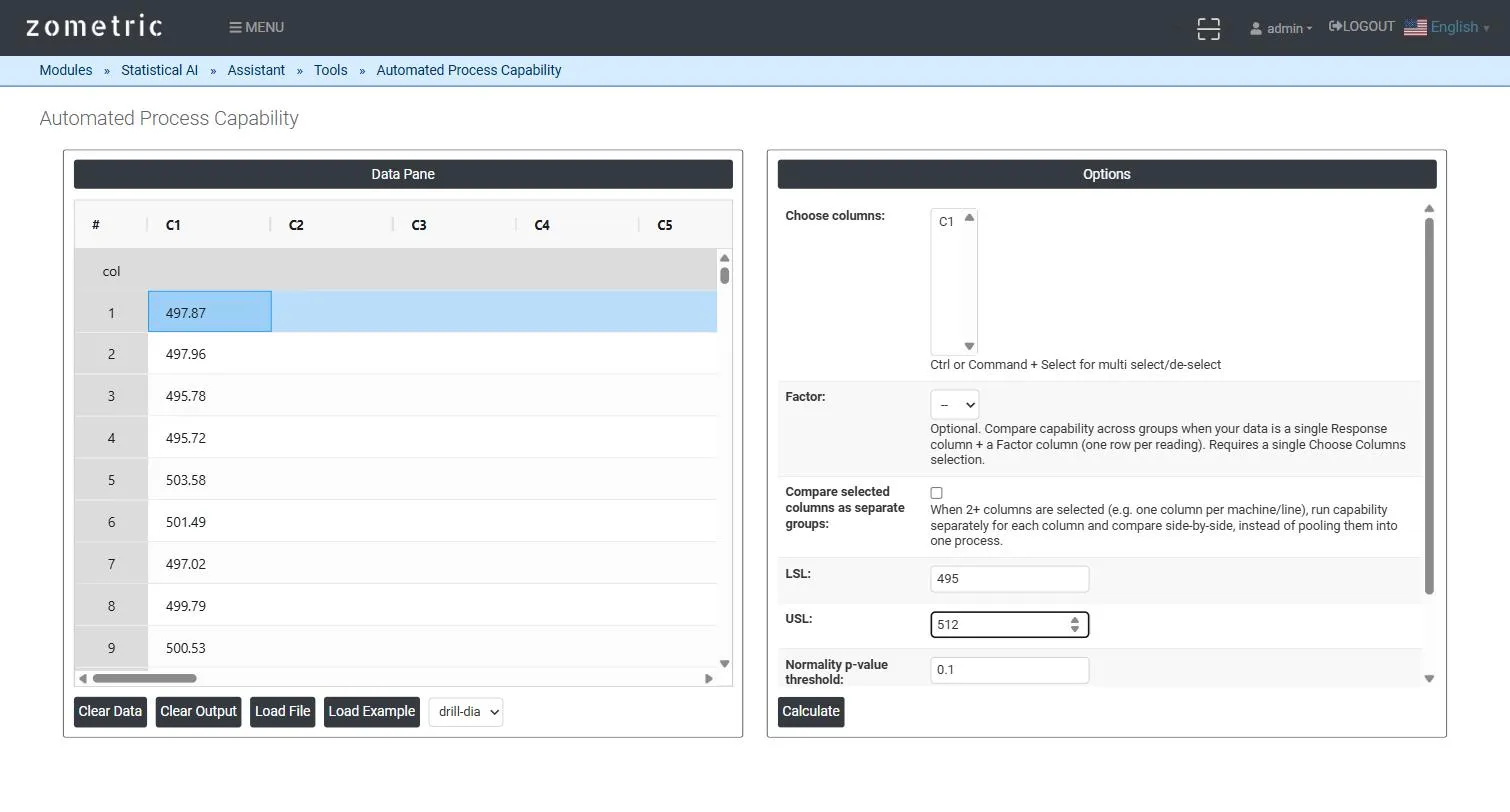
圖 1 — Data pane 中貼上到 C1 的 60 個充填重量讀數,以及 Options 面板中已填寫的 LSL/USL 和 Normality p-value threshold。
輸出說明
- 常態性檢定結果——Anderson-Darling 統計量和 p 值,以及所走路徑(常態,或自動選出的具體非常態分配)。
- 配適分配的直方圖——樣本直方圖,疊加配適密度曲線以及 LSL/USL 參考線。
- 分配參數表——LSL、USL、樣本平均值、樣本數,以及配適分配的形狀/尺度(或等效)參數。
- 能力指數——根據所選分配計算的 Pp、Ppl、Ppu、Ppk。
- PPM 表——期望 PPM(來自配適分配的尾部)和觀測 PPM(來自原始樣本),各自分為 PPM < LSL、PPM > USL 和 PPM Total。
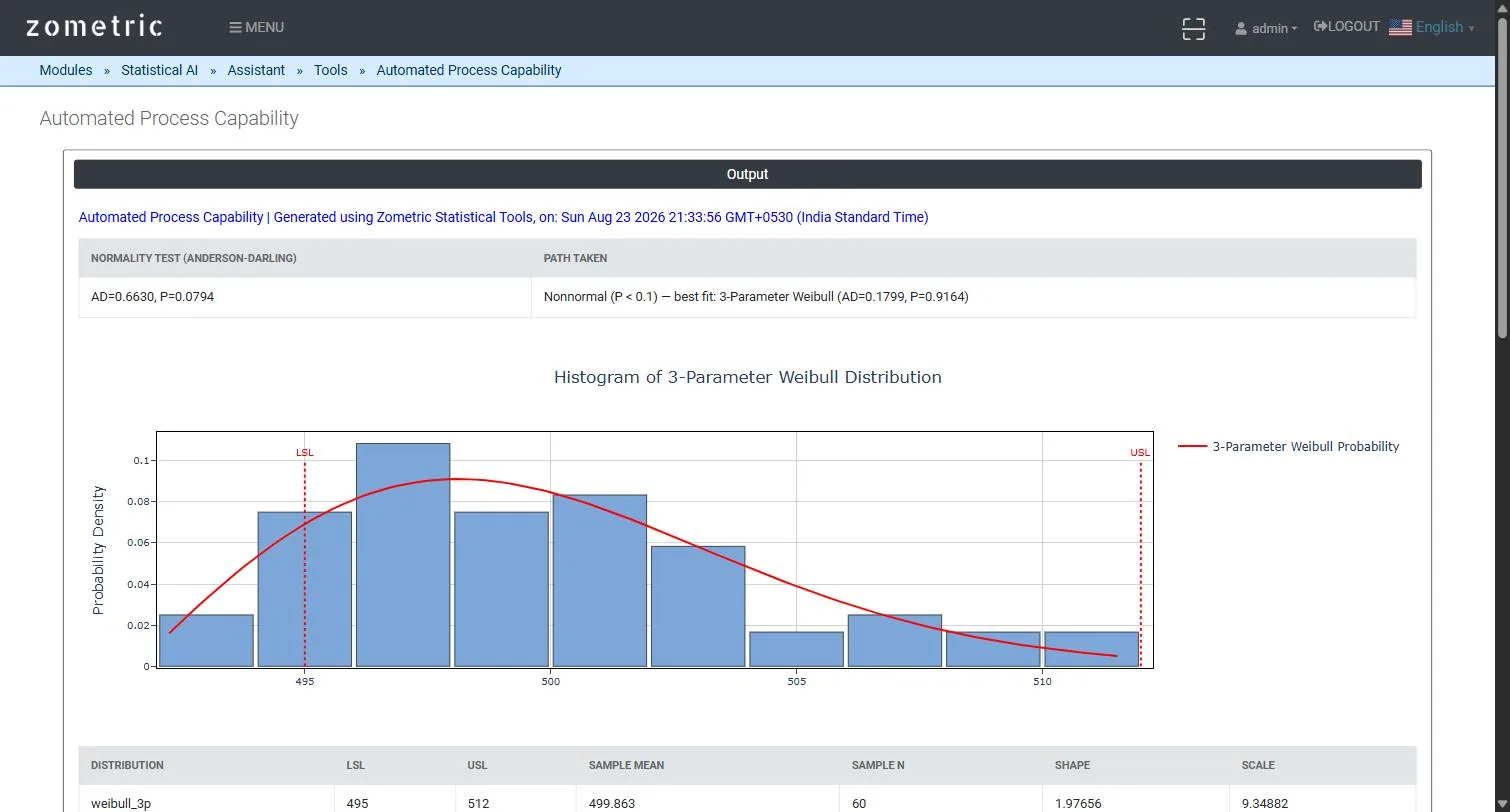
圖 2 — 分配參數及由此得到的 Pp/Ppl/Ppu/Ppk 指數,以及期望和觀測 PPM 表。
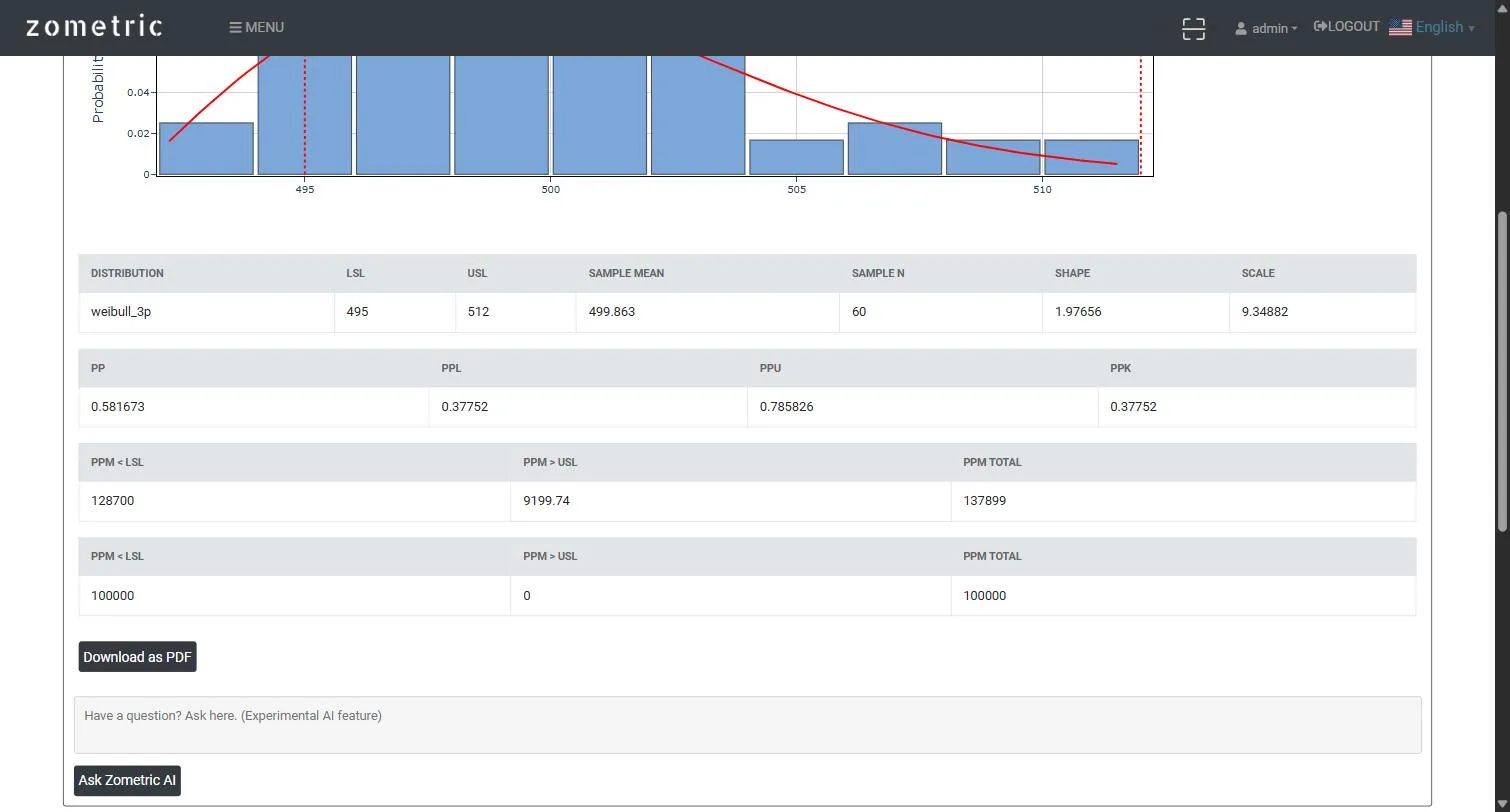
圖 3 — 自動路徑判定(Anderson-Darling 結果和所走路徑)及配適分配直方圖。
計算範例
一條充填線充填黏稠的清潔液;在一個班次內抽取 60 瓶量測充填重量(g)(C1 欄),LSL = 495 g,USL = 512 g。在預設閾值 0.1 下,Anderson-Darling 檢定得到 AD = 0.6630,P = 0.0794——低於閾值——因此工具自動轉入非常態路徑,選擇 3-Parameter Weibull 配適(AD = 0.1799,P = 0.9164)作為配適最佳的分配,並根據配適 Weibull 的尾部機率報告 Ppk = 0.378,而不是依據(具有誤導性的)常態分配假設。
常見問題
自動製程能力分析有什麼作用?
它對資料執行 Anderson-Darling 常態性檢定,然後自動轉入相應的能力計算:資料透過檢定時採用標準常態能力指數,未通過時採用配適最佳的非常態分配。一份報告即顯示常態性結果、所走路徑和所用分配,使路徑判定過程透明、可稽核。
該工具如何在常態與非常態能力之間做出選擇?
若 Anderson-Darling 的 p 值大於或等於常態性 p 值閾值(預設 0.1),則視資料為常態。若低於閾值,工具透過最大概似法配適 Weibull、3-Parameter Weibull、Gamma、Lognormal 等候選分配,按適合度排序並選出最佳者。
非常態資料的 Ppk 如何計算?
由所選分配的 CDF 得到 LSL 和 USL 之外的尾部機率,再轉換為等效的標準常態 z 分數。然後 PPL = -z(p_lsl)/3,PPU = z(p_usl)/3,Ppk = min(PPL, PPU)。這樣既能反映偏態分配的真實尾部風險,又使結果保持在熟悉的類 Cpk 尺度上。
如何在 Zometric Statistical Software 中執行自動製程能力分析?
貼上資料,選擇反應欄,可選擇 Factor 或將各欄作為獨立組比較的選項,並輸入 LSL 和 USL。設定 Normality p-value threshold(預設 0.1)。報告會顯示路徑判定結果、配適直方圖、分配參數、能力指數和 PPM 表,並可匯出到 Excel。