
最佳子集迴歸
最佳子集迴歸對所有自由預測變數的每個子集配適普通最小平方模型,可選擇將部分變數強制納入所有模型,並顯示每種規模下最佳的 1 至 5 個模型。每列報告 R-Sq、R-Sq(adj)、R-Sq(pred)、Mallows' Cp 和 S,還可選擇顯示 PRESS、AICc、BIC 和 VIF。可在研究早期用於篩選預測變數,再用 Fit Regression Model 配適所選模型。
最後審閱
核心要點
最佳子集迴歸對候選預測變數的每種組合配適線性迴歸,並列出各規模下的最佳模型,幫助找出能解釋大部分反應變異的最小預測變數集。
用途
最佳子集迴歸對候選預測變數的每種組合配適線性迴歸,並將各規模下的最佳模型並排列出。在研究早期,當有多個可能的製程設定、希望找出能解釋大部分反應變異的最小設定集時使用,之後再用 Fit Regression Model 對所選模型進行詳細配適。
主要功能
- 配適自由預測變數的所有子集,數量從設定的最小值到最大值。
- 顯示每種規模下最佳的 1 至 5 個模型,按 R-Sq 排序。
- 報告每個模型的 R-Sq、R-Sq(adj)、R-Sq(pred)、Mallows' Cp 和 S,可按需顯示 PRESS、AICc 和 BIC。
- Predictors in all models:將已知重要的變數強制納入每個子集。
- 增強表格會增加每個模型中各預測變數的變異數膨脹因子(VIF),用於發現相關的預測變數。
- 可配適帶或不帶截距的模型。
統計方法
反應或任一所選預測變數中含遺漏值或非數值的列將被剔除。對於從最小到最大的每種子集規模,工具對該數量的自由預測變數(加上任何強制預測變數)的每種組合配適普通最小平方模型,按 R-Sq 排序,並保留每種規模下的最佳模型。若有 p 個自由預測變數,則共有 2ᵖ − 1 個子集,因此每增加一個候選變數,配適次數就翻一番。
對於由 n 列資料配適、含 k 個係數(包括常數項)的模型:S = √MSE;R-Sq(adj) 針對模型項數對 R-Sq 進行校正;PRESS = Σ (eᵢ / (1 − hᵢ))²,即利用槓桿值 hᵢ 得到的留一法預測誤差平方和;R-Sq(pred) = 1 − PRESS / SS Total。Mallows' Cp = SSE / MSE(full) − (n − 2k),其中 MSE(full) 是含所有預測變數的模型的誤差均方;偏誤很小的模型,其 Cp 接近 k,全模型的 Cp 恆等於 k。AICc = −2 log L + 2(k+1) + 2(k+1)(k+2)/(n − k − 2),BIC = −2 log L + (k+1) ln n,均將 σ 計為一個參數;PRESS、AICc 和 BIC 越小越好。
應尋找這樣的模型:R-Sq(adj) 和 R-Sq(pred) 不再上升,Cp 接近係數個數,且 S 較小。R-Sq 與 R-Sq(pred) 之間差距較大,提示存在過配適。最佳子集迴歸只比較配適效果:請在 Fit Regression Model 中檢查所選模型的殘差和係數。
輸入欄位和選項
欄位 | 說明 |
Response (Y) | 待解釋的數值欄。必填。 |
Free predictors | 數值型候選預測變數,將嘗試其每種組合。必填。按住 Ctrl 或 Command 並點選可選擇多個。 |
Predictors in all models (optional) | 納入每個模型的數值型預測變數。它們不能同時作為自由預測變數。 |
Models of each size to display | 列出每種規模下最佳模型的數量,1 至 5。預設值為 2。 |
Display PRESS / Display AICc / Display BIC | 將這些欄新增到表格中。預設關閉。 |
Free Predictors: Minimum / Maximum | 模型中自由預測變數的最小和最大數量。預設從 1 到全部。 |
Fit intercept | 預設勾選。取消勾選則配適過原點的模型(此時 R-Sq 為未中心化)。 |
Display of results | Simple tables(預設)或 Enhanced tables,後者為每個預測變數增加一欄 VIF。 |
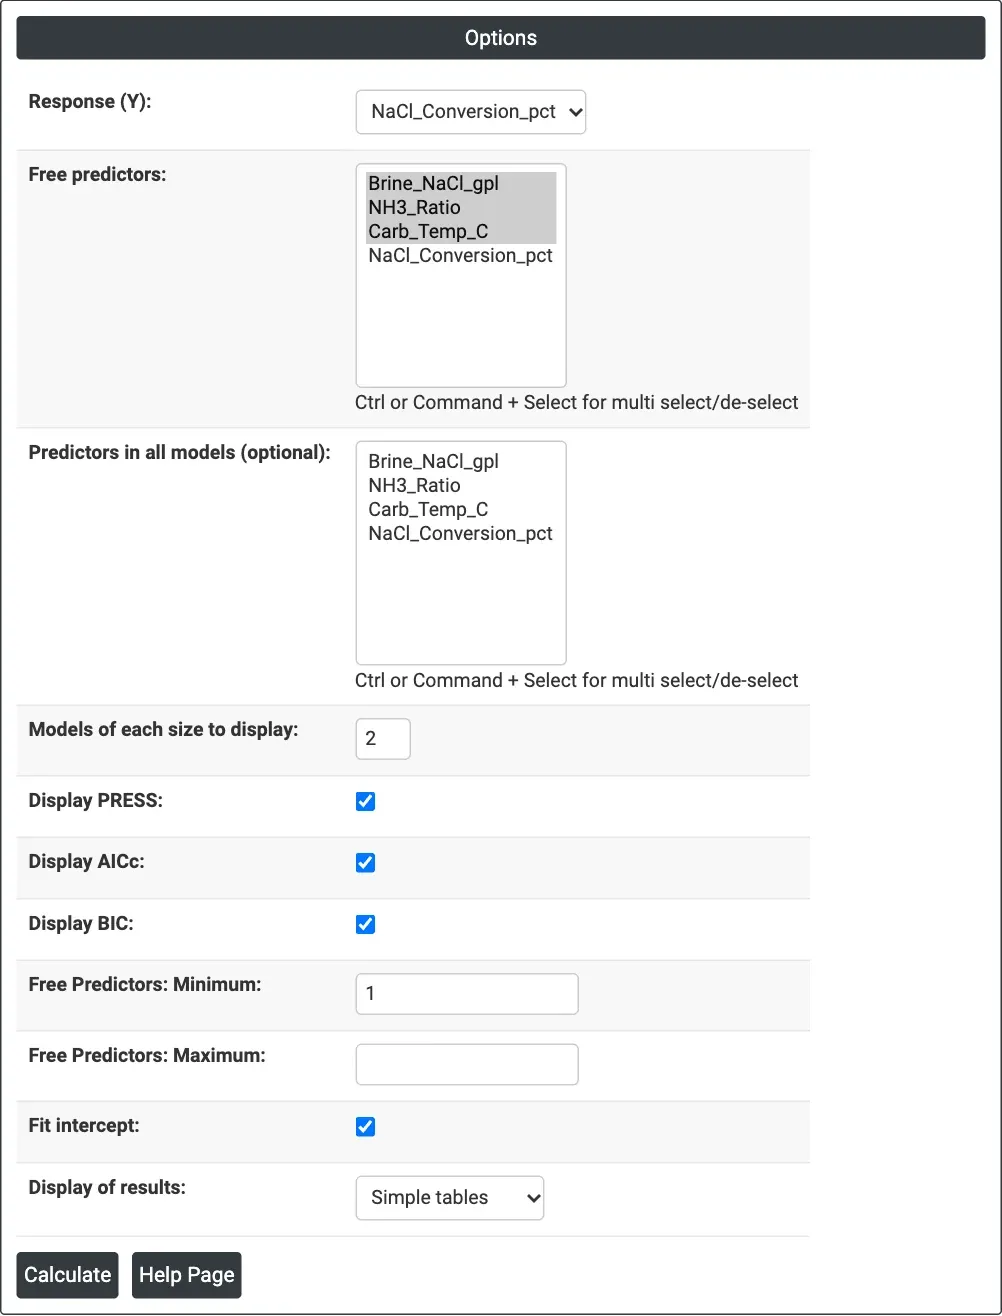
圖 1 — 純鹼範例的選項:以 NaCl_Conversion_pct 為反應,三個製程設定為自由預測變數,並顯示 PRESS、AICc 和 BIC。
輸出說明
- 反應列 — 給出反應名稱以及強制納入所有模型的預測變數。
- 最佳子集結果表 — 每個模型一列:Vars(自由預測變數個數)、R-Sq、R-Sq(adj)、R-Sq(pred)、Mallows' Cp、S,可選的 PRESS、AICc 和 BIC,以及模型中每個預測變數下方的 X;使用增強表格時,還有模型中各預測變數的 VIF。
- 透過 Download 匯出 PDF。
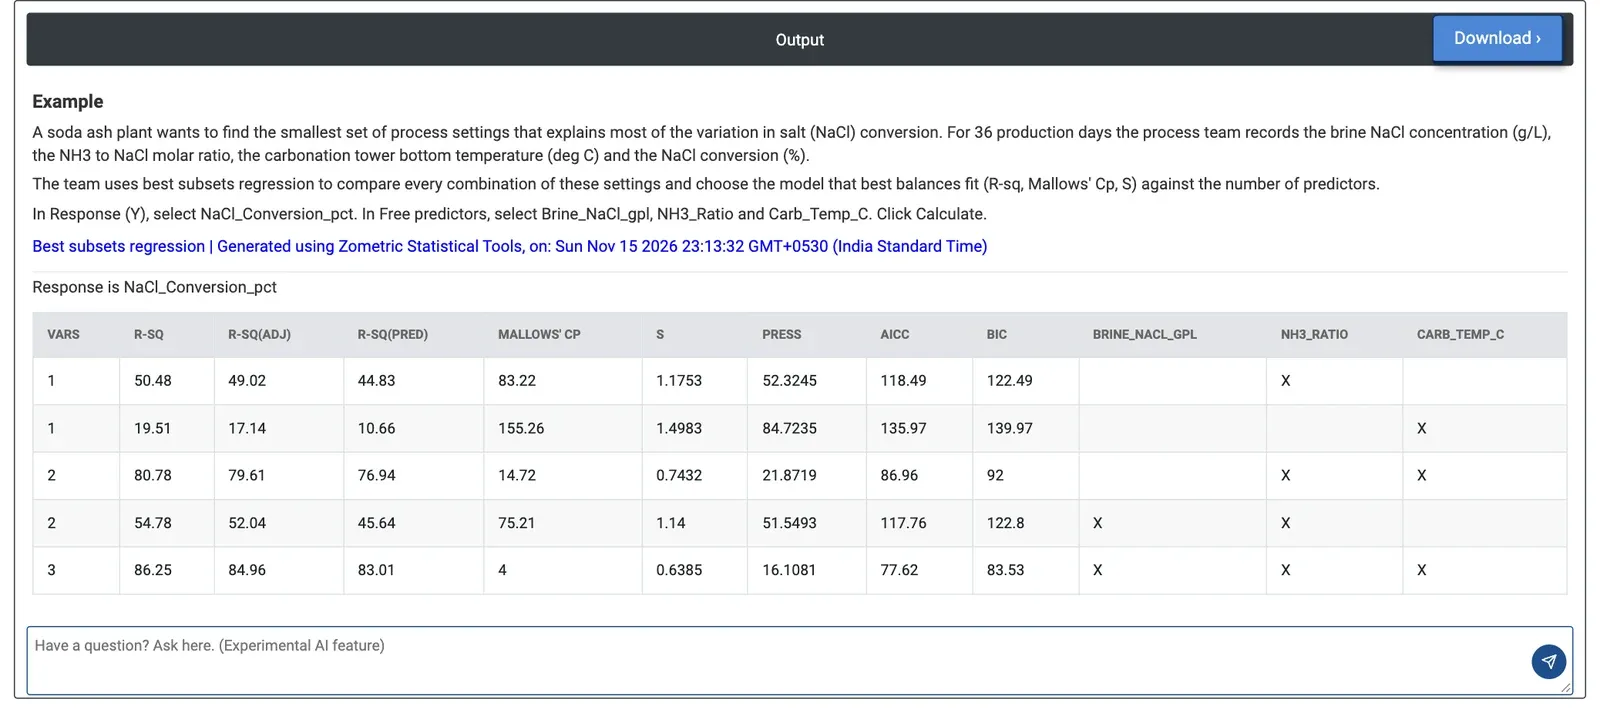
圖 2 — NaCl 轉化率的最佳子集結果:三預測變數模型的 R-Sq 為 86.25%,R-Sq(pred) 為 83.01%,Cp 為 4,S 為 0.6385。
計算範例
一家純鹼廠想了解哪些製程設定可以解釋每日 NaCl 轉化率(%)。在 36 個生產日內,團隊記錄了鹽水 NaCl 濃度(Brine_NaCl_gpl)、NH3 與 NaCl 的摩爾比(NH3_Ratio)以及碳化塔底部溫度(Carb_Temp_C)。他們選擇 NaCl_Conversion_pct 作為反應,三個設定作為自由預測變數,每種規模保留兩個模型,並勾選 Display PRESS、AICc 和 BIC。
單獨來看,NH3 比值是最好的單一預測變數,但它僅解釋了 50.48% 的變異(Cp 為 83.22)。加入碳化溫度後,R-Sq 升至 80.78%,S 從 1.1753 降至 0.7432 個百分點,但 Cp 仍為 14.72,遠高於該模型的 3 個係數,說明仍缺少某些因素。納入全部三個設定後,R-Sq 為 86.25%,R-Sq(pred) 為 83.01%,S 為 0.6385,且 PRESS、AICc 和 BIC 為表中最低(16.1081、77.62 和 83.53)。R-Sq 與 R-Sq(pred) 之間的差距很小,說明模型沒有過配適。
團隊保留全部三個設定,並用 Fit Regression Model 對其進行配適。勾選 Enhanced tables 後,VIF 為 1.01 至 1.03,說明三個設定並非同步變化,每個效應均可單獨解讀。
常見問題
什麼是最佳子集迴歸?
最佳子集迴歸對候選預測變數的每種組合配適線性迴歸,並按 R-Sq 排序,將各規模下的最佳模型並排列出。它在研究早期使用,用於找出能解釋大部分反應變異的最小預測變數集,例如製程設定。
如何從最佳子集輸出中選出最佳模型?
應尋找這樣的模型:R-Sq(adj) 和 R-Sq(pred) 不再上升,Mallows' Cp 接近係數個數,且 S 較小。PRESS、AICc 和 BIC 越小越好。R-Sq 與 R-Sq(pred) 之間差距較大,提示存在過配適。然後在 Fit Regression Model 中檢查所選模型的殘差和係數。
最佳子集迴歸中的 Mallows' Cp 是什麼意思?
Mallows' Cp 將模型的誤差與含所有預測變數的全模型的誤差進行比較。偏誤很小的模型,其 Cp 接近 k(包括常數項在內的係數個數),全模型的 Cp 恆等於 k。Cp 遠高於 k(如範例中 3 個係數的模型的 14.72),提示缺少某個重要預測變數。
最佳子集迴歸要配適多少個模型?
若有 p 個自由預測變數,則共有 2 的 p 次方減 1 個子集,因此每增加一個候選預測變數,配適次數就翻一番。可以限制每個模型中自由預測變數的最小和最大數量,將已知的預測變數強制納入每個模型,並選擇每種規模下顯示最佳模型的數量,範圍為 1 至 5。