
二元邏輯迴歸
二元邏輯迴歸根據連續型預測變數、分類預測變數或兩者兼有,預測合格/不合格、是/否等兩種結果之一的機率。反應恰有兩個類別時使用;連續型反應應使用 Fit Regression Model。兩個類別都需收集足夠的資料,避免完全分離,並用適合度統計量和殘差診斷進行驗證。結果附帶信賴區間,預設為 95%。
最後審閱
核心要點
二元邏輯迴歸用於建立一個或多個預測變數與僅有兩種結果(如合格/不合格或不合格品/合格品)的反應之間的關係模型,並預測每種結果的機率。
什麼是二元邏輯迴歸?
二元邏輯迴歸是一種統計工具,用於分析一個或多個預測變數與 恰有兩種結果的分類反應變數 之間的關係,例如合格/不合格、是/否或不合格品/合格品。它根據預測變數的取值,預測其中一種結果相對於另一種結果發生的機率。
何時使用二元邏輯迴歸?
預測變數
- 預測變數可以是 連續型、分類型,或兩者混合
- 離散變數可視為連續型或分類型,取決於水準數和分析目的
- 僅有一個連續型預測變數且反應為連續型 → 使用 配適線圖
- 多個預測變數且反應為連續型 → 使用 配適迴歸模型
反應變數
- 反應必須恰有 兩個類別(例如合格/不合格、是/否、好/壞)
- 若反應為 連續型 → 使用 配適迴歸模型
- 若反應有 三個或更多無序類別 → 使用 名目邏輯迴歸
- 若反應有 三個或更多有序類別 → 使用 有序邏輯迴歸
正確使用二元邏輯迴歸的指南
- 反應變數必須恰有 兩個類別;若類別更多,請改用有序邏輯迴歸或名目邏輯迴歸。
- 預測變數可以是 連續型或分類型;執行分析之前,請確保每個變數的類型劃分正確。
- 確保資料 準確代表目標總體;有偏或不完整的資料會產生不可靠的預測。
- 為兩個類別都收集 足夠的資料點 ——某一類別的觀測過少,會使模型不穩定,預測也不可信。
- 儘可能 準確地量測所有變數;輸入資料的誤差會直接降低所預測機率的準確性。
- 按 資料的收集順序 記錄資料,以便發現可能影響結果的時間相關模式。
- 配適之後,使用 適合度統計量和殘差診斷驗證模型;配適不佳的模型會產生誤導性的預測。
- 避免 完全分離 ——即某個預測變數將兩個類別完全分開——因為這會給模型的估計帶來問題。
替代方法:何時不宜使用二元邏輯迴歸
- 若反應變數為 連續型,請改用 配適迴歸模型。
- 若 只有一個連續型預測變數 且反應為連續型,請改用 配適線圖。
- 若反應有 三個或更多無序類別,請改用 名目邏輯迴歸。
- 若反應有 三個或更多有序類別,請改用 有序邏輯迴歸。
- 若有 一個分類預測變數 且反應為連續型,請改用 單因素變異數分析。
如何進行二元邏輯迴歸
操作步驟如下:
- 登入 Zometric Statistical Software,網址為 https://statsai.zometric.com/
- 在首頁選擇 Statistical Tool>Regression >Binary Logistic Regression。
- 點選 Binary Logistic Regression,進入工具介面。
- 接下來,手動更新資料,或從 Excel 表格中完整複製(Ctrl+C)資料並貼上(Ctrl+V)到此處。
- 填寫左側給出的必填選項。
- 最後,點選頁面底部的 calculate,即可得到所需結果。
在二元邏輯迴歸的工具介面中,視窗分為兩個部分。
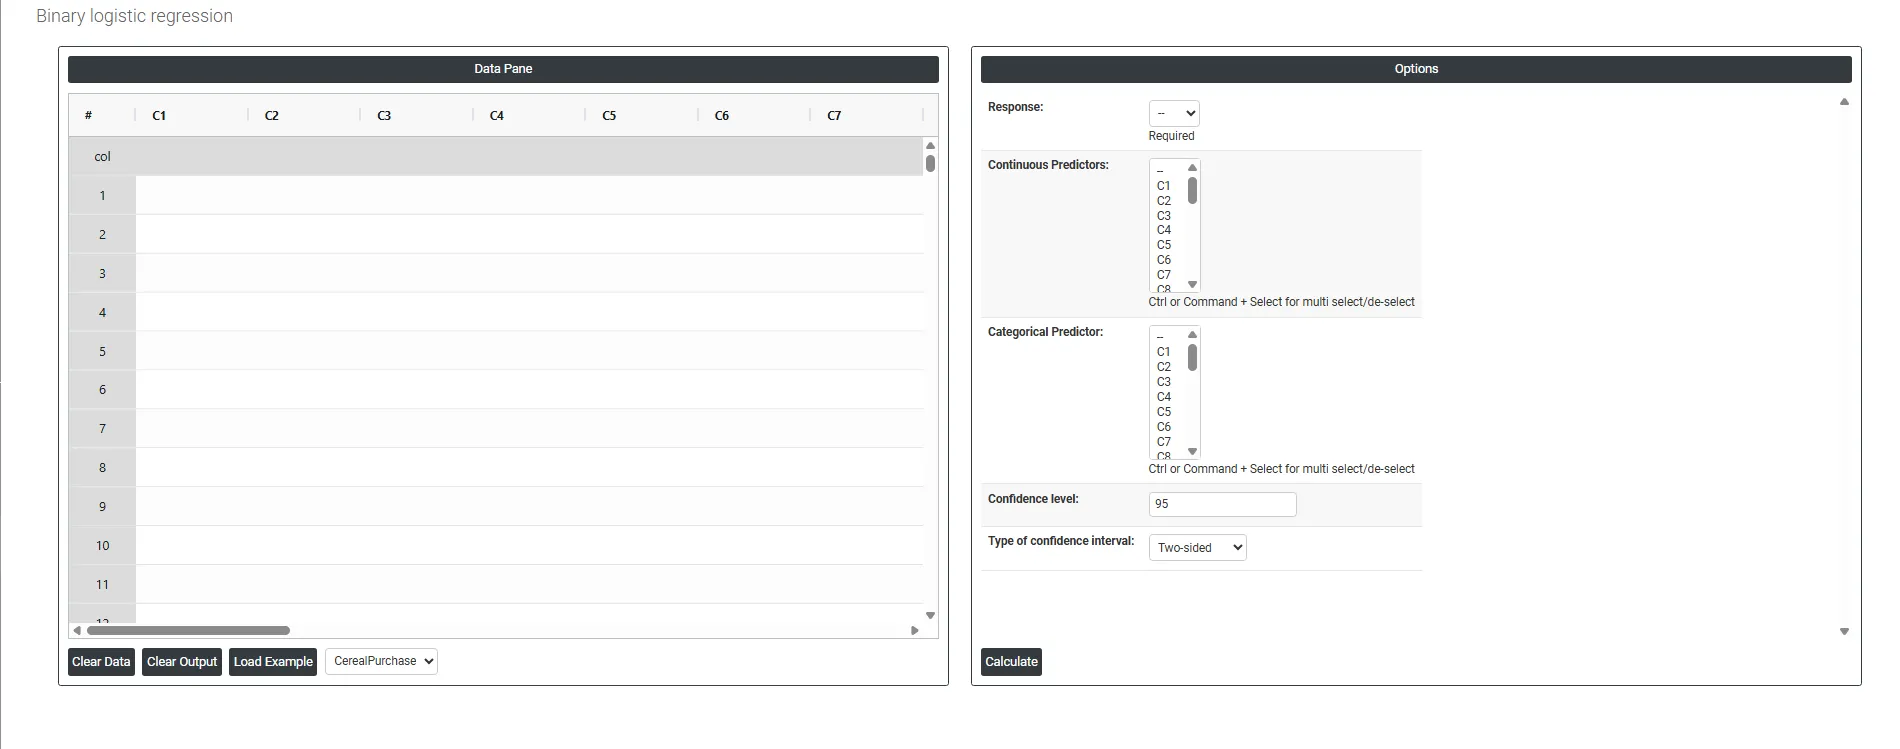
左側為資料窗格(Data Pane)。在 Data Pane 中,每一列構成一個子群組。資料可手動輸入,也可從 Excel 表格中完整複製(Ctrl+C)並貼上(Ctrl+V)到此處。
Load example: 將載入範例資料。
Load File: 用於直接載入 Excel 資料。
右側提供以下選項:
- Response 您要預測的結果變數,必須包含 恰好兩個類別,例如合格/不合格、是/否或不合格品/合格品。模型根據輸入的預測變數取值,計算其中一個類別相對於另一個類別發生的機率。
- Categorical Predictor 包含一組固定的不同分組或標籤的預測變數,例如班次、機器類型或供應商。模型估計屬於各個分組會如何改變反應落入某一類別而非另一類別的機率。
- Continuous Predictor 取可量測數值的預測變數,例如溫度、速度或重量。模型估計該變數每增加一個單位,會使反應結果發生的機率增大或減小多少。
- Confidence Interval 真實結果可能落入的取值範圍。預設值為 95%,即有 95% 的把握認為真實機率或係數位於該範圍內。預設設為 95%,是因為它是被廣泛接受的標準,兼顧統計可靠度與實際可用性——區間足夠窄而有用,又足夠寬以涵蓋不確定性。
- Type of Confidence Interval
- Two-Sided — 同時給出下界和上界,顯示真實值兩端可能落入的範圍。當需要檢測高於或低於的任何差異時使用。這是預設且最常用的選項。
- Upper Bound — 僅給出最大限,顯示真實結果可能達到的最高值。當只關心取值是否超過某一閾值時使用。
- Lower Bound — 僅給出最小限,顯示真實結果可能的最低值。當只關心取值是否低於某一閾值時使用。
常見問題
什麼是二元邏輯迴歸?
二元邏輯迴歸分析一個或多個預測變數與恰有兩種結果的分類反應之間的關係,例如合格/不合格、是/否或不合格品/合格品。它根據預測變數的取值,預測其中一種結果相對於另一種結果發生的機率。預測變數可以是連續型、分類型,或兩者混合。
什麼情況下應使用二元邏輯迴歸而不是其他迴歸方法?
反應恰有兩個類別時使用。若反應為連續型,請使用 Fit Regression Model;只有一個連續型預測變數時,使用 Fit Line Model。若反應有三個或更多無序類別,請使用 Nominal Logistic Regression;三個或更多有序類別則使用 Ordinal Logistic Regression。
可靠的二元邏輯迴歸有哪些要求?
兩個反應類別都要收集足夠的資料點,因為某一類別的觀測過少會使模型不穩定。將每個預測變數正確劃分為連續型或分類型,使用具有代表性且量測準確的資料,並避免完全分離,即某個預測變數將兩個類別完全分開,因為這會帶來估計問題。使用適合度統計量和殘差診斷驗證模型。
如何在 Zometric Statistical Software 中執行二元邏輯迴歸?
選擇 Statistical Tool > Regression > Binary Logistic Regression,然後輸入、貼上或載入資料。選擇二分類的 Response,以及任意 Categorical Predictor 和 Continuous Predictor 欄,設定信賴區間水準(預設 95%)和信賴區間類型(雙側、上界或下界),然後點選 Calculate。