
K 平均值集群
K-Means 集群採用 Lloyd 方法,以 k-means++ 初始中心和多次隨機起點,將觀測值按兩個或更多數值變數劃分為您設定的 K 個集群。計量單位不同的變數應先標準化。當預期有已知數量的組時使用。輸出包括最終劃分、集群形心、每個觀測值所屬的集群及距離,以及所解釋變異的百分比。
最後審閱
核心要點
K-Means 集群將觀測值劃分為固定數量(K)的組,使每組內的觀測值在所選變數上儘可能相似,例如將批次、零件或供應商分為不同類型。
用途
K-Means 集群將觀測值劃分為固定數量(K)的組,使每組內的觀測值在您所選的變數上儘可能相似。當預期有已知數量的組時使用,例如根據多個量測特性將材料批次、零件或供應商分為不同類型,或檢查您已在使用的標籤(等級、生產線、班次)是否確實能在量測資料中體現出來。
主要功能
- 將觀測值按兩個或更多數值變數劃分為您設定的 K 個集群。
- 可選標準化,使以較大單位計量的變數不會主導分組。
- 多個隨機起點;保留最佳解(集群內離散最小者),且相同資料始終得到相同結果。
- 報告最終劃分(大小、集群內平方和、到形心的平均距離和最大距離)、每個集群以原始單位表示的形心、每個觀測值所屬的集群,以及集群所解釋的總變異百分比。
- 前兩個所選變數的散佈圖,按集群著色。
統計方法
任一所選變數存在遺漏值或非數值的列將被剔除。勾選 Standardize variables 時,每個變數先轉換為 z = (x − mean) / s(s 為樣本標準差),使每個變數在集群前平均值為 0、標準差為 1。
K-means 演算法(Lloyd 方法)按歐氏距離將每個觀測值分配到最近的集群中心,將每個中心重新計算為其成員的平均值,並重復上述步驟直至分配不再變化。初始中心按 k-means++ 規則選取。由於結果可能取決於起點,演算法會執行 Number of random starts 所設定的次數,並保留集群內平方和最小的那次執行。使用固定的隨機種子,因此結果可精確重現。
集群所解釋的變異百分比為 (總平方和 − 集群內平方和) / 總平方和 × 100,其中總平方和是所有觀測值到總平均值的距離平方和,集群內平方和是每個觀測值到其所屬集群中心的距離平方和。兩者均基於集群時所用的資料計算(勾選該選項時為標準化後的資料)。該數值越高,表示組越分明、越緊湊,但它總是隨 K 增大而上升,因此跨 K 比較時須謹慎。形心會換算回原始單位後報告。最終劃分對每個集群給出觀測值個數、集群內平方和,以及其成員到形心的平均距離和最大距離;這些距離以及成員表中每個觀測值的距離,均為集群所用單位下的歐氏距離(勾選該選項時為標準化後的單位),與 Minitab 相同。
輸入欄位和選項
欄位 | 說明 |
Variables | 用於集群的兩個或更多數值欄。按住 Ctrl 或 Command 並點選可選擇多個。 |
Number of clusters (K) | 要形成的組數。預設為 3;最小為 2。至少需要 K 個完整的觀測值。 |
Standardize variables | 預設勾選。在集群前使每個變數處於相同尺度(平均值 0,標準差 1)。僅當所有變數單位相同,且希望離散程度較大的變數權重更大時才取消勾選。 |
Number of random starts | 嘗試的起點數;保留最佳結果。預設為 10,範圍 1 至 100。 |
Title | 顯示在圖和輸出上的標題。預設為 Cluster K-Means。 |
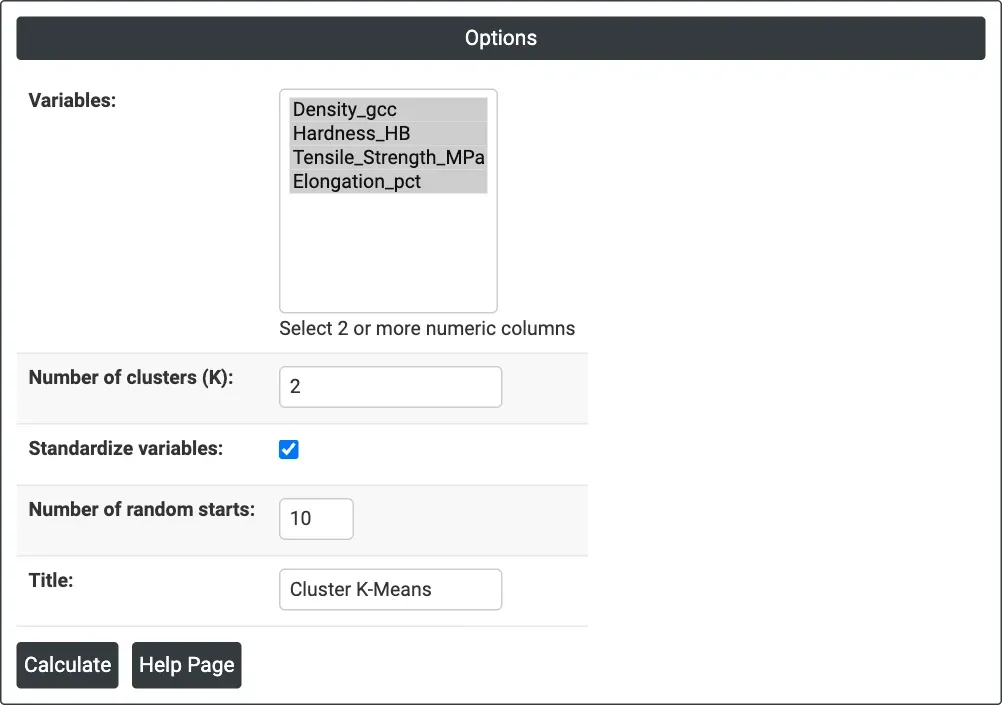
圖 1 — 範例的選項:四個特性欄,K = 2,標準化,10 個隨機起點。
輸出說明
- Cluster K-Means plot——第一個所選變數(x)對第二個所選變數(y)的散佈圖,每個點按其集群著色。
- % variation explained by clusters——總變異中位於集群之間而非集群內部的份額。
- Final Partition——每個集群的:Number of observations、Within cluster sum of squares、Average distance from centroid 和 Maximum distance from centroid。
- Cluster Centroids——每個集群的觀測值個數 N,以及各變數以原始單位表示的平均值。
- Cluster Membership——每個觀測值(按工作表列號)、其所屬集群,以及其到該集群形心的距離。
- 透過 Download 匯出 PDF。
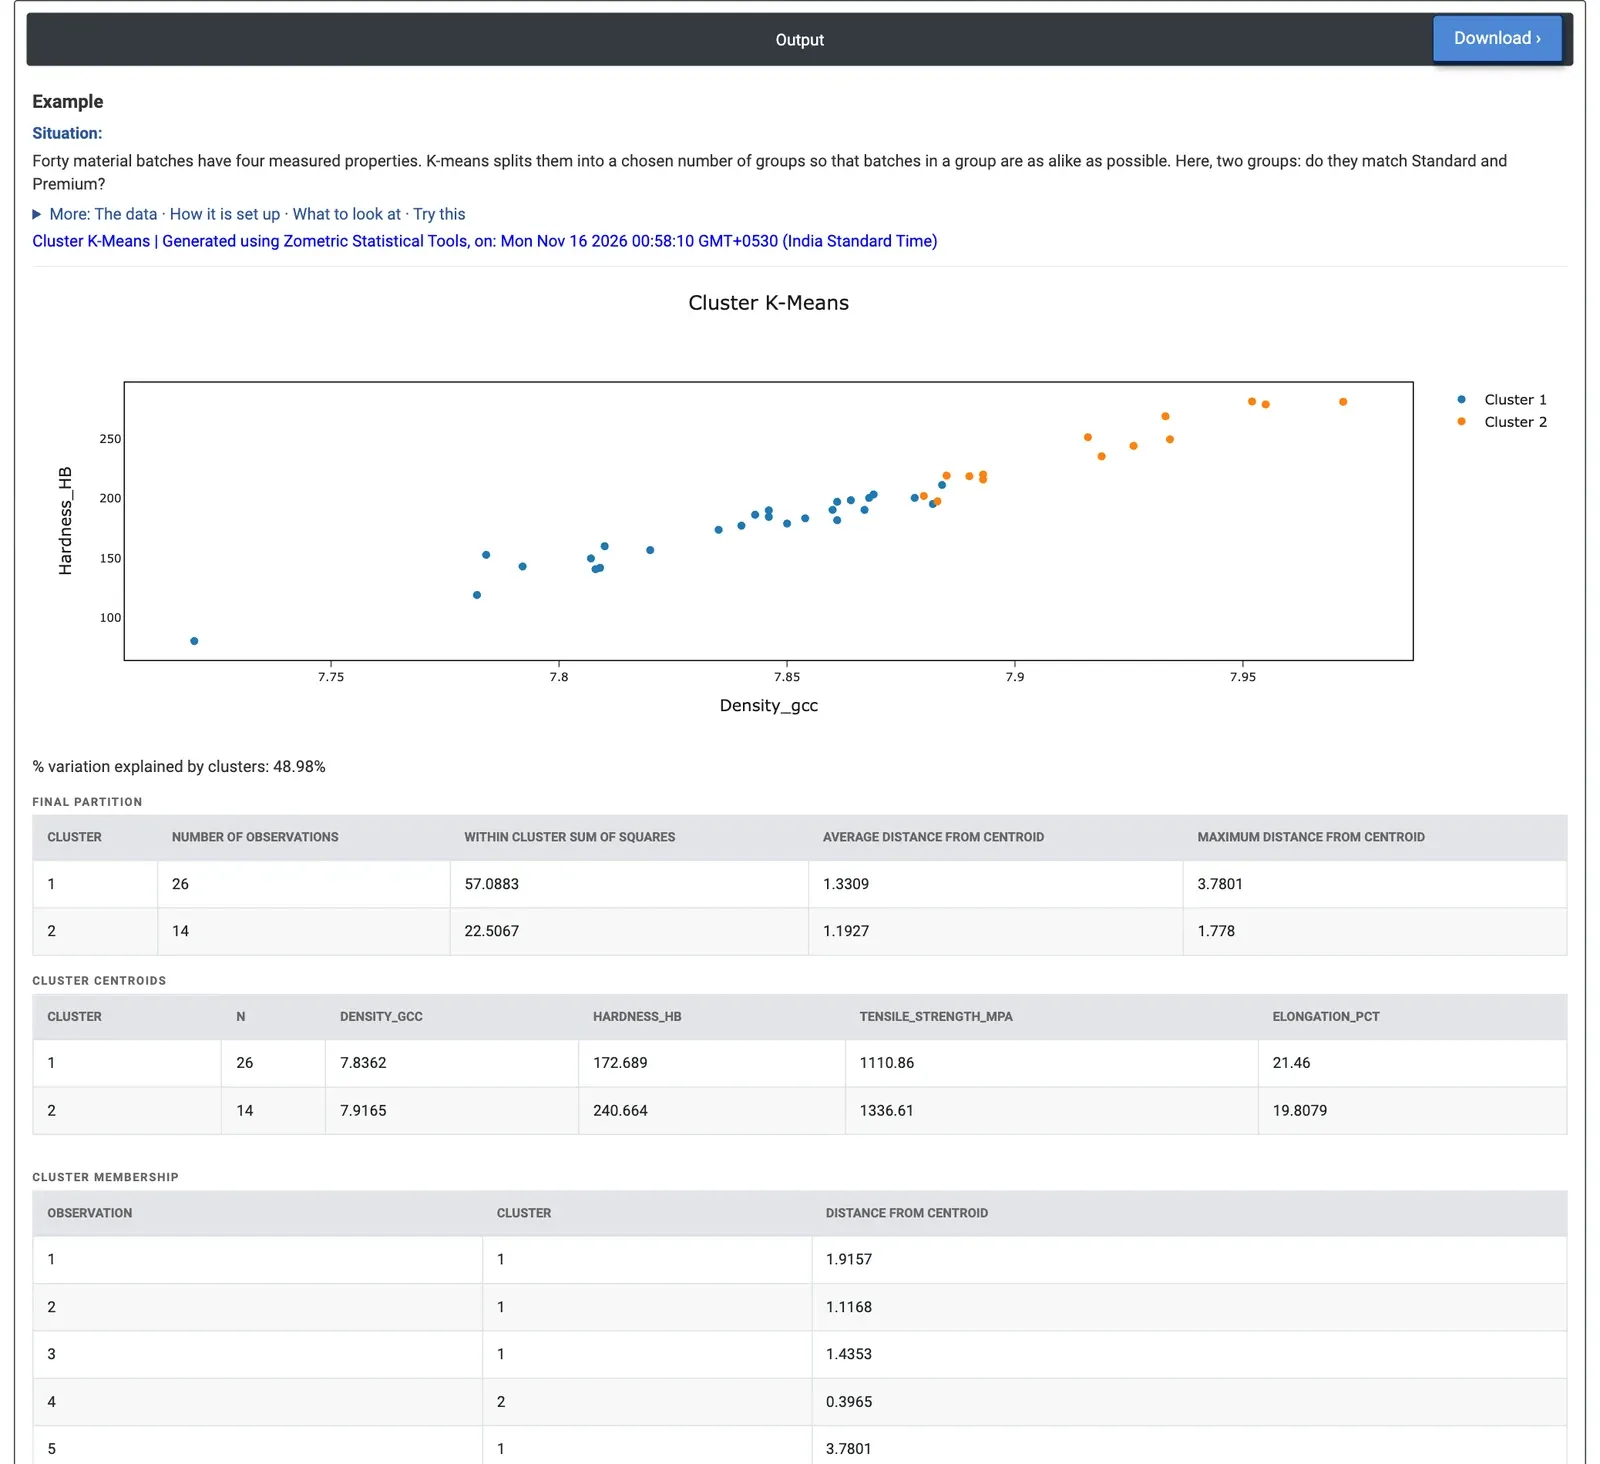
圖 2 — 40 個材料批次的兩個集群:集群 2(14 個批次)更硬、更強;集群解釋了 48.98% 的變異。最終劃分、形心和成員表的開頭位於圖之後。
計算範例
某材料實驗室有 40 個批次,每個批次均量測了密度(g/cc)、硬度(HB)、抗拉強度(MPa)和伸長率(%)。這些批次按 Standard 或 Premium 銷售,各 20 個。實驗室想知道僅憑量測值是否能分為兩個自然組,以及這些組是否與批次類型相符。他們選擇四個特性欄,設定 Number of clusters (K) = 2,保持勾選 Standardize variables(否則數值達數百的抗拉強度將佔主導),並保持 10 個隨機起點。
集群解釋了 48.98% 的變異。集群 2 包含 14 個批次,更硬、更強(平均值 240.7 HB 和 1,336.6 MPa),延展性略低(伸長率 19.8%);集群 1 包含 26 個批次,平均值為 172.7 HB、1,110.9 MPa 和伸長率 21.5%。密度形心相差不大(7.92 對 7.84 g/cc)。在最終劃分中,集群 2 是更緊湊的組(到形心的平均距離為 1.19,對比 1.33 個標準化單位);集群 1 中距離最遠的成員第 5 列,距其形心 3.78 個單位,是值得檢查的異常批次。與批次類型欄對比,集群 2 包含 11 個 Premium 和 3 個 Standard 批次,集群 1 包含 17 個 Standard 和 9 個 Premium 批次,因此 40 個批次中有 28 個落在與其類型相符的集群中。
對實驗室而言,這意味著最強的批次形成了一個明確的組,但許多 Premium 批次並不比 Standard 批次更硬或更強:這一標籤並未得到特性資料的完全支援。當 K = 3 時,所解釋的變異升至 69.66%,由 9 個批次組成的偏軟、偏弱的組(138.2 HB、995.9 MPa)從由 23 個批次組成的中間組和由 8 個批次組成的頂部組中分離出來。取消勾選 Standardize variables 會使劃分變為 19 和 21 個批次,因為此時抗拉強度的權重最大。若要利用已知類型建立規則,請對同一資料執行 Discriminant Analysis。
常見問題
何時應使用 k-means 集群?
當預期有已知數量的組,並希望根據多個量測特性將材料批次、零件或供應商等觀測值分為不同類型時使用。它也可用於檢查您已在使用的標籤(如等級、生產線或班次)是否確實能在量測資料中體現出來。
k-means 之前是否應對變數標準化?
標準化將每個變數轉換為平均值 0、標準差 1,使以較大單位計量的變數不會主導分組。該選項預設勾選。僅當所有變數單位相同,且希望離散程度較大的變數權重更大時才取消勾選;在計算範例中,取消勾選改變了劃分,因為此時抗拉強度的權重最大。
如何選擇集群數 K?
輸出會報告集群所解釋的總變異百分比;該數值越高,表示組越分明、越緊湊。它總是隨 K 增大而上升,因此跨 K 比較時須謹慎。在範例中,兩個集群解釋了 48.98% 的變異,三個集群解釋了 69.66%,並分離出一個由 9 個批次組成的偏軟、偏弱的組。
k-means 與判別分析有何區別?
K-means 僅根據量測值發現分組,不使用已知標籤。在範例中,兩個集群與 Standard 或 Premium 標籤相符的批次只有 40 個中的 28 個。若要利用已知類型建立區分各組的規則,請對同一資料執行 Discriminant Analysis。