
觀測集群(Cluster Observations)
Cluster Observations 基於兩個或更多數值變數,逐步合併最相似的觀測,並將結果繪製為樹狀圖。可選擇七種連結方法和五種距離度量,不同單位的變數應先標準化。Ward、Centroid 和 Median 需要歐氏距離或平方歐氏距離。輸入集群數後,會在該層級切割樹並為每個觀測標註類別。
最後審閱
核心要點
Cluster Observations 是階層式集群,可在事先不知道分組數量的情況下,根據多個數值變數將相似的列歸為一組,並繪製樹狀圖,顯示自然分組和異常列。
用途
Cluster Observations 將在多個數值變數上相似的觀測(列)歸為一組,無需事先知道分組數量。它逐步合併最相似的觀測,並將結果繪製為樹狀圖(dendrogram),使您看出有多少個自然分組以及哪些觀測屬於同一組。可用於尋找批次、零件、供應商或生產執行的自然族群,或找出不屬於任何分組的觀測。
主要功能
- 基於兩個或更多數值變數對觀測進行階層式(凝聚)集群。
- 七種連結方法:Single、Complete、Average、Centroid、Median、McQuitty 和 Ward。
- 五種距離度量:Euclidean、Squared Euclidean、Manhattan (City Block)、Cosine 和 Correlation。
- 可選的標準化,使不同單位的變數具有同等權重。
- 整個合併過程的樹狀圖,以及在給定集群數時可選的各觀測集群分配。
統計方法
任何所選變數中含遺漏值或非數值的列將被剔除;至少需要 3 個觀測。勾選 Standardize variables 時,每個變數轉換為 z = (x − mean) / s,其中 s 為樣本標準差。然後按所選度量計算每對觀測之間的距離:Euclidean √Σ(xᵢ − yᵢ)²、Squared Euclidean Σ(xᵢ − yᵢ)²、Manhattan Σ|xᵢ − yᵢ|、Cosine 1 − cos(兩列之間的夾角)或 Correlation 1 − r(兩列之間的相關係數)。
集群從每個觀測各為一類開始,反覆合併距離最近的兩個類,直至只剩一個類。連結方法決定如何度量兩個類之間的距離:Single 使用最近的一對成員,Complete 使用最遠的一對,Average 使用所有成對距離的平均值,McQuitty 使用加權平均,Centroid 使用類中心之間的距離,Median 使用未加權中心之間的距離,而 Ward 合併使類內平方和增加最小的一對類。Ward、Centroid 和 Median 需要歐氏距離或平方歐氏距離;工具會拒絕其他組合。
樹狀圖中兩個分支合併處的高度,即合併時兩者之間的距離,因此較長的垂直分支表示分離良好的分組。輸入 Number of clusters 後,樹會在得到該數量類別的層級處被切割,並為每個觀測標註其類別編號。
輸入欄位和選項
欄位 | 說明 |
Variables | 描述每個觀測的兩個或更多數值欄。按住 Ctrl 或 Command 並點選可選擇多個。 |
Linkage method | 類之間距離的度量方式:Single、Complete、Average(預設)、Centroid、Median、McQuitty 或 Ward。 |
Distance measure | 兩個觀測之間距離的度量方式:Euclidean(預設)、Squared Euclidean、Manhattan (City Block)、Cosine 或 Correlation。 |
Standardize variables | 預設勾選。先將每個變數縮放為平均值 0、標準差 1,使單位數值較大的變數不會佔據主導。 |
Number of clusters | 可選,2 或更大。將樹切割為該數量的類,並新增 Cluster Assignments 表。留空則僅顯示樹狀圖。 |
Title | 顯示在樹狀圖上的標題。預設為 Cluster Observations。 |
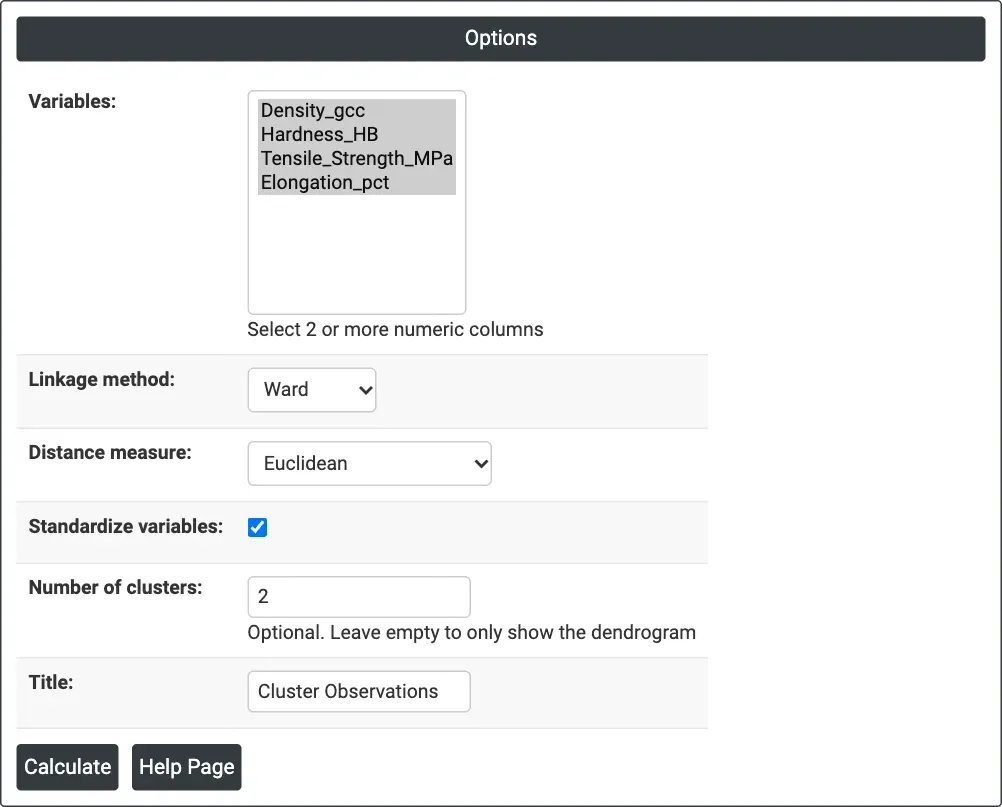
圖 1 — 範例的選項:四個效能欄、Ward 連結、歐氏距離、已標準化、2 個集群。
輸出說明
- Dendrogram — 合併過程。觀測(列號)沿 x 軸按樹的順序排列;y 軸(Distance)顯示分支合併的層級。
- Cluster Assignments — 輸入 Number of clusters 時顯示:每個觀測的列號及其類別編號。
- 透過 Download 匯出 PDF。
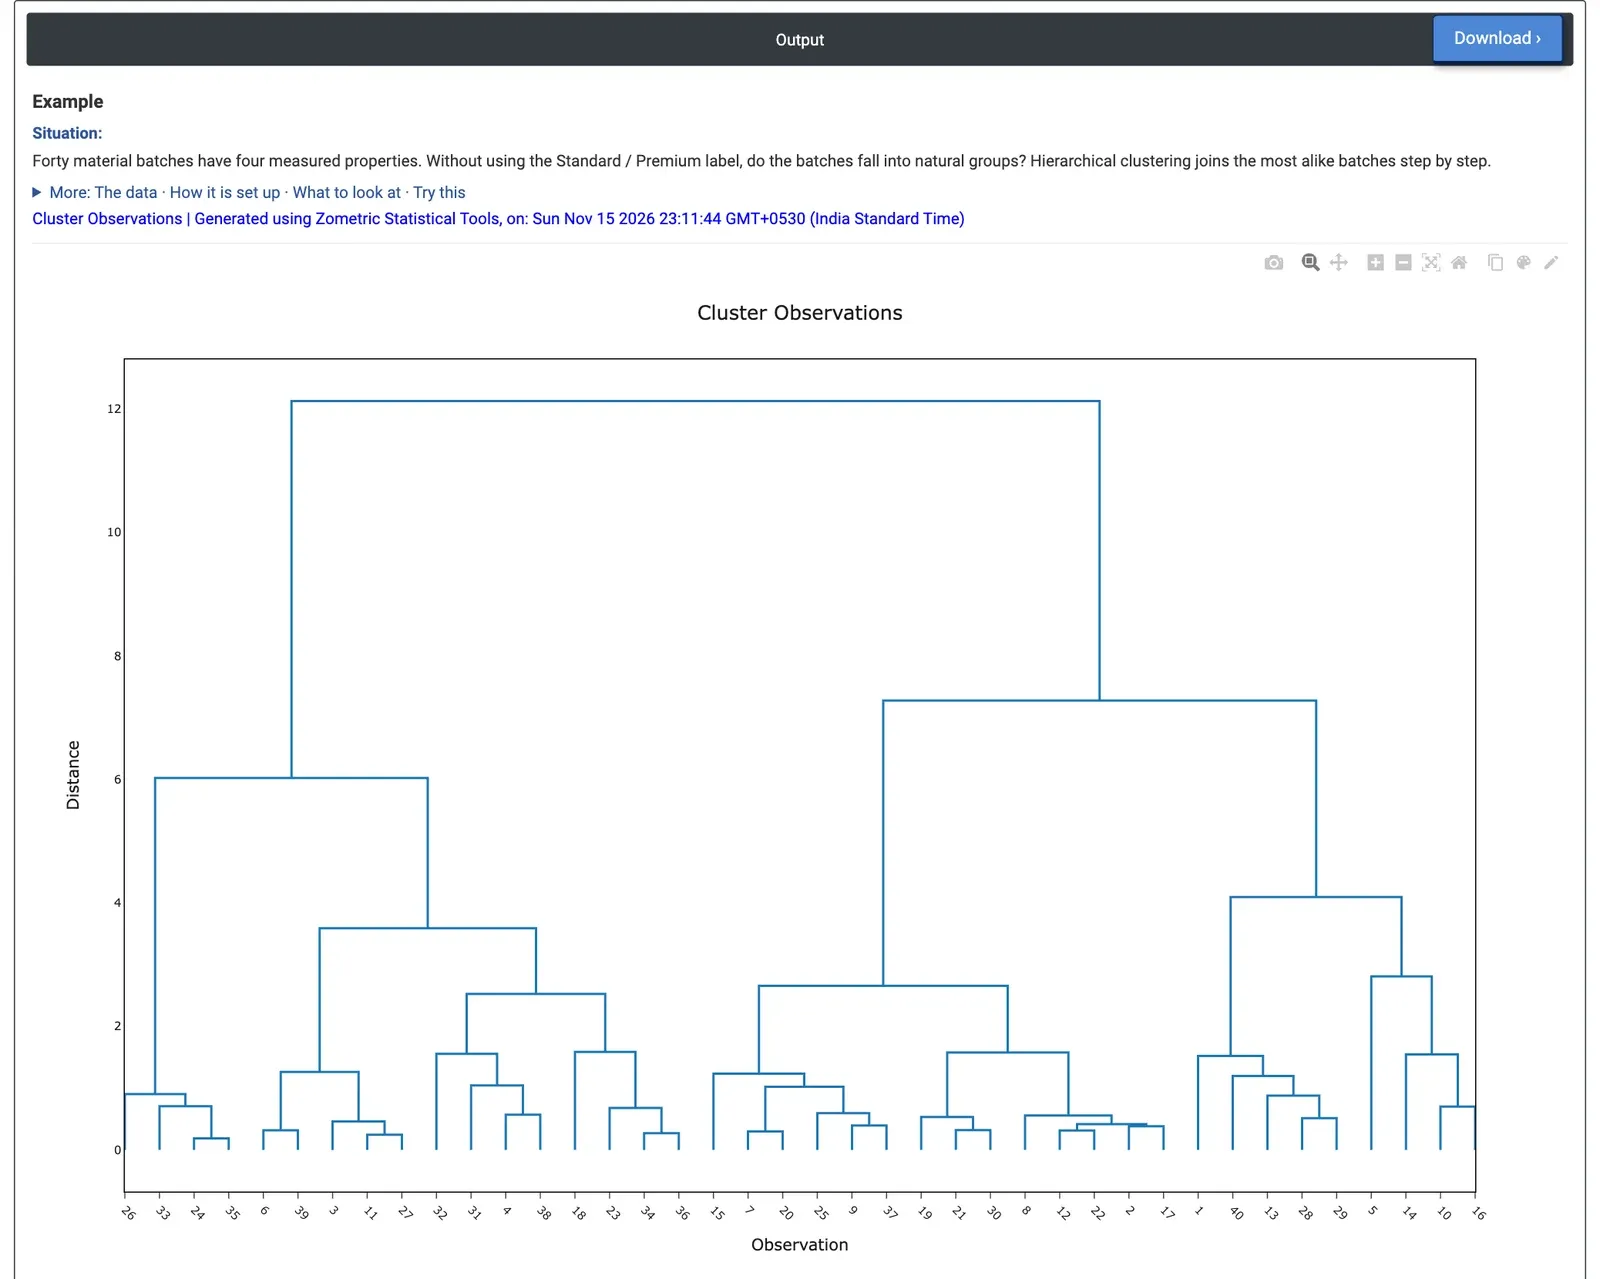
圖 2 — 採用 Ward 連結的 40 個材料批次的樹狀圖:兩個主要分支在約 12.1 的距離處合併。
計算範例
一家材料實驗室有 40 個批次,量測了密度(g/cc)、硬度(HB)、抗拉強度(MPa)和伸長率(%)。在不使用 Standard 或 Premium 標籤的情況下,實驗室想知道這些批次是否分為自然的組。他們選擇這四個效能欄,選擇 Linkage method = Ward 和 Distance measure = Euclidean,保持勾選 Standardize variables(否則以 g/cc 計的密度與以 MPa 計的強度不可比),並輸入 Number of clusters = 2。
樹狀圖顯示兩個主要分支在 12.1 的距離處合併,遠高於其後的合併距離(7.3 和 6.0),因此分為兩組是自然的切割。第 1 類有 17 個批次,更硬更強(平均值 231.6 HB 和 1,308 MPa,伸長率 19.8%);第 2 類有 23 個更軟、延展性更好的批次(170.5 HB、1,103 MPa、伸長率 21.7%)。對照批次類型,第 1 類包含 12 個 Premium 批次和 5 個 Standard 批次,第 2 類包含 15 個 Standard 批次和 8 個 Premium 批次:集群與類型相符的批次只有 40 個中的 27 個。
對實驗室而言,兩種類型的效能有大量重疊,相當一部分 Standard 批次與 Premium 批次一樣強。連結方法的選擇很重要:採用 Average 連結時,兩類切割只把一個批次單獨分出(第 5 列,80.1 HB 和 822.6 MPa,比其餘批次軟得多),而將其他 39 個批次歸為一組,這是發現離群值而非分組的有效方式。將 Ward 樹切割為 3 類,則分出一個由 9 個批次組成的偏軟組(138.2 HB、995.9 MPa)。
常見問題
什麼是觀測的階層式集群?
它從每個觀測各為一類開始,反覆合併距離最近的兩個類,直至只剩一個類。結果繪製為樹狀圖,因此無需事先知道分組數量,就能看出有多少個自然分組以及哪些觀測屬於同一組。它還能揭示不屬於任何分組的觀測。
如何閱讀樹狀圖?
觀測沿 x 軸按樹的順序排列,y 軸顯示分支合併時的距離。較長的垂直分支表示分離良好的分組。在計算範例中,兩個主要分支在 12.1 的距離處合併,遠高於其後 7.3 和 6.0 處的合併,因此分為兩組是自然的切割。
應使用哪種連結方法?
該工具提供 Single、Complete、Average、Centroid、Median、McQuitty 和 Ward。Ward 合併使類內平方和增加最小的一對類,並且與 Centroid 和 Median 一樣,需要歐氏距離或平方歐氏距離。選擇很重要:在範例中,Average 連結分出了一個孤立的異常批次,而 Ward 找到了兩個分組。
集群觀測之前是否應對變數進行標準化?
Standardize variables 預設勾選,先將每個變數縮放為平均值 0、標準差 1,使單位數值較大的變數不會佔據主導。在範例中,否則以 g/cc 計的密度與以 MPa 計的強度將不可比。含遺漏值或非數值的列會被剔除,且至少需要 3 個觀測。