
變數集群
變數集群對三個或更多數值變數應用階層式集群,使用相關、絕對相關或歐氏距離,以及七種連結方法之一。同步變化的變數最先連結,並以樹狀圖展示。可用於縮減冗長的量測項或問卷題項列表。至少需要 3 列完整資料。輸入集群數後,將為每個變數標註所屬集群。
最後審閱
核心要點
變數集群(Cluster Variables)將攜帶相似資訊的變數(欄)歸為一組,把同升同降的變數連結在一起,使冗長的量測項或問卷題項列表可以縮減為每個集群保留一個。
用途
變數集群將攜帶相似資訊的變數(欄)歸為一組。在各觀測值上同升同降的變數最先連結,結果以樹狀圖繪出。可用它縮減冗長的量測項或問卷題項列表:當多個變數落在同一集群中時,可以只追蹤其中一個變數或一個綜合得分,而不必追蹤全部變數。
主要功能
- 對三個或更多數值變數進行階層式集群。
- 距離可基於相關、絕對相關或歐氏距離。
- 七種連結方法:Single、Complete、Average、Centroid、Median、McQuitty 和 Ward。
- 樹狀圖顯示變數連結的順序和層級。
- 給定集群數時,可為每個變數選擇性地給出集群歸屬。
統計方法
任一所選變數存在遺漏值或非數值的列會被剔除;至少需要 3 個變數和 3 列完整資料。每個變數被視為一個點,其座標為該變數在各列中的取值,並用所選度量計算每對變數之間的距離。相關距離為 1 − r,其中 r 是兩個變數之間的 Pearson 相關係數:完全正相關時為 0,完全負相關時為 2。Absolute Correlation 距離為 1 − |r|,它將強負相關與強正相關視為同樣接近。歐氏距離為基於原始值的 √Σ(xᵢ − yᵢ)²,因此取決於各變數的單位。
集群從每個變數各自成類開始,反覆合併距離最近的兩個集群。連結方法決定集群之間的距離:Single 採用最近的一對,Complete 採用最遠的一對,Average 採用所有成對距離的平均值,McQuitty 採用加權平均,Centroid 和 Median 採用集群中心之間的距離,Ward 採用組內平方和的最小增量。Ward、Centroid 和 Median 需要使用歐氏距離;工具會拒絕其他組合。
採用相關距離時,高度 h 處的連結表示兩個分支中的變數平均相關係數約為 1 − h。輸入 Number of clusters 後,樹狀圖會被截斷為相應數量的集群,並為每個變數標註其所屬集群。
輸入欄位和選項
欄位 | 說明 |
Variables | 待分組的三個或更多數值欄。按住 Ctrl 或 Command 並點選可選擇多欄。 |
Linkage method | 集群之間距離的度量方式:Single、Complete、Average(預設)、Centroid、Median、McQuitty 或 Ward。 |
Distance measure | Correlation(預設)、Absolute Correlation 或 Euclidean。 |
Number of clusters | 可選,2 或更大。將樹狀圖截斷為該數量的集群,並新增 Cluster Assignments 表。留空則僅顯示樹狀圖。 |
Title | 樹狀圖上顯示的標題。預設為 Cluster Variables。 |
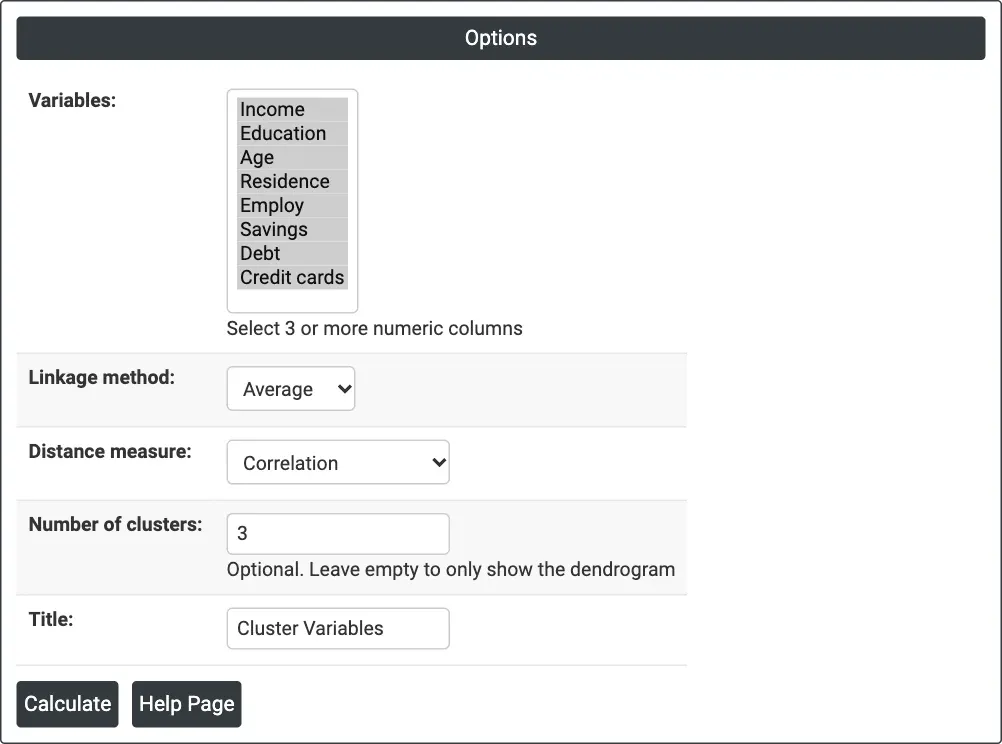
圖 1 — 範例的選項:八個貸款申請人變數,Average 連結,Correlation 距離,3 個集群。
輸出說明
- 樹狀圖——變數按樹的順序沿 x 軸排列;y 軸(Distance)顯示分支連結的層級。連結位置越低,變數越相似。
- Cluster Assignments——輸入 Number of clusters 時顯示:每個變數及其集群編號。
- 透過 Download 匯出 PDF。
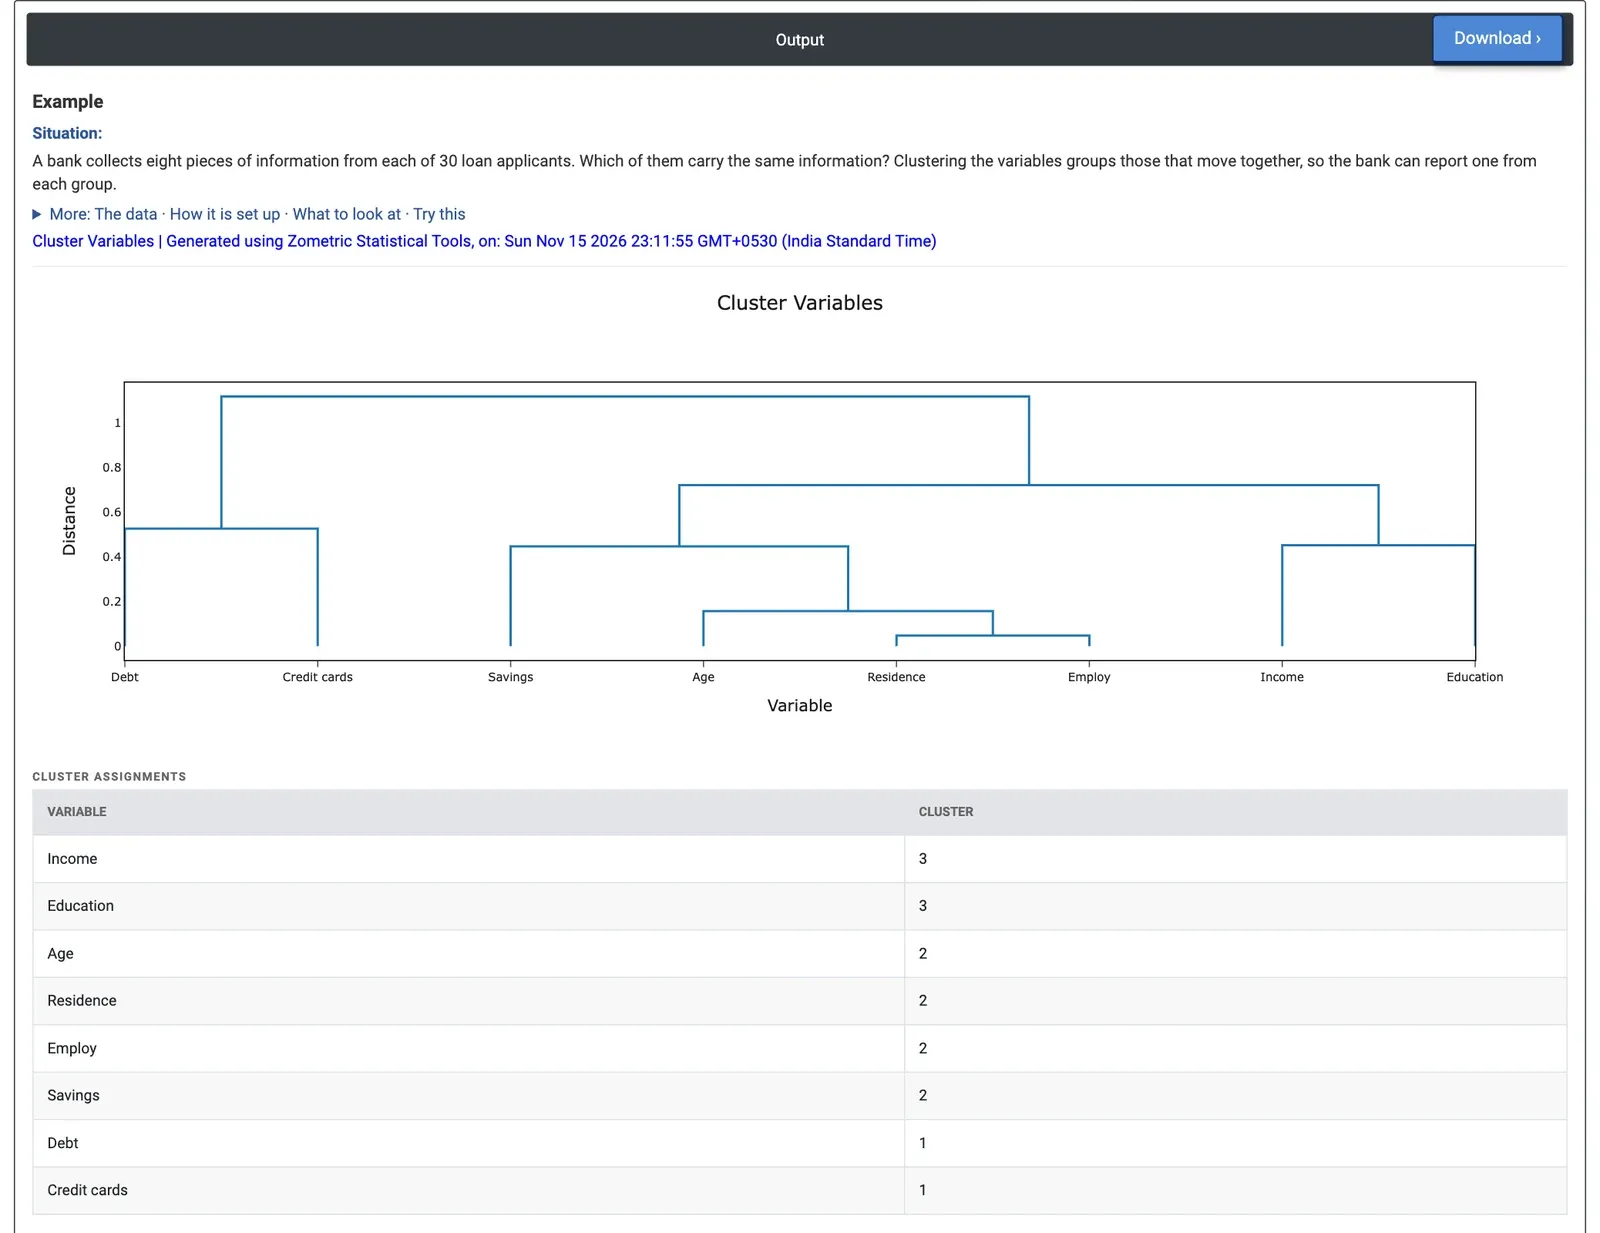
圖 2 — 八個貸款申請人變數的樹狀圖和集群歸屬:穩定性、收入和借貸集群。
計算範例
一家銀行為每位貸款申請人記錄八項資訊:收入(income)、受教育年限(education)、年齡(age)、現居住地年限(Residence)、現僱主任職年限(Employ)、儲蓄(savings)、債務(debt)和信用卡數量。信貸分析師想知道其中哪些變數攜帶相同的資訊,以便在簡短的報告中每組只展示一個。分析師使用 30 位申請人的資料,選擇全部八欄,保持 Linkage method = Average 和 Distance measure = Correlation,並輸入 Number of clusters = 3。
Residence 和 Employ 最先連結,距離為 0.048(相關係數 0.95),Age 在 0.157 處加入它們。Savings 在 0.446 處加入該組。Income 和 Education 在 0.451 處連結,Debt 和 Credit cards 在 0.526 處連結。分為三個集群時,Cluster 2 包含 Age、Residence、Employ 和 Savings,描述申請人的穩定性;Cluster 3 包含 Income 和 Education;Cluster 1 包含 Debt 和 Credit cards,即借貸情況。最後兩次連結發生在 0.72 和 1.117,遠高於其他連結,這支援分為三組。
對分析師而言,從每個集群中各取一個變數,例如 Employ、Income 和 Debt,即可涵蓋這八個變數所表達的大部分資訊。設定 Number of clusters = 2 會合併穩定性集群和收入集群,僅留下 Debt 和 Credit cards 單獨成組;設為 4 個集群時,Debt 和 Credit cards 會分開。對同樣的八欄進行因子分析會得到類似的分組,其負荷量可顯示每個變數歸屬其組的強度。
常見問題
變數集群用於什麼?
它用於縮減冗長的量測項或問卷題項列表。在各觀測值上同升同降的變數最先連結,結果以樹狀圖繪出。當多個變數落在同一集群中時,可以只追蹤其中一個變數或一個綜合得分,而不必追蹤全部變數。
什麼是相關距離?
相關距離為 1 − r,其中 r 是兩個變數之間的 Pearson 相關係數:完全正相關時為 0,完全負相關時為 2。絕對相關距離 1 − |r| 將強負相關與強正相關視為同樣接近。歐氏距離使用原始值,因此取決於各變數的單位。
如何閱讀變數的樹狀圖?
變數按樹的順序沿 x 軸排列,y 軸顯示分支連結時的距離;連結位置越低,變數越相似。採用相關距離時,高度 h 處的連結表示兩個分支中的變數平均相關係數約為 1 − h。
如何選擇變數集群的數量?
尋找明顯高於其他連結的連結。在貸款申請人範例中,最後兩次連結發生在 0.72 和 1.117,遠高於其餘連結,這支援分為三個集群:穩定性、收入和借貸。然後從每個集群中各取一個變數,例如 Employ、Income 和 Debt,即可涵蓋這八個變數所表達的大部分資訊。