
交叉分組表和卡方
根據每條記錄一列的資料,構建兩個分類變數的雙向計數表,可選列、欄和總百分比。使用 Pearson 卡方和概似比卡方檢定關聯,檢視期望計數、殘差和各儲存格的貢獻,並用 Cramér's V-square 度量關聯強度。Fisher 精確檢定適用於 2x2 表。期望計數低於 5 時會出現提示。分層變數為每個水準給出一張表。
最後審閱
核心要點
交叉分組表和卡方統計原始記錄中兩個分類變數的每種組合出現的次數,並檢定兩者是否相關,還可按第三個變數分層。
用途
交叉分組表和卡方統計原始記錄中兩個分類變數的每種組合出現的次數,例如部門與滿意度水準、缺陷類型與產線、供應商與合格/不合格,並檢定兩者是否相關。可用第三個變數將分析拆分為多個分層,例如每個班次一張表。
主要功能
- 帶列、欄合計的雙向計數表,由每條記錄一列的資料構建。
- 分層:為第三個變數的每個取值產生單獨的表和檢定。
- 列百分比、欄百分比和總百分比。
- Pearson 卡方檢定(預設開啟)和概似比卡方檢定。
- 期望計數,原始、標準化和調整後殘差,以及各儲存格對卡方的貢獻。
- Cramér's V-square,以及適用於 2×2 表的 Fisher 精確檢定。
- 部分期望計數低於 5 時給出警告。
統計方法
列、欄或分層變數中有遺漏值的記錄將被排除。對於觀測計數表 O,列合計為 Rᵢ,欄合計為 Cⱼ,總計為 N,獨立性假設下的期望計數為 Eᵢⱼ = Rᵢ·Cⱼ / N。Pearson 統計量 χ² = Σ (O − E)² / E(不做連續性校正,2×2 表也是如此)和概似比統計量 G² = 2 Σ O·ln(O / E) 與自由度為 (r − 1)(c − 1) 的卡方分配進行比較。較小的 p 值表示各列的欄構成不同。
要檢視是哪些儲存格驅動了結果:儲存格的貢獻為 (O − E)² / E;原始殘差為 O − E;標準化殘差為 (O − E) / √E;調整後殘差 (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)) 近似服從標準常態分配,因此超出約 ±2 的值標示出明顯偏離獨立性的儲存格。Cramér's V-square = χ² / (N·(min(r, c) − 1)) 度量關聯的強度,範圍從 0(無關聯)到 1(完全關聯);樣本數很大時,弱關聯也可能顯著。
卡方近似需要相當大的期望計數;頁面會報告有多少個儲存格的期望計數低於 5。對於 2×2 表,Fisher 精確檢定給出不依賴該近似的精確 p 值。類別按排序後的順序顯示。
輸入欄位和選項
欄位 | 說明 |
Rows | 用於表的列的分類欄。必填。 |
Columns | 用於欄的分類欄。必填;必須與 Rows 不同。 |
For layers | 可選。為該變數的每個取值產生單獨的表和檢定。 |
Row percents / Column percents / Total percents | 新增百分比表。預設關閉。 |
Chi-Square test | Pearson 卡方檢定。預設勾選。 |
Likelihood ratio chi-square | 新增概似比檢定。 |
Expected cell counts / Raw residuals / Standardized residuals / Adjusted residuals / Each cell's contribution to chi-square | 新增這些表。預設關閉。 |
Cramer's V-square statistic | 關聯的強度。 |
Fisher's exact test for 2x2 tables | 精確 p 值;僅對 2×2 表報告。 |
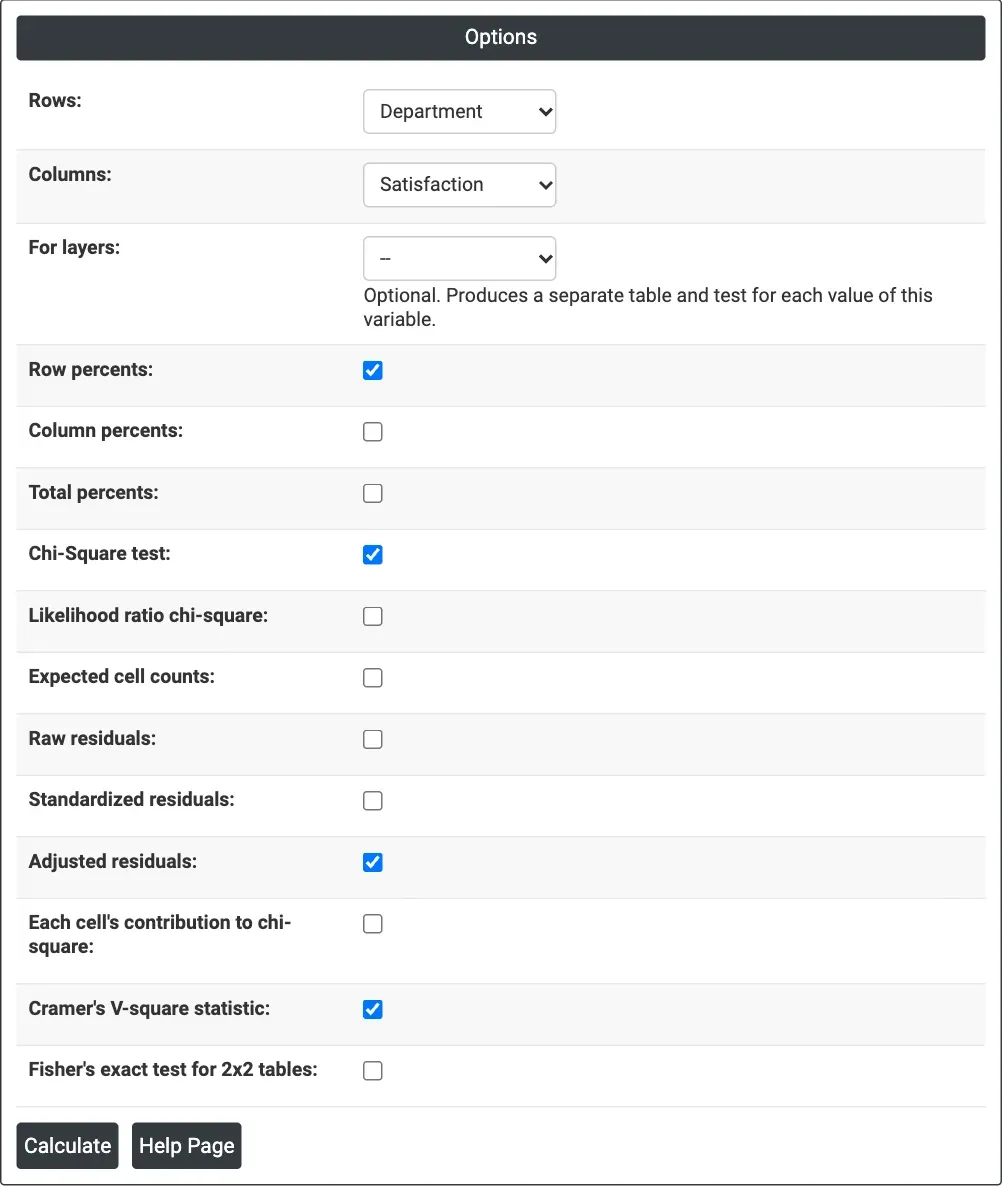
圖 1 — 滿意度調查範例的選項:Department 作為列,Satisfaction 作為欄,勾選列百分比、卡方檢定、調整後殘差和 Cramer's V-square。
輸出說明
- Counts——帶 All 合計的計數表(每個分層一張)。
- Row percents、Column percents、Total percents、Expected counts、Raw、Standardized 和 Adjusted residuals、Contribution 表——勾選時輸出。
- Chi-Square Test——Pearson 和概似比檢定的 Chi-Square、DF 和 P-Value,期望計數低於 5 時附有說明。
- Other Statistics——Cramer's V-square 和 Fisher 精確檢定的 P-Value。
- 透過 Download 匯出 PDF。
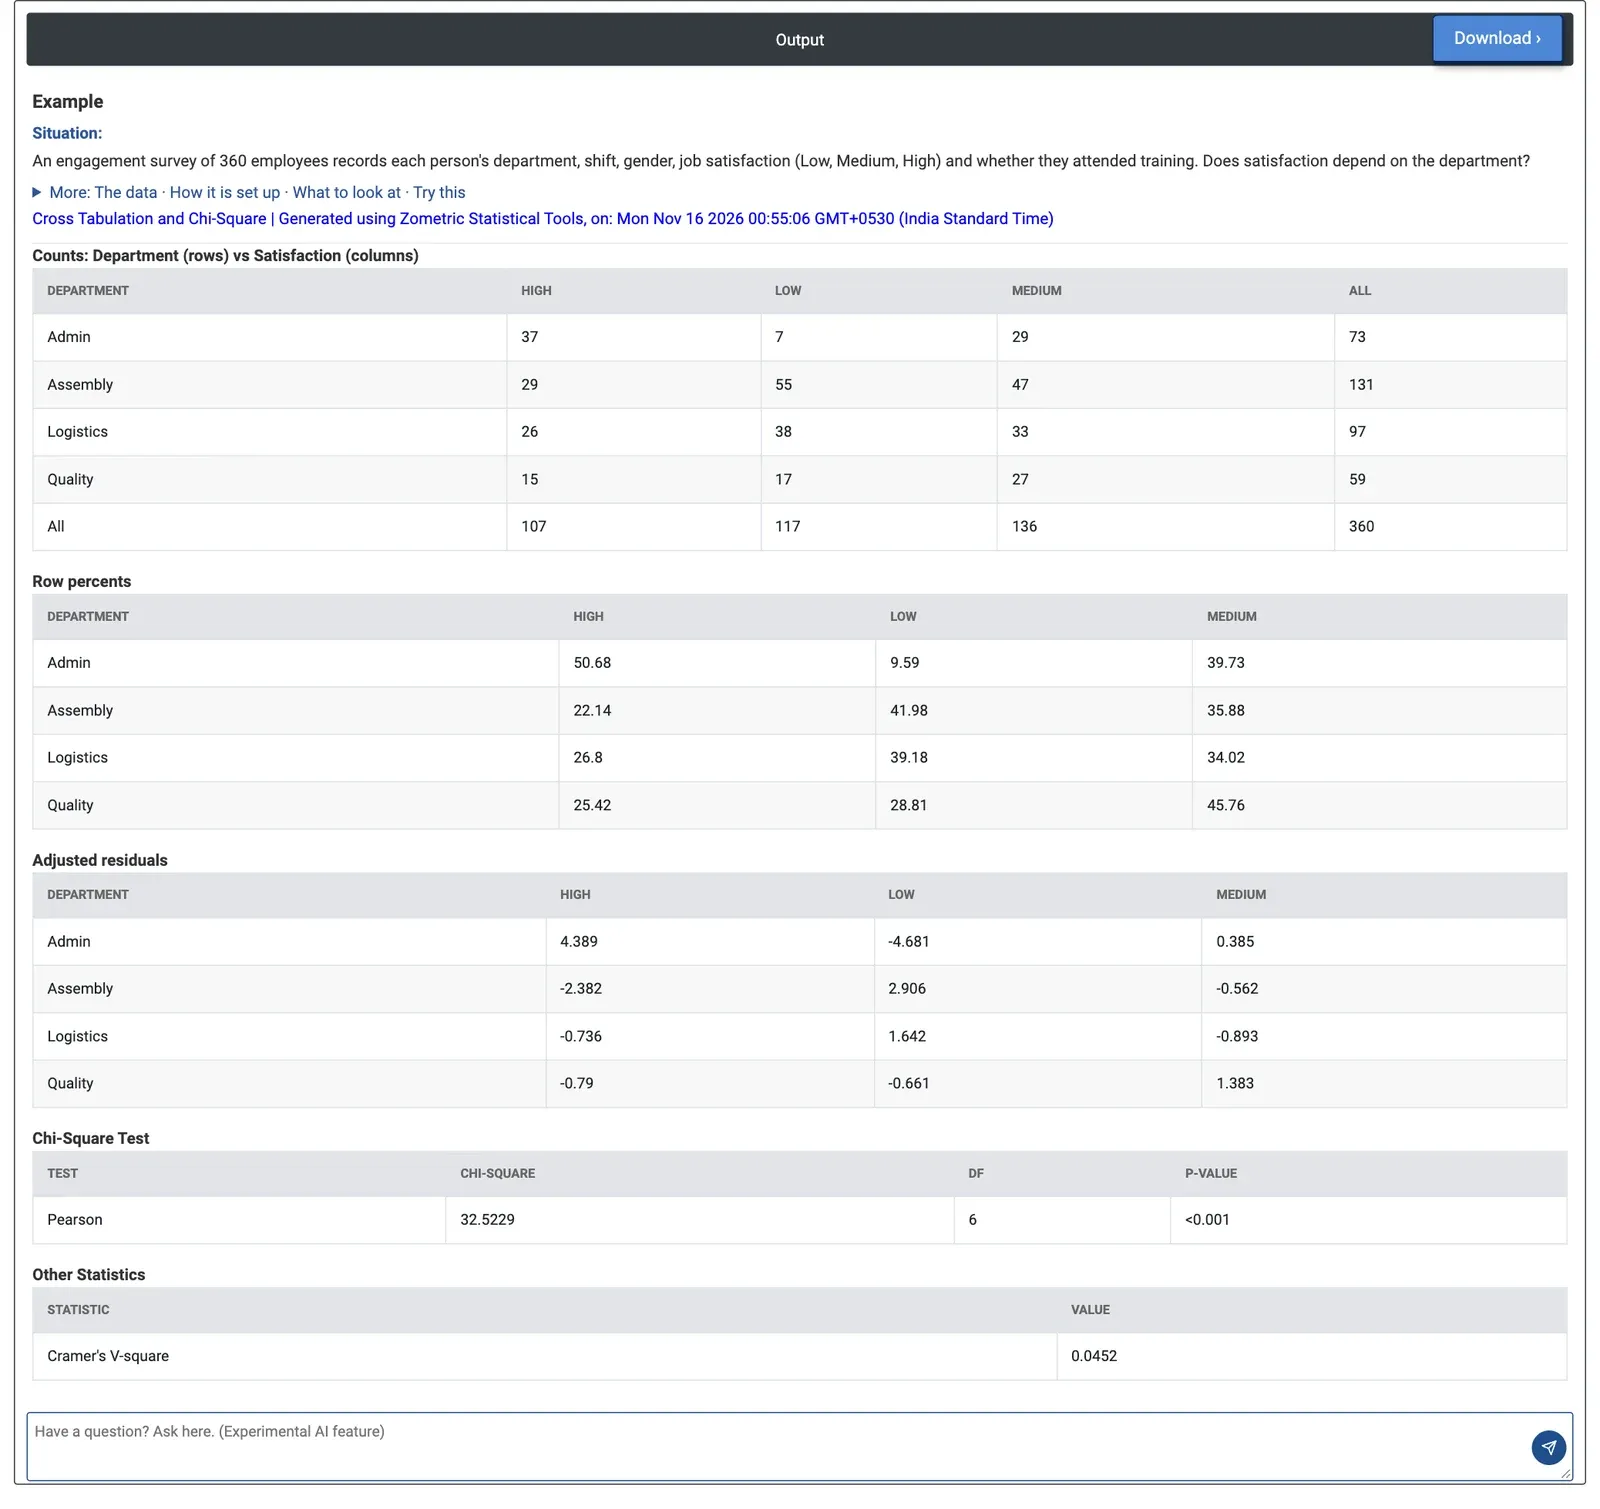
圖 2 — 各部門的滿意度:Pearson 卡方 32.52,自由度 6,p < 0.001;Admin 的 High 評價最多,Assembly 的 Low 評價最多。
計算範例
一項針對 360 名員工的敬業度調查記錄了每個人的部門、班次、性別、滿意度(Low、Medium、High)以及是否參加過訓練。人力資源部門想知道滿意度是否取決於部門。他們選擇 Department 作為列、Satisfaction 作為欄,並勾選列百分比、調整後殘差和 Cramer's V-square。
滿意度確實取決於部門:Pearson 卡方 32.52,自由度 6,p < 0.001。Admin 最滿意,High 佔 50.68%,Low 僅佔 9.59%;Assembly 最不滿意,Low 佔 41.98%,High 佔 22.14%。超出 ±2 的調整後殘差顯示了造成該結果的儲存格:Admin High(+4.389)和 Low(−4.681)、Assembly Low(+2.906)和 High(−2.382)。Cramér's V-square 為 0.0452:關聯真實存在,但程度不大。
將 For layers 設為 Shift,則每個班次產生一張表。在夜班中,Logistics 的 High 僅佔 4.88%,Low 佔 53.66%(High 的調整後殘差為 −2.475),而白班的 High 為 42.86%,因此應從夜班的 Logistics 團隊入手;夜班表附有說明:有 1 個儲存格的期望計數低於 5。性別與是否參加訓練構成 2×2 表:Fisher 精確檢定給出 p = 0.5888,因此沒有跡象表明參加訓練的情況因性別而異。
常見問題
交叉分組表與卡方檢定有什麼區別?
交叉分組表統計兩個分類變數的每種組合出現的次數,給出帶列、欄合計和可選百分比的雙向表。卡方檢定隨後檢定這兩個變數是否相關:較小的 p 值表示各列的欄構成不同。可用第三個變數將分析拆分為多個分層。
Cramér's V-square 度量什麼?
Cramér's V-square = χ² / (N·(min(r, c) − 1)) 度量關聯的強度,從 0(無關聯)到 1(完全關聯)。樣本數很大時,弱關聯在統計上也可能顯著;在調查範例中,儘管 p 低於 0.001,V-square 為 0.0452,關聯真實存在,但程度不大。
什麼情況下應使用 Fisher 精確檢定?
卡方近似需要相當大的期望計數,輸出會報告有多少個儲存格的期望計數低於 5。對於 2x2 表,Fisher 精確檢定給出不依賴該近似的精確 p 值。它僅對 2x2 表報告。
如何找出是哪些儲存格驅動了關聯?
檢視各儲存格對卡方的貢獻 (O − E)² / E 以及殘差。調整後殘差近似服從標準常態分配,因此超出約 ±2 的值標示出明顯偏離獨立性的儲存格。在範例中,Admin High(+4.389)和 Assembly Low(+2.906)是造成該結果的儲存格之一。