
判別分析
提供已知所屬組的樣品及數值型預測變數。線性判別分析假定預測變數服從多元常態分配且各組協變異數矩陣相同;二次判別分析允許每組有各自的協變異數矩陣。先驗機率可以相等、與組大小成比例或由使用者指定。輸出包括混淆矩陣、整體準確率和留一法交叉驗證準確率,以及用於對新樣品評分的線性分類函數。可用它檢視能否根據檢驗資料區分等級。
最後審閱
核心要點
判別分析根據量測值建立將樣品歸入已知組的規則,找出最能區分各組的量測值組合,並報告有多少樣品被正確分類。
用途
判別分析根據量測值建立將樣品歸入已知組的規則。提供已知所屬組的樣品(例如 Standard 與 Premium 批次、合格與不合格零件,或供應商)及其量測值;它會找出最能區分各組的量測值組合,並顯示該規則能正確分類多少樣品。可用它檢視能否根據檢驗資料區分某個等級或類型,或建立用於對新樣品分類的規則。
主要功能
- 適用於兩個或更多組的線性或二次判別函數。
- 先驗機率可對所有組相等、與組大小成比例,或由您設定。
- 實際組與預測組對照的混淆矩陣,並給出正確分類的整體百分比。
- 留一法交叉驗證,可更公允地估計該規則用於新樣品時的表現。
- 線性分類函數(每組一個常數項和每個預測變數一個係數),用於對新樣品評分。
統計方法
缺少分組、或預測變數遺漏或非數值的列將被剔除。反應被視為文字標籤,各組按字母順序或數值順序列出。至少要有 2 個組,且列數必須多於預測變數個數與組數之和。
線性判別分析假定預測變數在每個組內服從多元常態分配,且協變異數矩陣相同。它估計每組平均值 x̄g 和合併的組內協變異數矩陣 S,並給每組一個得分 Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg),其中 pg 是該組的先驗機率。樣品被分配到得分最高的組。Linear Discriminant (Classification) Functions 表為每組列出常數項(−½ x̄gᵀ S⁻¹ x̄g + ln pg)和係數 S⁻¹ x̄g。二次判別分析放棄協變異數相等的假設,為每組估計單獨的協變異數矩陣,得到彎曲的邊界;它每組需要更多資料,且沒有簡單的分類函數。
預設情況下,k 個組的先驗機率均為 1/k。成比例先驗使用每組在資料中所佔的份額,這會偏向較大的組。重代入準確率是對建立規則所用的同一批樣品進行分類,結果偏樂觀。留一法交叉驗證依次移除每個樣品,用其餘樣品建立規則並對被移除的樣品分類,因此更能反映對新樣品的準確率。
輸入欄位和選項
欄位 | 說明 |
Response (grouping variable) | 必填。包含每個樣品已知所屬組的分類欄。 |
Predictors | 用於區分各組的一個或多個數值欄。 |
Discriminant function | Linear(預設;協變異數矩陣相同)或 Quadratic(每組一個協變異數矩陣)。 |
Prior probabilities | All groups equal(預設)、Proportional to group sizes in the data 或 User-specified。 |
Custom priors | 僅在 Prior probabilities 為 User-specified 時使用。每組一個值,以逗號或空格分隔,按字母順序或數值順序的組順序排列;均為正數且總和為 1,例如 0.2, 0.5, 0.3。 |
Cross-validate (leave-one-out) | 預設勾選。增加交叉驗證準確率和混淆矩陣。 |
Title | 分析的標題。預設為 Discriminant Analysis。 |
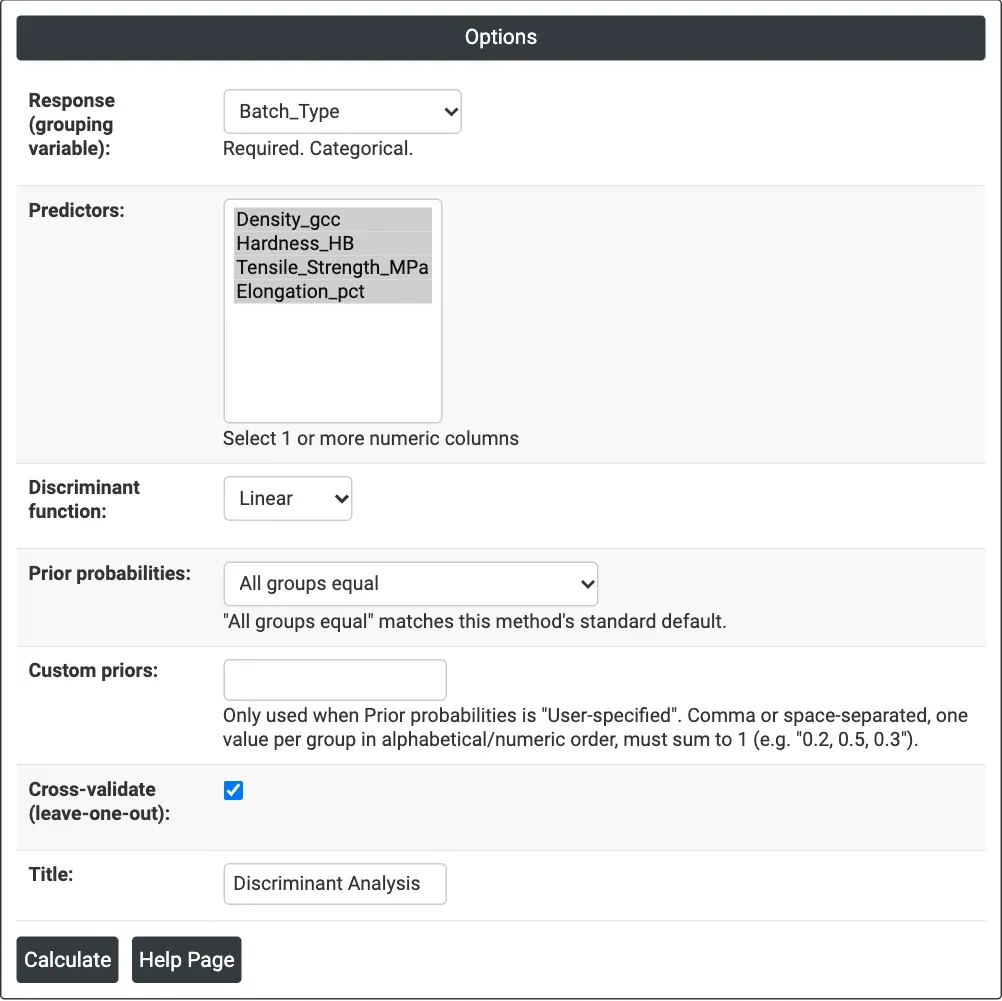
圖 1 — 範例的選項:Batch_Type 作為反應,四個特性欄作為預測變數,線性函數,先驗機率相等,留一法交叉驗證。
輸出說明
- Summary line——所用的 N、重代入準確率,以及勾選時的交叉驗證(留一法)準確率。
- Prior Probabilities——每組所用的先驗機率。
- Confusion Matrix (Resubstitution)——列為實際組,欄為預測組。
- Confusion Matrix (Cross-Validated)——同上,但採用留一法預測。
- Linear Discriminant (Classification) Functions——僅適用於線性函數:每組的常數項和每個預測變數的係數。新樣品被分配到其函數值最高的組。
- 透過 Download 匯出 PDF。
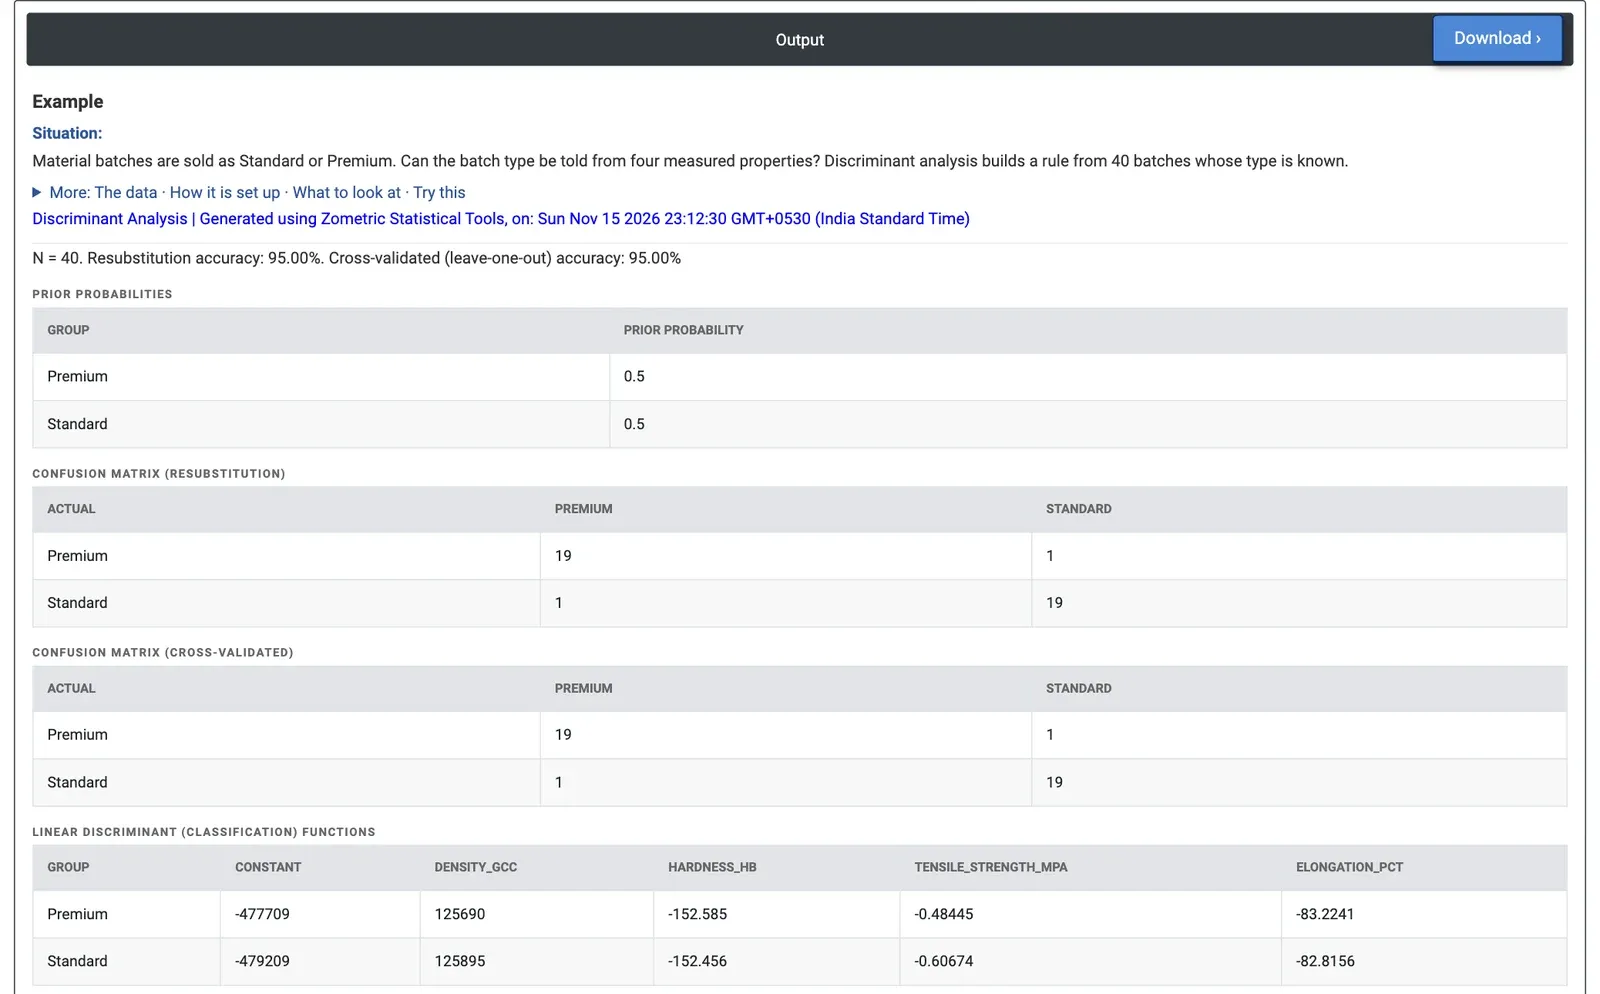
圖 2 — 40 個批次的結果:無論是對原資料還是採用留一法交叉驗證,均有 95% 被正確分類;每種類型各有一個批次被誤分類。
計算範例
某材料工廠將批次按 Standard 或 Premium 銷售。品質工程師想知道能否根據四項常規量測值區分批次類型:密度(g/cc)、硬度(HB)、抗拉強度(MPa)和伸長率(%)。工程師使用 40 個類型已知的批次,每種類型 20 個,並設定 Response (grouping variable) = Batch_Type,四個特性作為 Predictors,Discriminant function = Linear,Prior probabilities = All groups equal,並勾選 Cross-validate。
該規則正確分類了 40 個批次中的 38 個:對原資料為 95.00%,採用留一法交叉驗證也是 95.00%,因此它並非只是配適了建立它所用的 40 個批次。每種類型 20 個中各有 19 個正確。兩個被誤分類的批次是第 3 列(Standard,197.4 HB,1,210.8 MPa)和第 27 列(Premium,202.3 HB,1,209.7 MPa):它們介於各組平均值之間(Premium 為 212.9 HB 和 1,253.6 MPa,Standard 為 180.1 HB 和 1,126.2 MPa),值得檢查。分類函數根據每個新批次的四項量測值給出其 Premium 得分和 Standard 得分,該批次被分配到得分較高的類型。
密度的作用比其較小的離散程度所顯示的更重要:Premium 的平均值為 7.878 g/cc,Standard 為 7.850,而將密度從預測變數中去掉後,準確率降至 82.5%(交叉驗證為 75.0%)。二次函數在此表現更差,對原資料為 92.5%,交叉驗證為 85.0%,因為它要用每組僅 20 個批次來估計更多參數。對工程師而言,使用全部四項特性的線性規則已足以標出其標籤與量測值不符的批次。與不使用標籤對同一資料集群相比(Cluster K-Means 在 40 個批次中有 28 個與類型相符),已知分組使區分清晰得多。
常見問題
線性判別分析與二次判別分析有何區別?
線性判別分析假定預測變數在每個組內服從多元常態分配且協變異數矩陣相同,並給出線性分類函數。二次判別分析為每組估計單獨的協變異數矩陣,得到彎曲的邊界,但每組需要更多資料,且沒有簡單的分類函數。在範例中,每組僅有 20 個批次,二次判別表現更差。
為什麼使用留一法交叉驗證?
重代入準確率是對建立規則所用的同一批樣品進行分類,因此結果偏樂觀。留一法交叉驗證依次移除每個樣品,用其餘樣品建立規則並對被移除的樣品分類,更能反映對新樣品的準確率。在範例中兩者均為 95%,說明該規則並非只是配適了自身的資料。
先驗機率如何影響判別分析?
預設情況下,k 個組中每組的先驗機率為 1/k。成比例先驗使用每組在資料中所佔的份額,這會偏向較大的組。使用者指定的先驗必須為正數,每組一個,按字母順序或數值順序的組順序給出,且總和為 1。先驗透過其自然對數進入每組的得分。
如何用判別分析對新樣品分類?
對於線性判別函數,Zometric Statistical Software 在 Linear Discriminant (Classification) Functions 表中為每組列出一個常數項和每個預測變數的一個係數。用各組的函數對新樣品評分,並將其分配到函數值最高的組。