
因子分析
因子分析用較少的潛在因子概括三個或更多相關的數值變數。可用於找出試驗結果、製程量測值或問卷題項背後的特徵。因子數必須小於變數數,且列數必須多於變數數;最大概似法假定資料大致服從多元常態分配。輸出包括因子負荷量、共同性、唯一性、已解釋變異數和負荷量圖。
最後審閱
核心要點
因子分析用少數潛在因子解釋眾多量測變數之間的相關性,因此大量量測值或調查題項可以用少數幾個更易命名的因子來概括。
用途
因子分析用少數潛在因子解釋眾多量測變數之間的相關性。一起變動的變數負荷量在同一個因子上,因此一長串量測值或調查題項可以用少數幾個更易命名和追蹤的因子來概括。可用它找出一組試驗結果、製程量測值或問卷題項背後的少數潛在特徵,並發現哪些變數基本上自成一體。
主要功能
- 從三個或更多數值變數中提取您所選數量的因子。
- 兩種提取方法:Principal Components 和 Maximum Likelihood。
- Varimax 旋轉,使每個因子在較少的變數上有較大負荷量,從而更易命名。
- Factor Loadings 表,含每個變數的共同性和唯一性。
- 每個因子解釋的變異數百分比,以及前兩個因子的負荷量圖。
統計方法
任一所選變數中含有遺漏值或非數值的列會被剔除,並將每個變數標準化為平均值 0、標準差 1,因此分析基於相關矩陣進行。因子數必須小於變數數,且列數必須多於變數數。
採用 Principal Components 提取時,相關矩陣被分解為特徵值和特徵向量;對於最大的幾個特徵值,因子 j 的負荷量等於第 j 個特徵向量乘以其特徵值的平方根。採用 Maximum Likelihood 提取時,用迭代演算法透過最大概似法配適公因子模型(每個標準化變數 = 負荷量 × 因子 + 一個唯一誤差),在達到 Maximum iterations(預設 1000)或變化量低於 Convergence tolerance(預設 0.01)時停止。最大概似法假定各變數大致服從多元常態分配。
Varimax 旋轉(Kaiser 方法)對因子進行旋轉,使每個因子內平方負荷量的變異數儘可能大:這樣每個變數在一個因子上負荷量高,而在其他因子上接近零。旋轉不會改變每個變數被解釋的程度。旋轉後,因子按其所解釋的變異數排序。變數的共同性是其平方負荷量之和,即其變異數中被因子解釋的份額;唯一性為 1 − 共同性。因子解釋的變異數是其平方負荷量之和,以佔變數數的百分比報告。因子的符號是任意的:所有符號都反轉的因子含義相同。
輸入欄位和選項
欄位 | 說明 |
Variables | 三個或更多數值欄。按住 Ctrl 或 Command 並點選可選擇多個。 |
Number of factors to extract | 預設為 2。必須小於變數數。 |
Method of extraction | Principal Components(預設)或 Maximum Likelihood。 |
Type of rotation | Varimax(預設)或 None。旋轉僅適用於 2 個或更多因子。 |
Maximum iterations | 可選,僅用於 Maximum Likelihood 提取。留空則使用預設值(1000)。 |
Convergence tolerance | 可選,僅用於 Maximum Likelihood 提取。留空則使用預設值(0.01)。 |
Title | 負荷量圖上顯示的標題。預設為 Factor Analysis。 |
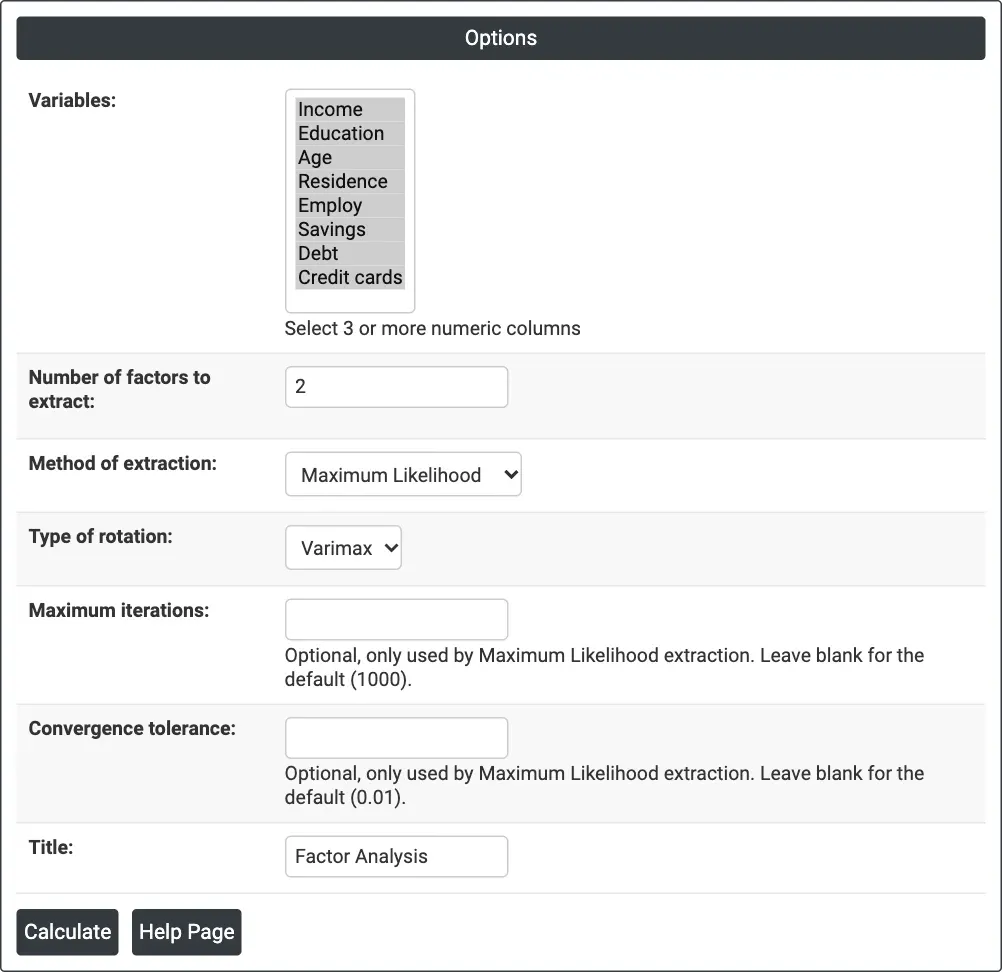
圖 1 — 範例的選項:八個貸款申請人變數,2 個因子,Maximum Likelihood 提取,Varimax 旋轉。
輸出說明
- Factor Loading Plot — 每個變數繪製為一條從原點到其在 Factor1(x)和 Factor2(y)上負荷量的線。指向同一方向的變數負荷量在同一個因子上。
- Method, rotation and variance explained — 按名稱給出的方法和旋轉(例如 Maximum Likelihood、Varimax)、每個因子解釋的總變異數百分比及累計百分比。
- Factor Loadings — 每個變數在各因子上的負荷量、其 Communality 和 Uniqueness。
- 透過 Download 匯出 PDF。
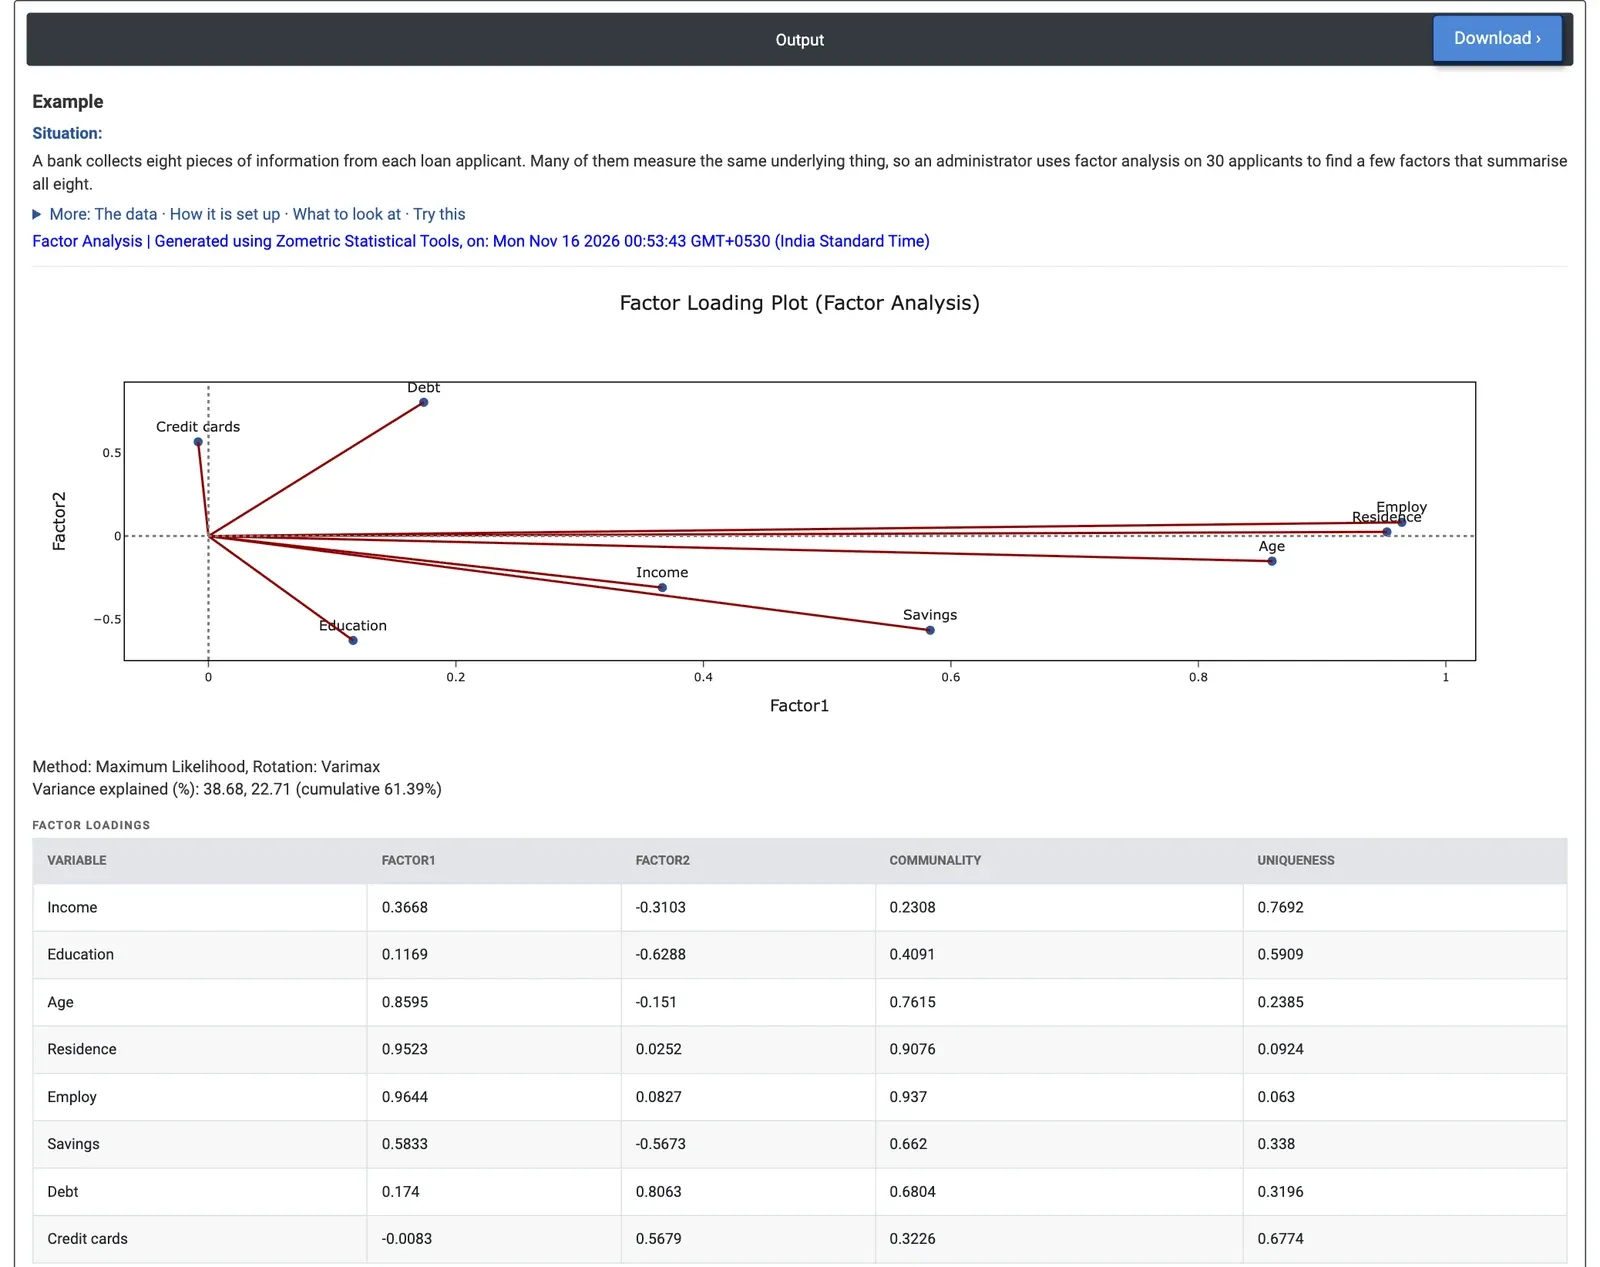
圖 2 — 八個貸款申請人變數的兩個旋轉後因子:穩定性因子(Employ、Residence、Age)和借貸因子(Debt、Credit cards,與 Education 相反),共解釋 61.39% 的變異數。
計算範例
一家銀行收集每位貸款申請人的八項資訊:收入、受教育年限、年齡、現住址居住年限(Residence)、現僱主任職年限(Employ)、儲蓄、債務和信用卡數量。其中許多似乎在量測同一件事。一位信貸管理人員希望得到少數幾個能概括這八項的因子。工程師利用 30 位申請人的資料,選擇全部八欄,設定 Number of factors to extract = 2、Method of extraction = Maximum Likelihood 和 Type of rotation = Varimax。
兩個因子分別解釋 38.68% 和 22.71% 的變異數,合計 61.39%。因子 1 在 Employ(0.9644)、Residence(0.9523)和 Age(0.8595)上負荷量很高,在 Savings(0.5833)上負荷量中等:這是一個穩定性與經驗因子。因子 2 在 Debt(0.8063)和 Credit cards(0.5679)上有負荷量,與 Education(−0.6288)和 Savings(−0.5673)相反:這是一個借貸因子。共同性顯示兩個因子對每個變數的描述程度:Employ(0.937)和 Residence(0.9076)較高,Income(0.2308)和 Credit cards(0.3226)較低。
對銀行而言,兩個因子能很好地描述申請人的穩定性和借貸情況,但收入基本上自成一體。取 3 個因子時,已解釋變異數升至 72.93%(36.67%、20.63% 和 15.63%),第三個因子主要是 Income(−0.8835)和 Education(−0.5491);Income 的共同性升至 0.8545。這與對同一資料使用變數集群的結果一致:變數集群將 Income 與 Education 歸為一組,穩定性變數歸為一組,Debt 與 Credit cards 歸為一組。不旋轉時,這裡的負荷量只有少許變化(因子 1:Employ 0.9666,Residence 0.9526),因為未旋轉的解本身已相當簡單。
常見問題
因子分析有什麼用途?
因子分析用少數潛在因子解釋眾多量測變數之間的相關性。一起變動的變數負荷量在同一個因子上,因此一長串試驗結果、製程量測值或問卷題項可以用少數幾個因子來概括,並且可以看出哪些變數基本上自成一體。
Principal Components 與 Maximum Likelihood 提取有什麼區別?
採用 Principal Components 提取時,相關矩陣被分解為特徵值和特徵向量,每個因子的負荷量是一個特徵向量乘以其特徵值的平方根。Maximum Likelihood 提取則用迭代演算法配適公因子模型,並假定各變數大致服從多元常態分配。
因子分析中的 Varimax 旋轉有什麼作用?
Varimax 旋轉對因子進行旋轉,使每個變數在一個因子上負荷量高,而在其他因子上接近零,從而使因子更易命名。旋轉不會改變每個變數被解釋的程度。旋轉後,因子按其所解釋的變異數排序。旋轉僅適用於兩個或更多因子。
如何解釋因子分析中的共同性和唯一性?
變數的共同性是其平方負荷量之和,即其變異數中被因子解釋的份額。唯一性等於 1 減去共同性。在貸款申請人範例中,Employ 的共同性為 0.937,而 Income 僅為 0.2308,表明在兩個因子下收入基本上自成一體。