
完全巢狀變異數分析
完全巢狀變異數分析估計層次結構的每一層級產生多少變異,含兩到四個巢狀的隨機因子,並以重複讀數作為誤差。每個較低層級的單元必須只屬於一個較高層級的單元。輸出包括變異數分析表(僅平衡設計給出 F 和 P)、含佔總量百分比的變異成分、期望均方、模型彙總和單元平均值。
最後審閱
核心要點
完全巢狀變異數分析將量測值的變異拆分到層次結構的各個層級(如批次、批內樣品和重複讀數),以顯示大部分變異來自何處。
用途
完全巢狀變異數分析將量測值的變異拆分到層次結構的各個層級,例如批次、每個批次內的樣品,以及每個樣品內的重複讀數。當每個較低層級的單元只屬於一個較高層級的單元(批次 1 的樣品 1 與批次 2 的樣品 1 不是同一種物料),並且想知道大部分變異來自何處,以便明確應對哪一方面採取措施(製程、取樣還是量測)時,請使用該方法。
主要功能
- 兩到四個巢狀因子,從最外層(如 Batch)到最內層(如 Sample);最內層因子內的重複讀數構成誤差。
- 選擇多個反應時,每個反應各做一次分析。
- 含序貫平方和的變異數分析表,以及每一層級相對於其下一層級的 F 檢定。
- 變異成分及其佔總量的百分比和標準差。
- 期望均方、模型彙總,以及每個單元的平均值和標準差表。
- 對於變異成分可處理非平衡資料;可透過 Data Options 對列進行子集選擇。
統計方法
所有因子均視為隨機因子,且每個因子都巢狀在前一個因子之內。每個因子的平方和是其單元平均值圍繞上一層級平均值的離散程度;誤差平方和是讀數圍繞最內層單元平均值的離散程度。每個因子的自由度為(其單元數 − 上一層級的單元數),誤差的自由度為 N − 最內層單元數。
每個因子相對於其內一層的因子進行檢定,最內層因子則相對於誤差進行檢定:F = MS(因子) / MS(下一內層項)。僅對平衡設計給出 F 和 P(每個單元內的讀數數量相等,且每個單位內的子單元數量相等);對於非平衡資料,頁面會予以說明並略去這兩項。
變異成分根據期望均方得出(變異數分析法):每個因子的 E(MS) 等於 σ²(誤差) 加上該因子及其內層因子的分量的倍數,如 Expected Mean Squares 表所示,其中 (1)、(2)、… 按巢狀順序對各因子編號,最後一個編號為誤差。從最內層項向外逐層求解這些方程,即可得到各分量;負估計值顯示為佔總量的 0%。% of Total 為每個分量佔變異數之和的份額,StDev 為其平方根。反應或因子值遺漏的列會被剔除。
輸入欄位和選項
欄位 | 說明 |
Responses | 一個或多個數值型欄。必填;每個反應各做一次分析。 |
Factor 1 (outermost) | 層次結構的最高層,例如 Batch。必填。 |
Factor 2 (nested in Factor 1) | 必填,例如批次內的 Sample。 |
Factor 3 (nested in Factor 2) / Factor 4 (nested in Factor 3) | 可選的更深層級;Factor 4 需要有 Factor 3。 |
Data Options: Subset (optional) | 按列號和/或條件,選擇 Exclude matching rows(預設)或 Include only matching rows。 |
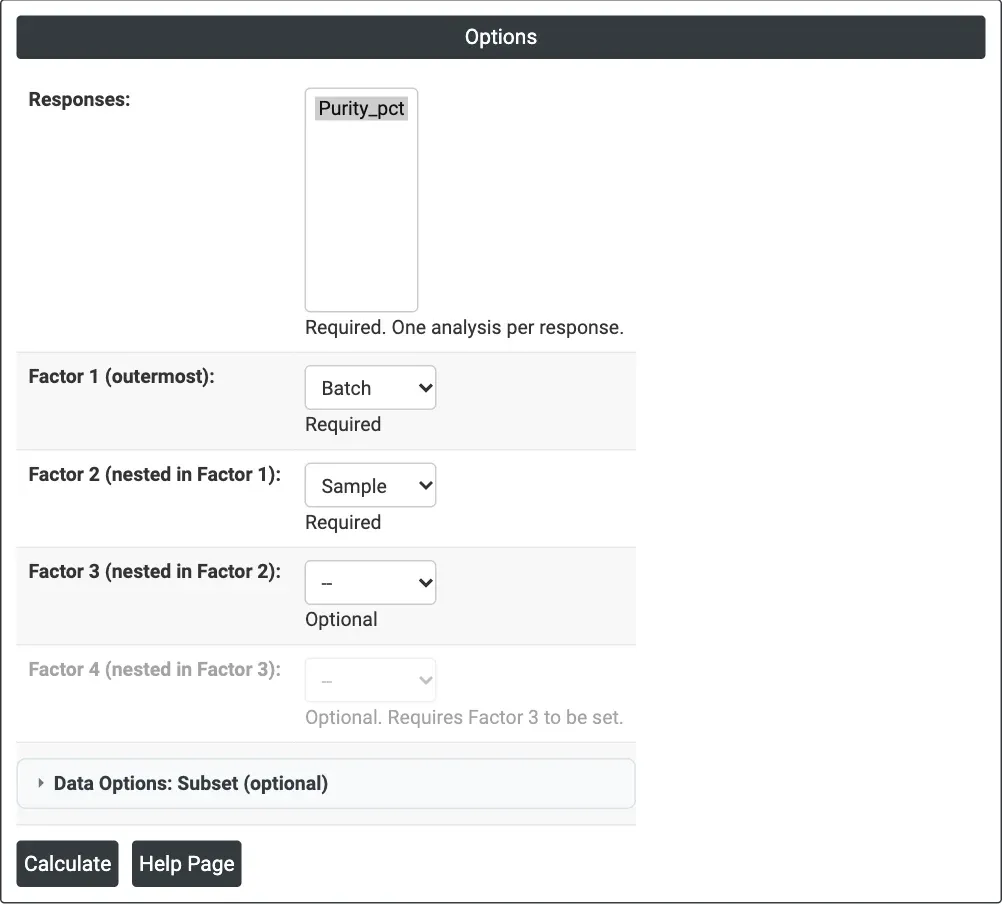
圖 1 — 純度範例的選項:以 Purity_pct 作為反應,Batch 作為 Factor 1,Sample(巢狀於 Batch 中)作為 Factor 2。
輸出說明
- Analysis of Variance — 每個因子、誤差和合計的 DF、SS、MS、F 和 P。
- Variance Components — 每個因子、誤差和合計的 Var Comp、% of Total 和 StDev。
- Expected Mean Squares — 每個均方由各變異成分構成的情況。
- Model Summary — S、R-sq 和 R-sq(adj)。
- Means — 每個最內層單元的 N、平均值和標準差。
- 透過 Download 匯出 PDF。
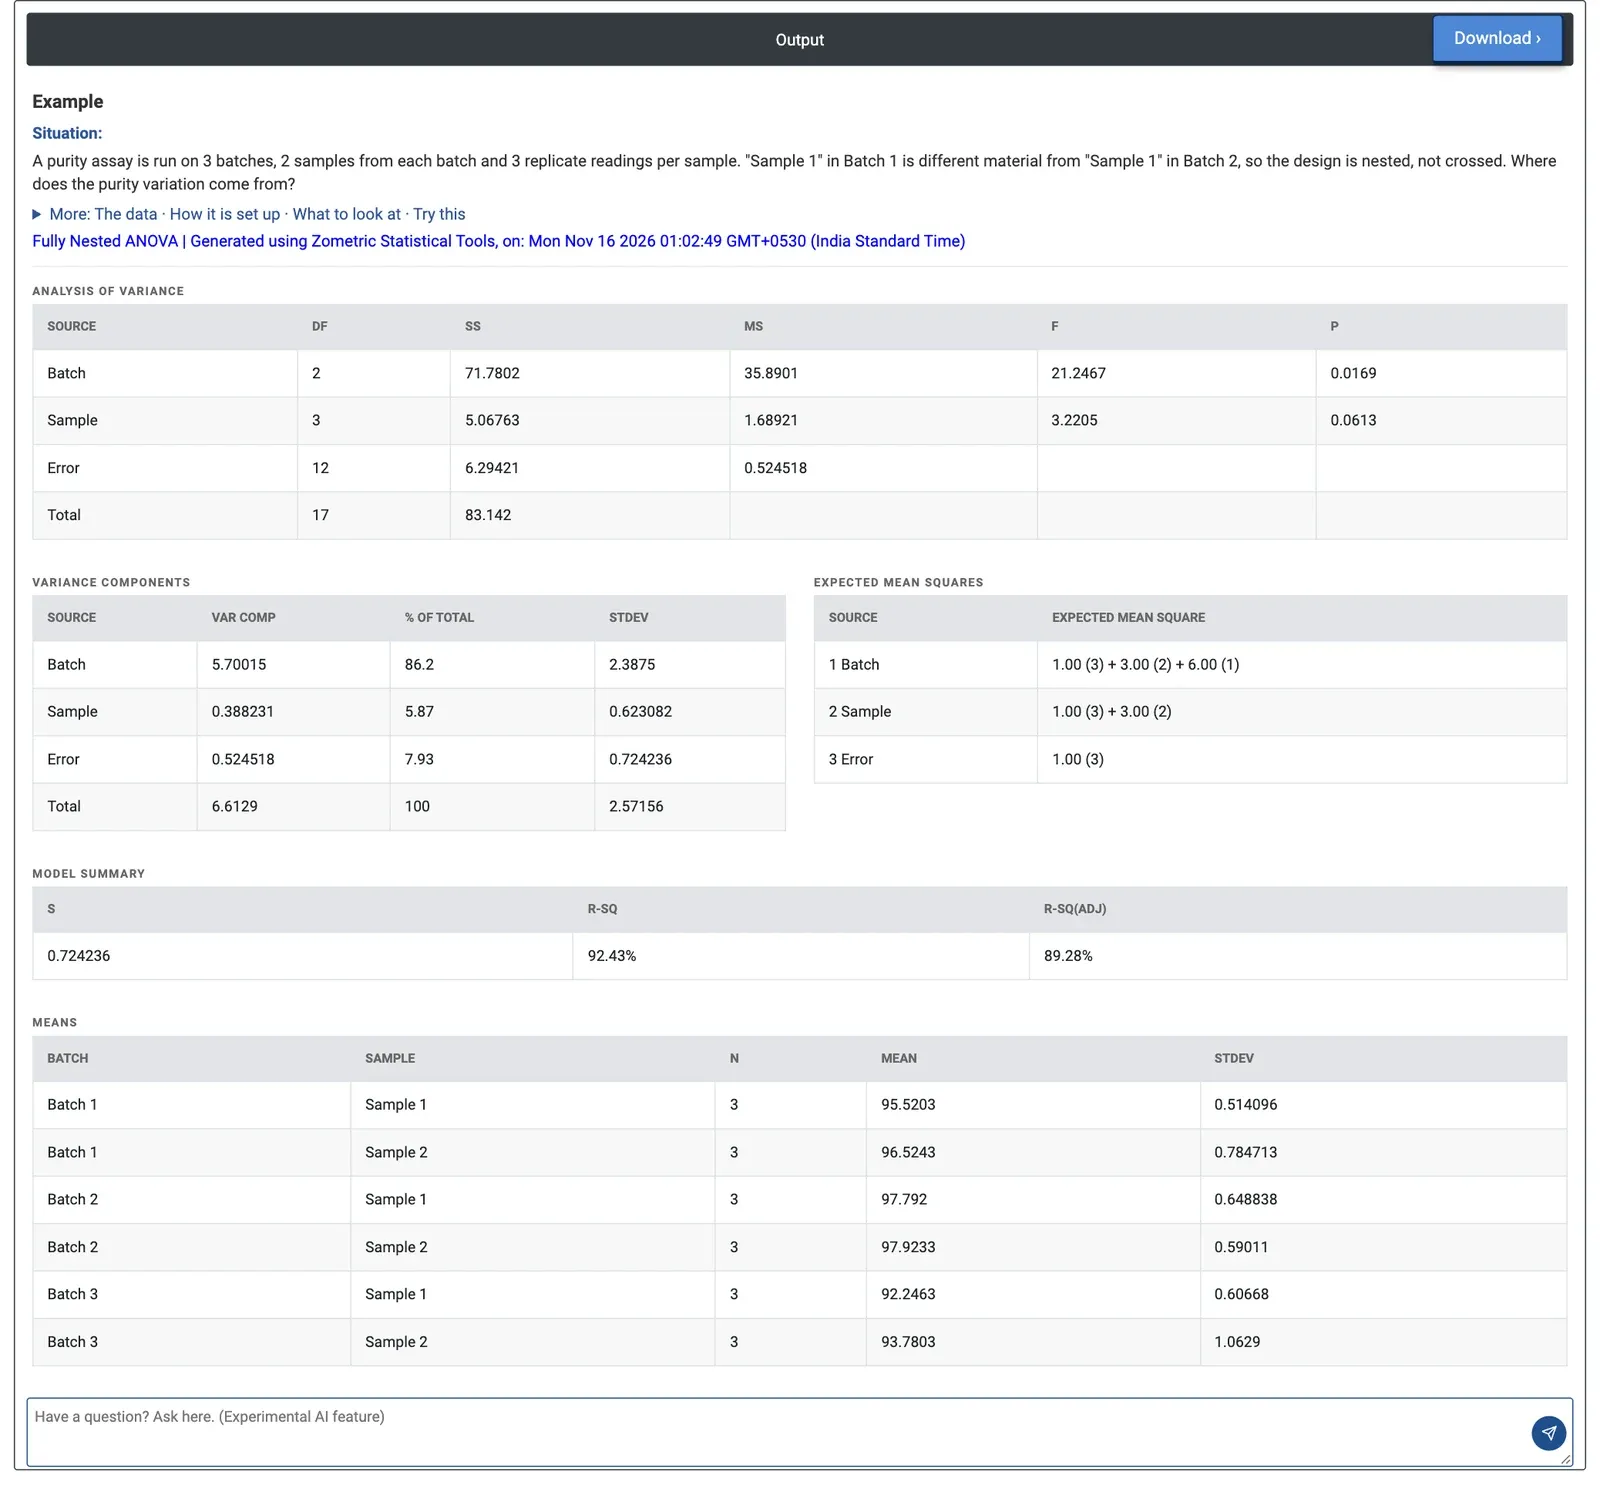
圖 2 — 純度的巢狀變異數分析:批間變異佔總量的 86.2%;批內樣品之間的變異佔 5.87%,重複讀數佔 7.93%。
計算範例
對 3 個批次進行純度檢測,每個批次取 2 個樣品,每個樣品重複讀數 3 次,共 18 個結果。品質團隊想知道純度的離散程度來自批次製程、取樣還是量測。他們選擇 Purity_pct 作為反應,Batch 作為 Factor 1,Sample 作為 Factor 2;重複讀數構成誤差。
各批次之間存在差異:F = 21.25,自由度為 2 和 3,p = 0.0169(Batch 相對於批內的 Sample 進行檢定)。批內樣品之間在 5% 水準上無顯著差異(F = 3.22,p = 0.0613)。批次 3 最低(單元平均值為 92.25% 和 93.78%),批次 2 最高(97.79% 和 97.92%)。
變異成分使情況一目瞭然:批間變異數為 5.70(佔總量的 86.2%,標準差 2.39 個百分點),樣品間變異數為 0.388(5.87%),重複讀數為 0.525(7.93%,標準差 0.72)。改善取樣或提高檢測方法的精密度不會帶來多大變化;團隊應關注批次之間的差異。
常見問題
何時應使用完全巢狀變異數分析?
當每個較低層級的單元只屬於一個較高層級的單元,例如批次 1 的樣品 1 與批次 2 的樣品 1 不是同一種物料,並且想知道大部分變異來自何處時,請使用它。這能告訴您應對製程、取樣還是量測採取措施。
完全巢狀變異數分析中如何檢定因子?
所有因子均視為隨機因子,每個因子都巢狀在前一個因子之內。每個因子相對於其內一層的因子進行檢定,最內層因子則相對於誤差進行檢定,因此 F = MS(因子) / MS(下一內層項)。僅對平衡設計給出 F 和 P;對於非平衡資料則略去,但仍會估計變異成分。
如何解讀巢狀變異數分析中的變異成分?
每個分量的 % of Total 是其佔變異數之和的份額,StDev 為其平方根。在純度範例中,批間變異數佔總量的 86.2%,批內樣品之間佔 5.87%,重複讀數佔 7.93%,因此改善取樣或提高檢測方法的精密度不會帶來多大變化,團隊應關注批次之間的差異。
完全巢狀變異數分析最多可包含多少個巢狀因子?
兩到四個巢狀因子,從最外層(如 Batch)到最內層(如 Sample)。Factor 1 和 Factor 2 為必填,Factor 3 和 Factor 4 為可選,且 Factor 4 需要有 Factor 3。最內層因子內的重複讀數構成誤差,並且對每個所選反應各做一次分析。