
一般線性模型
一般線性模型用最小平方法配適固定的分類因子、可選的雙因子交互作用和連續共變數,採用調整(Type III)或序貫平方和。當單因素變異數分析不夠用或資料不平衡時使用。它假定誤差相互獨立、服從常態分配且變異數恆定。輸出包括變異數分析表、最小平方平均值、帶 VIF 的係數、多重比較和殘差圖。
最後審閱
核心要點
一般線性模型(GLM)在一個模型中對一個或多個分類因子、它們的雙因子交互作用以及連續共變數進行變異數分析,適用於不平衡資料,也涵蓋雙因素變異數分析。
用途
一般線性模型(GLM)在一個模型中對一個或多個分類因子、它們的雙因子交互作用以及連續共變數進行變異數分析。當單因素變異數分析不夠用時使用它:例如,產量可能取決於機器、操作員、兩者的組合方式,還取決於溫度等實測條件;或者資料不平衡時。它也涵蓋經典的雙因素變異數分析。
主要功能
- 可設定任意數量的固定分類因子,並可按需加入全部雙因子交互作用。
- 連續共變數作為主效應錄入(協變異數分析)。
- 調整(Type III)或序貫(Type I)平方和;對不平衡資料給出正確的檢定。
- 各因子的最小平方平均值,已針對其他項進行調整。
- 用 Tukey、Fisher、Bonferroni、Sidak 或 Dunnett(與對照比較)對某一因子的最小平方平均值進行多重比較,附分組字母和差值的區間圖。
- 帶 VIF 的係數、含 R-sq(pred) 的模型彙總、異常觀測值和四幅殘差圖。
- Data Options:分析前對列進行子集篩選。
統計方法
模型用普通最小平方法配適。因子採用零和(−1、0、+1)編碼,因此每個係數是某一水準相對總平均值的偏離,主效應的 Type III 檢定是在其他因子各水準上取平均。任何所選欄中含遺漏值的列會被剔除。每一項以 F = Adj MS(項) / MS(Error) 及其自身的自由度和誤差自由度進行檢定;採用序貫平方和時,每一項是在排在它之前的各項之後進行檢定。Total 列是相對於平均值的總平方和,資料不平衡時,調整平方和之和不一定等於它。
S = √MS(Error)。R-sq(pred) = 1 − PRESS / SS Total,其中 PRESS 為留一法預測誤差的平方和。最小平方平均值是模型對某一因子水準的預測值,此時其他因子在其各水準上取平均,共變數取其平均值;與原始平均值不同,它不會因各組樣本數不等或共變數差異而產生偏誤。
比較使用最小平方平均值之差及其來自係數協變異數矩陣的標準誤。Tukey 對所有配對使用學生化全距分配;Fisher 使用單獨的 t 檢定;Bonferroni 和 Sidak 按配對數調整 t 臨界值;Dunnett 使用多元 t 分配將每個水準與對照比較。不包含零的區間,或不共享分組字母的平均值,表示存在顯著差異。超出 ±2 的標準化殘差標記為 R,槓桿值高於 3p/n 的標記為 X。模型假定誤差相互獨立、服從常態分配且變異數恆定:請檢查殘差圖。
輸入欄位和選項
欄位 | 說明 |
Response (Y) | 數值型反應欄。必填。 |
Factors (categorical) | 一個或多個分類預測變數欄。必填。 |
Covariates (continuous) | 可選的數值欄,僅作為主效應錄入(不與因子形成交互作用)。 |
Include all 2-way factor interactions | 預設勾選:加入每一個雙因子交互作用。 |
Confidence level | 預設值為 95;用於比較。 |
Comparison procedure | None(預設)、Tukey、Fisher、Bonferroni、Sidak 或 Dunnett (vs. a control level)。 |
Comparison factor | 比較哪個因子的最小平方平均值;選擇了比較方法時必填。 |
Control group level (Dunnett) | Dunnett 的對照水準;留空則使用第一個水準。 |
Grouping information / Interval plot for differences of means | 預設勾選:分組字母表和比較區間圖。 |
Sum of squares for tests | Adjusted (Type III,預設) 或 Sequential (Type I)。 |
Residual versus fit graph / Residual versus order graph / Histogram / Probability plot | 殘差圖;預設全部勾選。 |
Data Options: Subset (optional) | Exclude matching rows(預設)或 Include only matching rows,按列號(例如 3,7,12-15)和/或條件(例如 Temperature_C > 185)選擇。 |
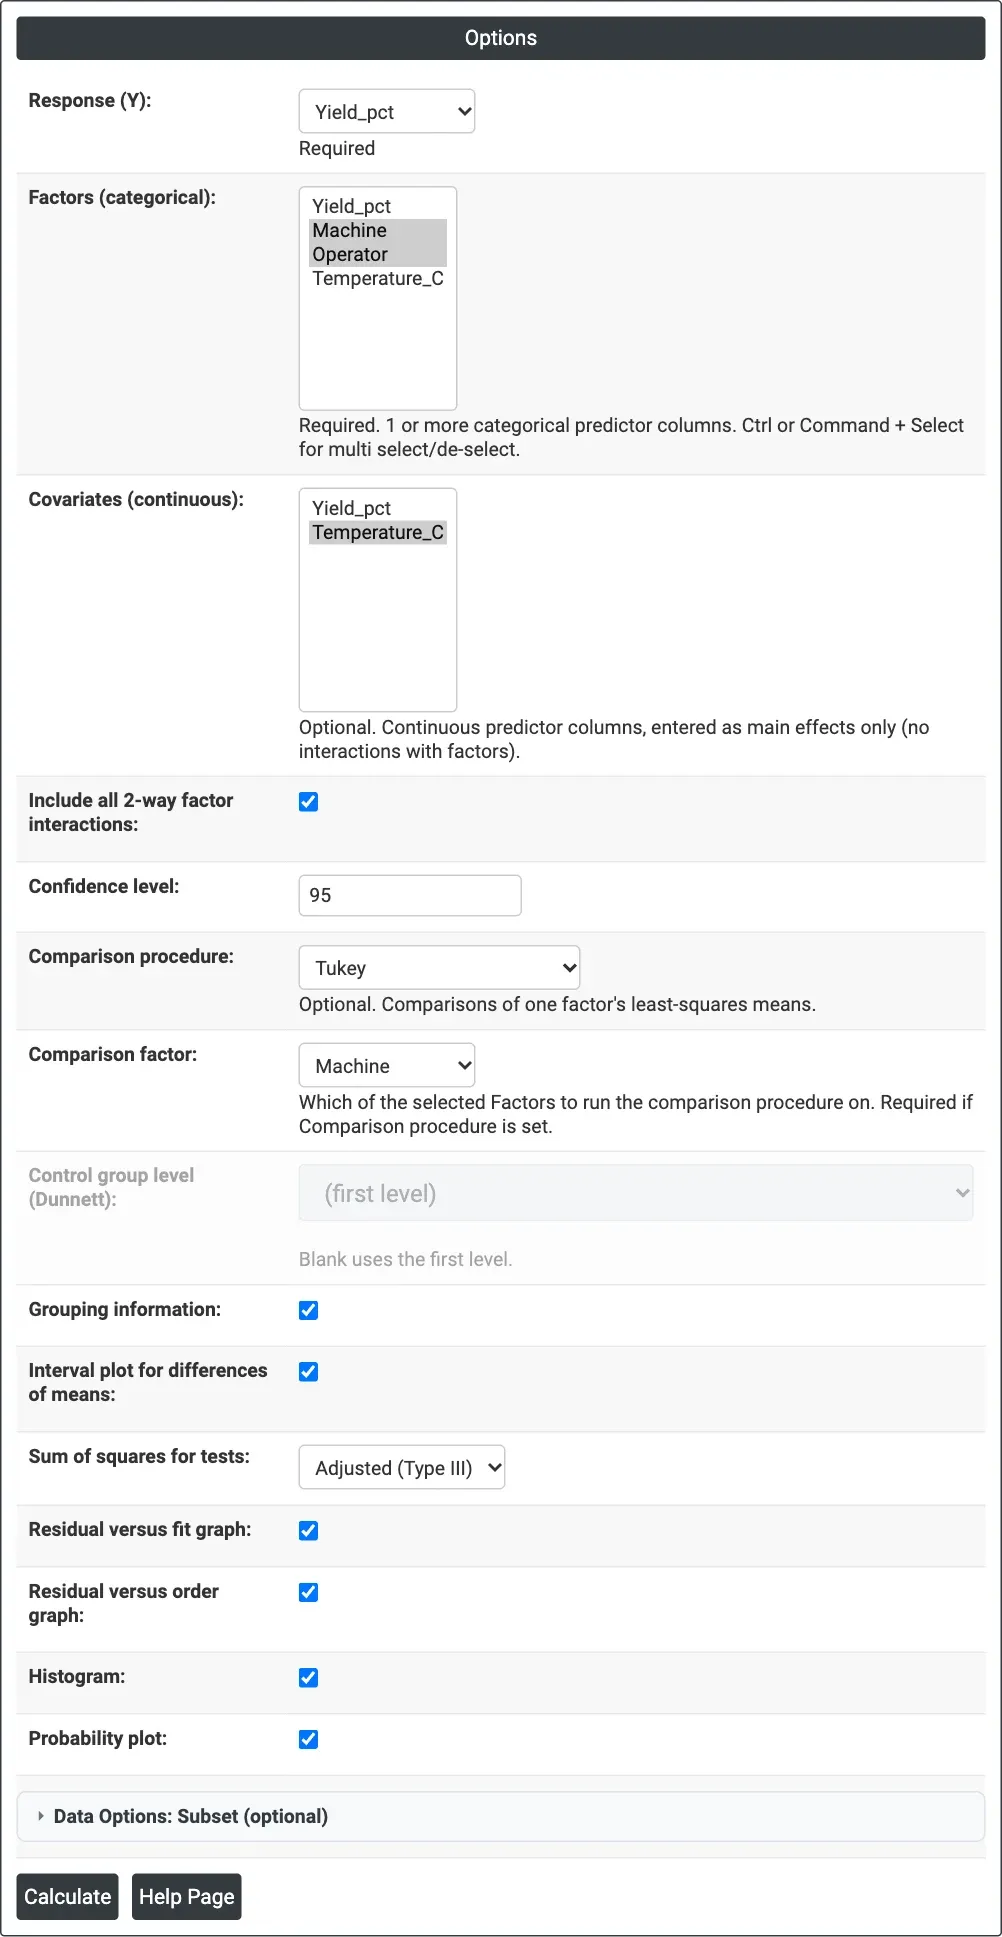
圖 1 — 產量範例的選項:反應為 Yield_pct,因子為 Machine 和 Operator 及其交互作用,共變數為 Temperature_C,並對機器進行 Tukey 比較。
輸出說明
- Method — 因子編碼和平方和類型。
- Factor Information — 每個因子的類型、水準數和各水準的取值。
- Analysis of Variance — 每一項、誤差和總計的 DF、Adj SS(或 Seq SS)、Adj MS、F-Value 和 P-Value。
- Model Summary — S、R-sq、R-sq(adj) 和 R-sq(pred)。
- Least-Squares Means — 每個因子各水準的 N 和 LS mean。
- Coefficients — Coef、SE Coef、T-Value、P-Value 和 VIF。
- Fits and Diagnostics for Unusual Observations — 僅在存在異常觀測值時顯示。
- Grouping Information、Simultaneous (or Individual) Tests for Differences of Means 和區間圖 — 選擇了比較方法時顯示。
- Versus Fit、Versus Order、Residuals Histogram 和 Probability Plot。
- 透過 Download 匯出 PDF。
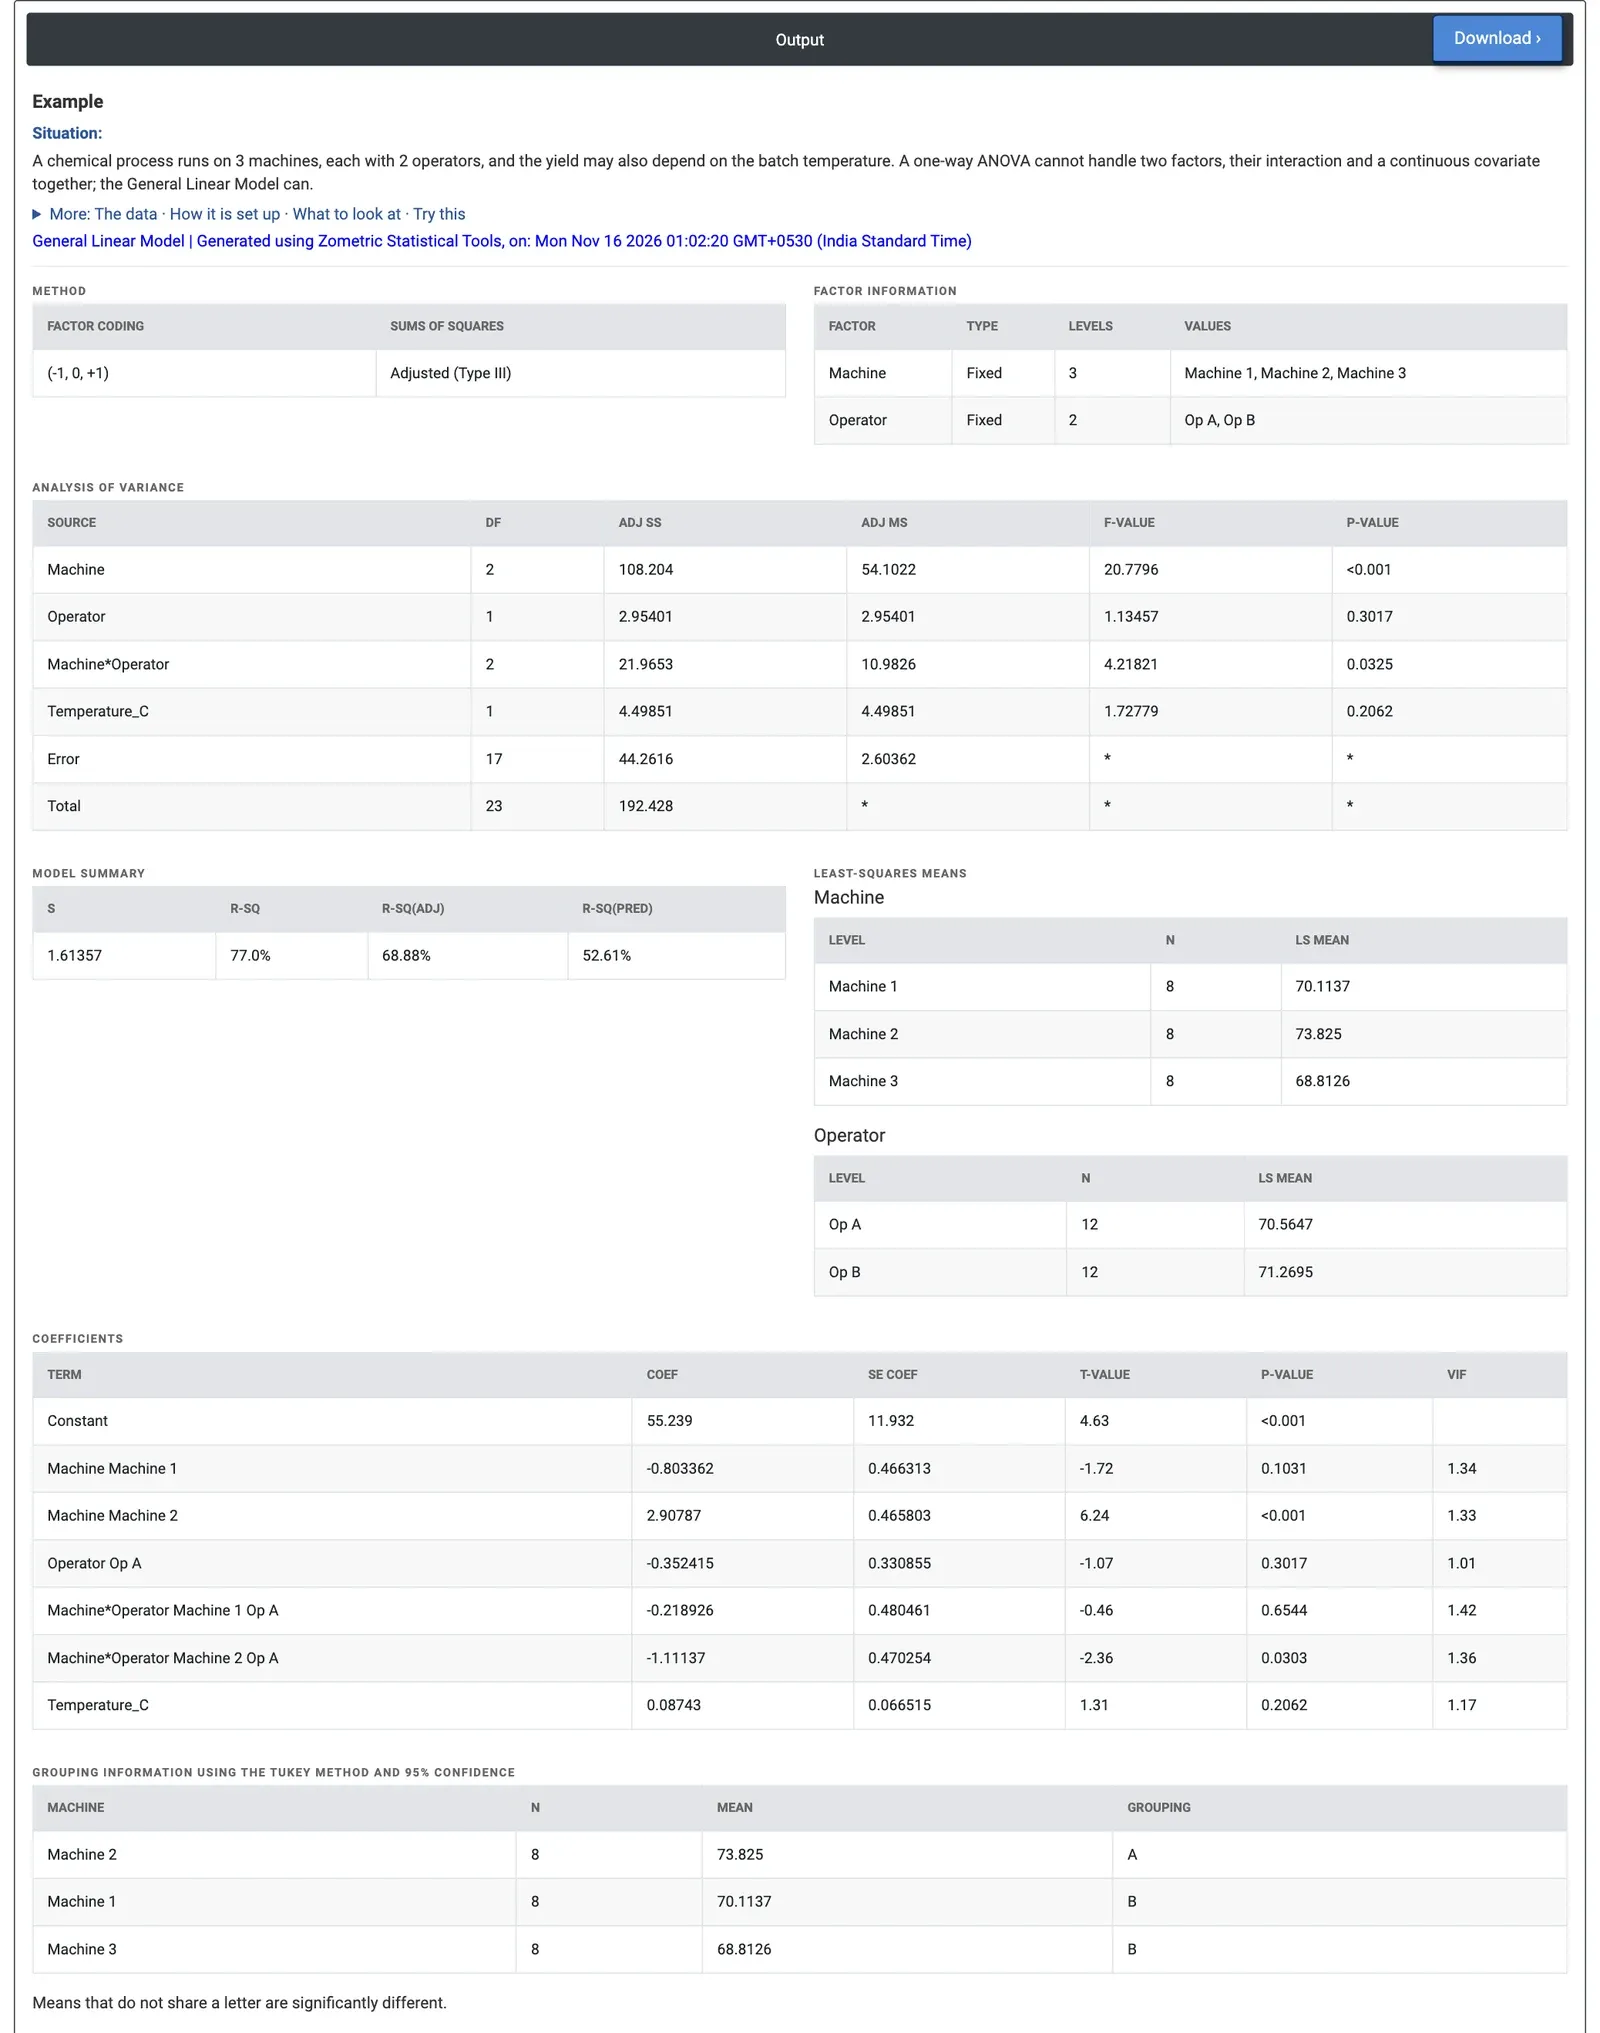
圖 2 — 產量的 GLM 結果:Machine 顯著(p < 0.001),Machine*Operator 交互作用也顯著(p = 0.0325);Machine 2 的 LS mean 最高,為 73.83%。
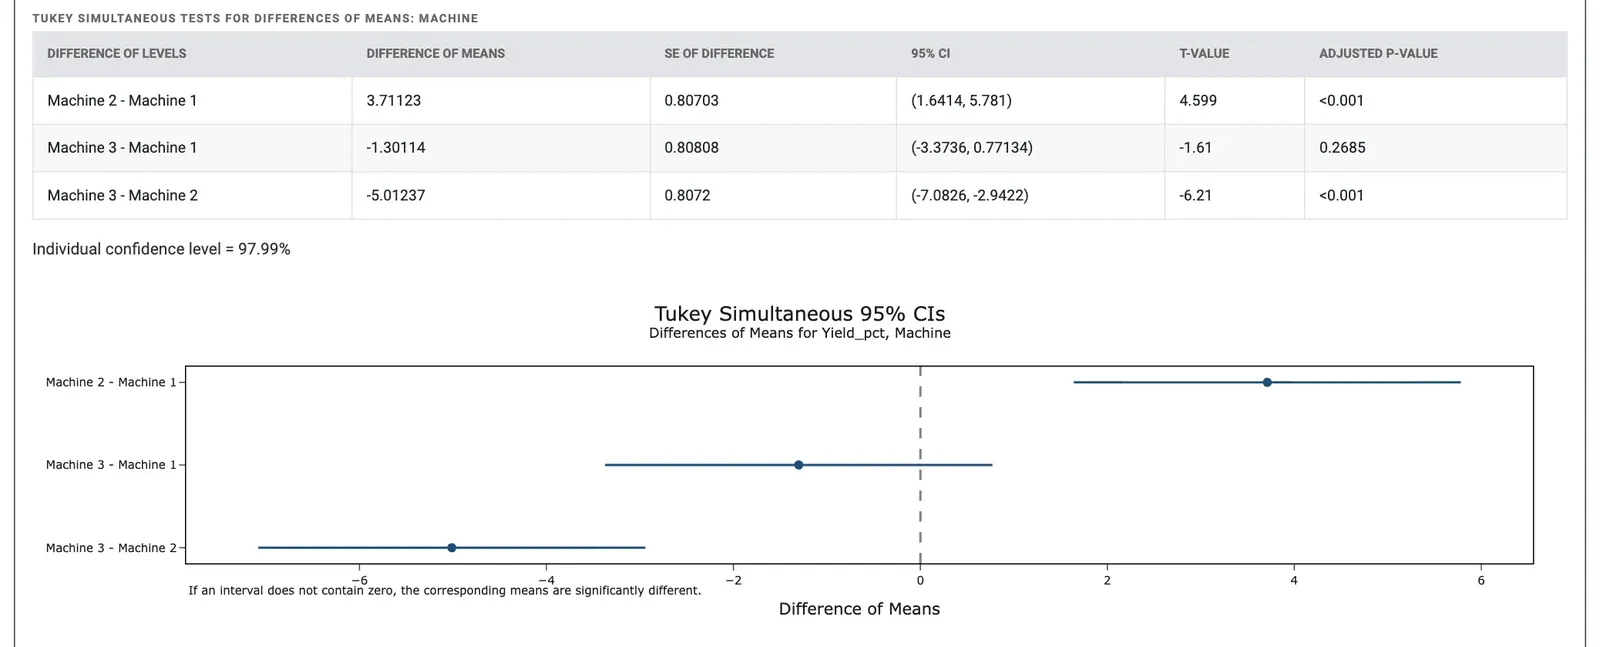
圖 3 — 機器的 Tukey 比較:Machine 2 與另外兩臺均有差異;Machine 3 − Machine 1 的區間包含零。
計算範例
某化學製程在三臺機器上執行,每臺有兩名操作員(Op A 和 Op B),批次產量還可能取決於批次溫度(170 至 190 °C)。共有 24 個批次,每臺機器、每名操作員各四個。工程師選擇 Yield_pct 作為反應,Machine 和 Operator 作為因子並包含其交互作用,Temperature_C 作為共變數,並要求對機器進行 Tukey 比較。
各機器之間有明顯差異(F = 20.78,p < 0.001)。Machine*Operator 交互作用也顯著(F = 4.22,p = 0.0325):Op B 在 Machine 1 和 2 上產量更高,在 Machine 3 上則更低。在所研究的範圍內,操作員本身(p = 0.3017)和溫度(p = 0.2062)均無顯著影響。模型解釋了 77.0% 的變異(R-sq(adj) 為 68.88%),S = 1.61 個百分點;R-sq(pred) 較低,為 52.61%,因此對新批次的預測精度會低於配適所顯示的水準。
最小平方平均值為:Machine 2 為 73.83%,Machine 1 為 70.11%,Machine 3 為 68.81%。Tukey 將 Machine 2 單獨劃入 A 組:其產量比 Machine 1 高 3.71 個百分點(95% 信賴區間為 1.64 至 5.78),比 Machine 3 高 5.01 個百分點,兩者的調整後 p 均 < 0.001,而 Machine 1 與 3 之間沒有差異(調整後 p = 0.2685)。工程師研究 Machine 2 有何不同,並且由於存在交互作用,在統一方法之前先考察 Machine 3 上的操作員搭配。
常見問題
什麼時候應使用一般線性模型而不是單因素變異數分析?
當單因素變異數分析不夠用時使用一般線性模型,例如產量可能取決於機器、操作員、兩者的組合方式以及溫度等實測條件,或者資料不平衡時。它在一個模型中處理多個分類因子、雙因子交互作用和連續共變數,也涵蓋經典的雙因素變異數分析。
GLM 中的最小平方平均值是什麼?
最小平方平均值是模型對某一因子水準的預測值,此時其他因子在其各水準上取平均,共變數保持在其平均值。與原始平均值不同,它不會因各組樣本數不等或共變數差異而產生偏誤。GLM 中的多重比較就是比較某一因子各水準之間的這些最小平方平均值。
GLM 中應使用哪種多重比較方法?
Tukey 使用學生化全距分配比較所有配對;Fisher 使用單獨的 t 檢定;Bonferroni 和 Sidak 按配對數調整 t 臨界值;Dunnett 將每個水準與對照比較。不包含零的區間,或不共享分組字母的平均值,表示存在顯著差異。
一般線性模型的假設是什麼?
模型假定誤差相互獨立、服從常態分配且變異數恆定,可通過殘差圖來檢查:殘差對配適值、殘差對順序、直方圖和機率圖。超出正負 2 的標準化殘差標記為 R,槓桿值高於 3p/n 的觀測值標記為 X,視為異常觀測值。