
廣義變異數 |S| 管制圖
廣義變異數 |S| 管制圖追蹤兩個或多個相關變數的聯合離散程度,是對監控平均值的 Hotelling T² 和 MEWMA 管制圖的補充。它需要一個子群組欄,且各子群組大小 n 相等並大於變數個數。它為每個子群組繪製 |S|,採用固定的 3 西格瑪等效管制界限,並根據 Rule 1 標出高於 UCL 的子群組。
最後審閱
核心要點
廣義變異數 |S| 管制圖透過繪製每個子群組協變異數矩陣的行列式,監控兩個或多個相關變數的聯合離散程度,發現基於平均值的管制圖無法捕捉的變異變化。
用途
廣義變異數管制圖聯合監控兩個或多個相關變數的離散程度,是對 Hotelling T² 和 MEWMA 管制圖的補充,後者監控聯合平均值是否發生偏移。製程可以始終完全對準目標,同時變得更不穩定——其變異數/協變異數結構變大——而 T² 或 MEWMA 管制圖卻從未發出訊號。廣義變異數管制圖追蹤子群組樣本協變異數矩陣的行列式 |S|,專門用於捕捉這種情況。
主要功能
- 追蹤 2 個或更多相關變數在各子群組間的聯合離散程度(協變異數矩陣的行列式),發現基於平均值的管制圖無法檢測到的多元變異的增大或減小。
- 需要一個 Subgroup indicator 欄,每個子群組須有相同的重複次數 n,且 n 必須大於所選變數的個數(以便子群組協變異數矩陣可以估計)。
- Rule 1(一個點高於 UCL)特殊原因檢測,K 常數可配置。
統計方法
對每個子群組 i(有 n 個重複列和 p 個所選變數,n > p,且每個子群組的 n 相同),工具計算該子群組自身的樣本協變異數矩陣,並將其行列式 |S_i|——即「廣義變異數」——繪製出來,作為該子群組整體多元離散程度的單一純量彙總。|S_i| 越大,表示在該特定子群組內 p 個變數的變動越大(單一變數的變動和/或它們相關性的變化)。
合併協變異數矩陣 S̄(全部 m 個組內協變異數矩陣的平均值,或來自指定基線子群組集的協變異數矩陣)給出 Σ̂ = det(S̄),即受控狀態下廣義變異數的估計值。根據 n 和 p 計算兩個偏誤/變異數修正常數:b1 = [1/(n−1)^p] · Π_{i=1..p}(n−i),以及 b2 = [1/(n−1)^(2p)] · Π_{i=1..p}(n−i) · [Π_{j=1..p}(n−j+2) − Π_{j=1..p}(n−j)]——這是 |S| 抽樣分配的標準矩常數(Montgomery,Introduction to Statistical Quality Control)。
該管制圖採用固定的 3 西格瑪等效管制界限(此管制圖沒有 alpha 輸入):CL = b1·Σ̂,UCL = Σ̂·(b1 + 3√b2),LCL = max(0, Σ̂·(b1 − 3√b2))。
僅評估 Rule 1——|S_i| 超過 UCL 的子群組會被標出,表示聯合變異相對於製程其餘部分異常大;Rule 1 的預設 K 為 3。
輸入欄位和選項
欄位 | 說明 |
Variables | 必填。選擇每個觀測上測得的 2 個或更多相關變數。 |
Subgroup indicator | 必填。標示每列所屬子群組的欄——每個子群組必須有相同數量的重複列(n),且 n 必須大於所選變數的個數。 |
Check Rule 1 / K for Rule 1 | 1 個點高於 UCL;預設勾選,K = 3。 |
X scale | 子群組軸的可選自訂標註。 |
Include or Exclude / Specify which rows / Row numbers | 控制繪製哪些子群組。 |
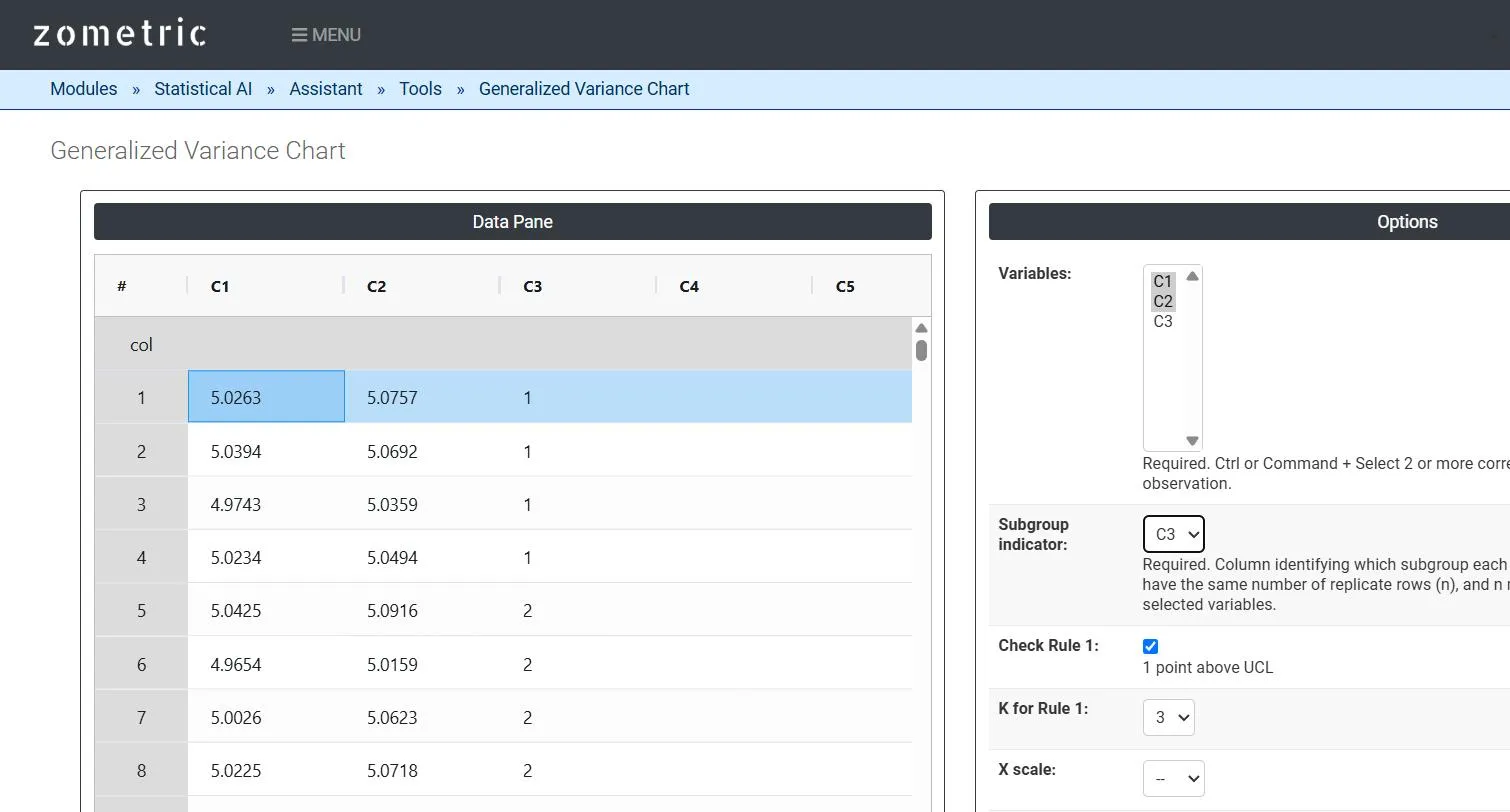
圖 1 — 15 個子群組(每組 4 個,C3)共 60 列成對的銷/孔徑讀數(C1–C2),Variables = C1、C2,Subgroup indicator = C3。
輸出說明
- Generalized Variance |S| Chart plot — 每個子群組樣本協變異數矩陣的行列式,按子群組順序繪製,帶有 UCL、中心線和 LCL。
- 根據 Rule 1 其 |S| 超過 UCL 的任何子群組會直接在圖上突出顯示。
- 透過 Download as PDF 匯出 PDF。
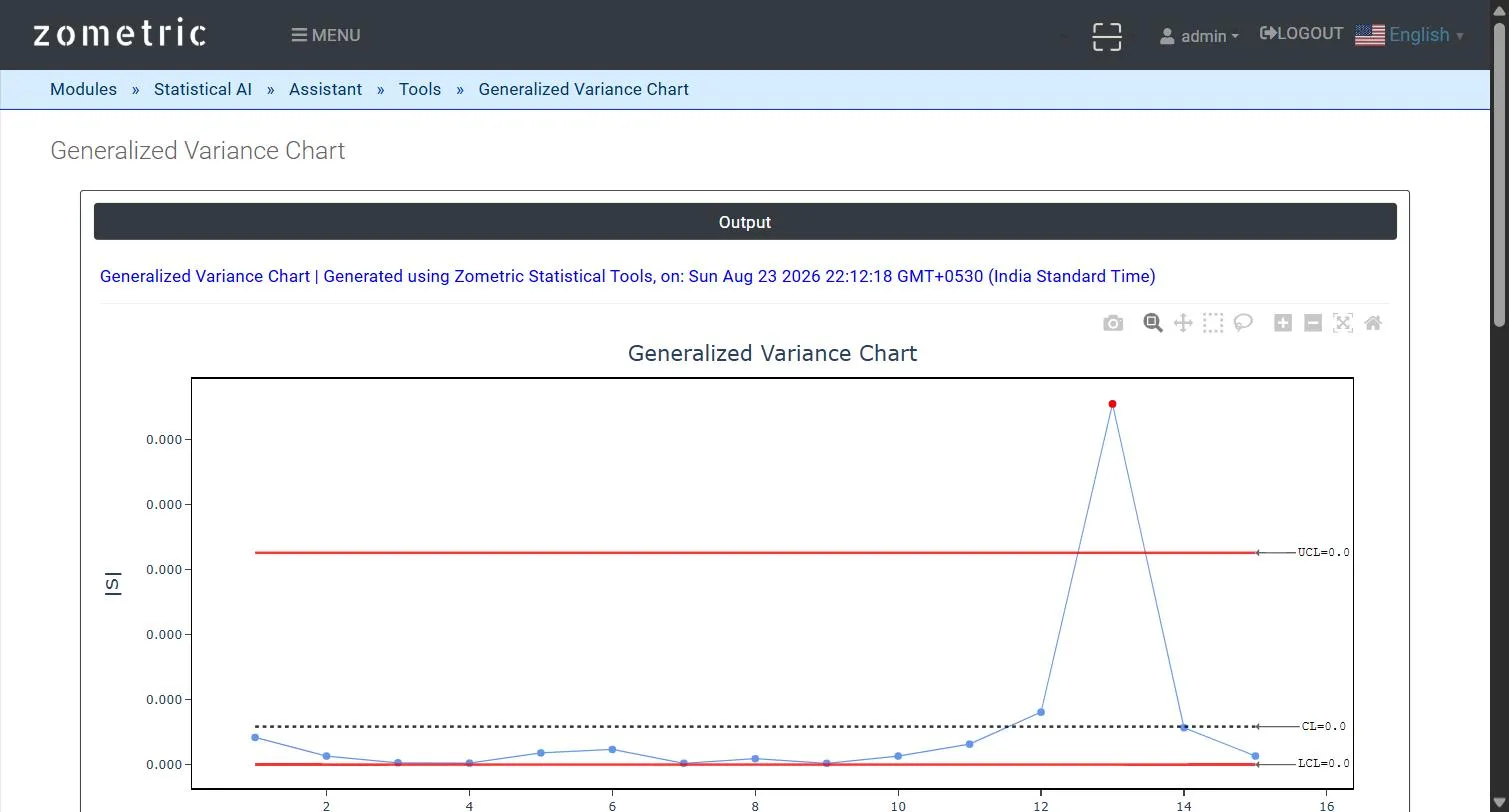
圖 2 — 廣義變異數 |S| 管制圖輸出:每個子群組的 |S| 及 UCL/CL/LCL,變異增大的子群組以紅色標出。
計算範例
某壓配裝配取決於銷直徑(C1,mm)和孔直徑(C2,mm)的聯合變異,在 15 個子群組(C3)中每個子群組量測 4 個零件。前 11 個子群組取自緊密、穩定的協變異數結構,而最後 4 個子群組的變異數/協變異數在示範資料集中被有意放大(各自的平均值始終保持在目標上)。所得管制圖在子群組 11 之前保持穩定且受控,隨後子群組 13 急劇升至 UCL 之上,並根據 Rule 1 標為紅色——捕捉到了僅監控平均值的 T² 或 MEWMA 管制圖都無法檢測到的離散程度增大。
常見問題
廣義變異數管制圖監控什麼?
它透過繪製 |S|(每個子群組樣本協變異數矩陣的行列式),聯合監控兩個或多個相關變數的離散程度。|S| 越大,表示在該子群組內變數的變動越大,無論是單一變數的變動還是它們相關性的變化。它能發現對準目標但變得更不穩定的製程。
廣義變異數管制圖與 Hotelling T² 管制圖有何不同?
Hotelling T² 和 MEWMA 管制圖監控聯合平均值是否發生偏移。製程可以保持居中,同時其變異數和協變異數結構變大,而 T² 或 MEWMA 管制圖不發出訊號。廣義變異數管制圖透過追蹤聯合離散程度而非平均值,對它們形成補充。
廣義變異數管制圖需要多大的子群組大小?
每個子群組必須有相同數量的重複列 n,且 n 必須大於所選變數的個數,以便估計子群組協變異數矩陣。在範例中,15 個子群組中每個子群組量測了 4 個零件的銷直徑和孔直徑。
廣義變異數管制圖的管制界限如何設定?
來自所有子群組或基線集的合併協變異數矩陣,給出受控狀態下廣義變異數的估計值。根據 n 和 p 計算兩個修正常數 b1 和 b2。該管制圖採用固定的 3 西格瑪等效管制界限,沒有 alpha 輸入,且僅評估 Rule 1,即一個點高於 UCL,預設 K 為 3。