
多重對應分析
多重對應分析繪製三個或更多分類變數(如調查答案或缺陷記錄)的所有類別,使相關的類別彼此靠近。恰好兩個變數時,請使用簡單對應分析。含遺漏值的列將被剔除。輸出包括每個維度的慣量表、含品質、座標、Quality 和貢獻的類別表,以及前兩個維度的圖。
最後審閱
核心要點
多重對應分析(MCA)將三個或更多分類變數的每個類別置於同一張圖上,因此經常同時出現的類別(如客戶類型、通路和套餐)會彼此靠近。
用途
多重對應分析(MCA)將三個或更多分類變數的每個類別置於同一張圖上。經常由相同受訪者給出或出現在相同項目上的類別彼此靠近。可用它探索含有多個分類欄位的調查答案、缺陷記錄或稽核發現,例如檢視哪些客戶類型對應哪些通路和服務套餐,或哪些班次、生產線和缺陷類型傾向於同時出現。恰好兩個變數時,請使用簡單對應分析。
主要功能
- 一次分析三個或更多分類欄;每個類別在圖上成為一個點。
- 每個維度的慣量表,含百分比和累計百分比。
- 類別表,針對您所選的維度數,給出 Mass、慣量、座標、Quality、平方相關和貢獻。
- 所有類別在前兩個維度上的欄圖,按變數著色。
- 結果的 PDF 匯出。
統計方法
任一所選變數存在遺漏值的列將被剔除,且每個值都被視為類別標籤。資料被轉換為指示矩陣 Z,每個變數的每個類別對應一個 0/1 欄(J 個變數共 K 欄)。MCA 是對該矩陣進行的對應分析:Z 除以其總和得到比例 P,並得到列品質 r 和欄(類別)品質 c,標準化殘差 S = Dr^−½ (P − r cᵀ) Dc^−½ 透過奇異值分解進行分解。每個奇異值 d 對應一個維度,其慣量為 d²。共有 K − J 個維度,總慣量始終為 (K − J) / J,因此它只取決於類別數,而與資料無關。
類別座標為主座標 Dc^−½ V D。Mass 是類別佔指示矩陣總和的份額,即其相對頻率除以 J。Inert 是該類別佔總慣量的份額。Quality 是所報告的維度所顯示的、類別到中心的平方距離所佔的份額(0 到 1);Corr 是單一維度上的該份額,Contr 是該類別在某一維度的慣量中所佔的份額。由於指示矩陣編碼將慣量分散到許多維度上,MCA 中前兩個維度所解釋的百分比通常遠小於簡單對應分析;該圖仍然有用,但 Quality 低的類別未能得到很好的顯示。
輸入欄位和選項
欄位 | 說明 |
Categorical variables | 三個或更多分類欄。按住 Ctrl 或 Command 可選擇多欄。恰好 2 個變數時,請改用簡單對應分析。 |
Number of components | 在類別表中為多少個維度報告 Quality、Corr 和 Contr。預設為 2;範圍 1 至 20,受可用數量限制。圖始終顯示前 2 個。 |
Title | 顯示在圖上的標題。預設為 Multiple Correspondence Analysis。 |
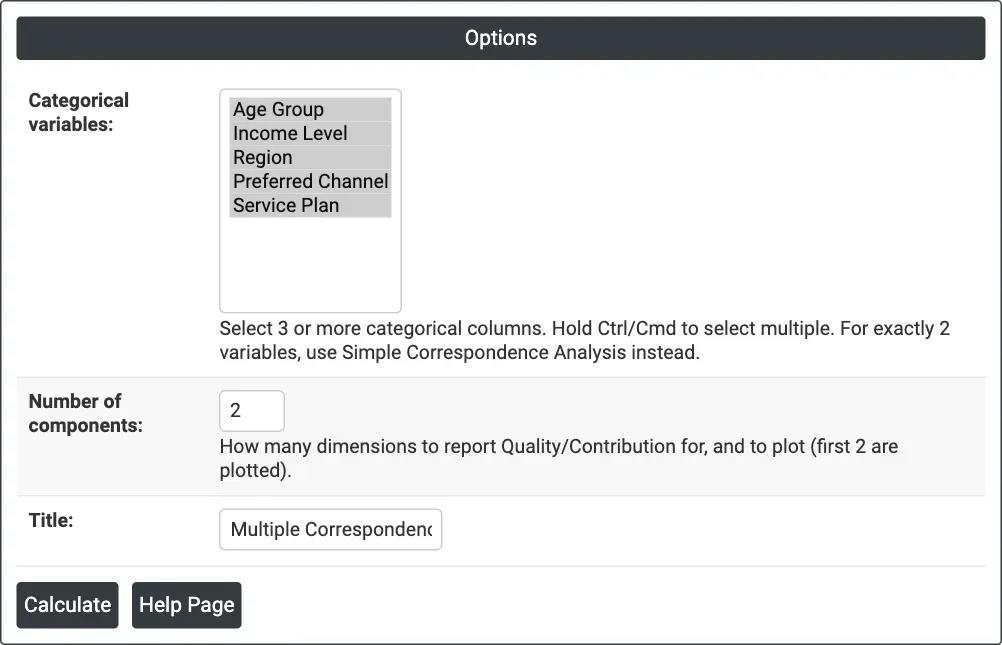
圖 1 — 範例的選項:五個調查問題作為分類變數,2 個成分。
輸出說明
- Multiple Correspondence Analysis plot——每個類別在 Dimension 1 對 Dimension 2 上的位置(座標軸標題中為慣量百分比),按變數著色。每個點標有其類別;顏色和圖例給出變數,懸停時兩者均會顯示。標籤的放置會避免重疊。
- Total inertia——總慣量和維度數。
- Analysis of Indicator Matrix——每個維度的 Component (Dim1, Dim2, ...)、Inertia、Percent 和 Cumulative Percent。
- Column Contributions——Category、Variable、Mass、Inert、每個所報告維度上的座標、Quality,以及每個所報告維度的 Corr 和 Contr。
- 透過 Download 匯出 PDF。
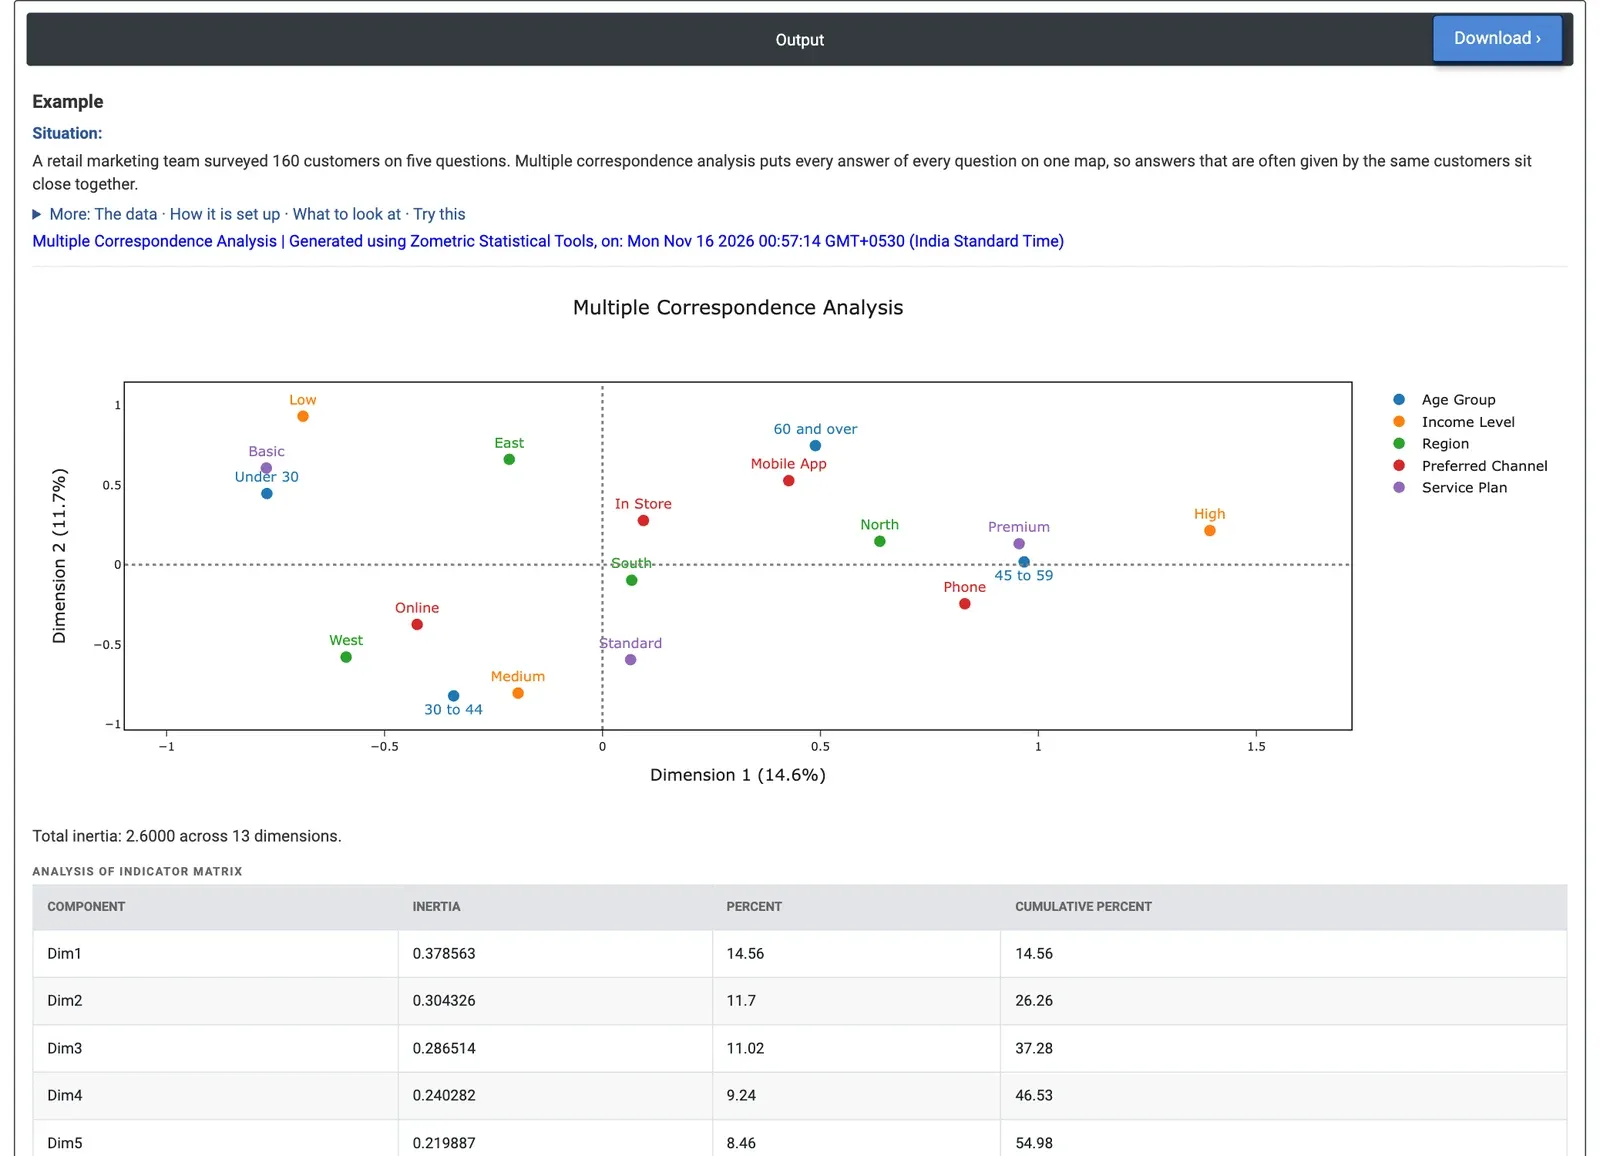
圖 2 — 160 位客戶的五個調查問題的類別圖:Dimension 1(14.6%)從低收入、Basic 套餐和 30 歲以下,延伸到高收入、Premium 套餐和 45 至 59 歲。
計算範例
某零售行銷團隊就五個問題對 160 位客戶進行了調查:年齡組(四組)、收入水準(Low、Medium、High)、地區(North、South、East、West)、偏好通路(Online、In Store、Mobile App、Phone)和服務套餐(Basic、Standard、Premium)。他們想了解哪些答案傾向於同時出現,以便規劃有針對性的優惠。他們選擇全部五欄作為 Categorical variables,並保持 Number of components = 2。
18 個類別產生 13 個維度,總慣量為 2.6。Dimension 1 解釋 14.56%,Dimension 2 解釋 11.7%,合計 26.26%:對於類別數這麼多的 MCA 屬正常情況,但應將該圖視為粗略的概括。Dimension 1 左側為 Income Level: Low (−0.687)、Service Plan: Basic (−0.771) 和 Age Group: Under 30 (−0.770),右側為 Income Level: High (1.393)、Service Plan: Premium (0.956) 和 Age Group: 45 to 59 (0.967)。Income Level: High 貢獻了 Dimension 1 慣量的 23.1%,是所有類別中最多的。在 Dimension 2 上,Income Level: Medium (−0.804)、Age Group: 30 to 44 (−0.821) 和 Service Plan: Standard (−0.595) 一起位於底部。
Region: South(Quality 0.0054)和 Preferred Channel: In Store(0.0475)位於中心附近,Quality 極低:它們在該圖上顯示不佳,不屬於任何一組。對團隊而言,收入水準和服務套餐構成主要模式,年齡緊隨其後,而地區和通路的貢獻很小。在原始資料中,60.4% 的低收入客戶選擇了 Basic,52.8% 的高收入客戶選擇了 Premium。從分析中去掉 Region 後,前兩個維度的佔比升至 32.57%。
常見問題
什麼是多重對應分析?
多重對應分析(MCA)將三個或更多分類變數的每個類別置於同一張圖上,經常由相同受訪者給出或出現在相同項目上的類別彼此靠近。它用於探索調查答案、缺陷記錄或稽核發現,例如哪些班次、生產線和缺陷類型傾向於同時出現。
MCA 與簡單對應分析有何區別?
簡單對應分析僅適用於恰好兩個分類變數,而 MCA 可處理三個或更多。MCA 分析的是每個類別對應一個 0/1 欄的指示矩陣。由於這種編碼將慣量分散到許多維度上,MCA 中前兩個維度所解釋的百分比通常遠小於簡單對應分析。
如何解讀 MCA 圖?
圖上彼此靠近的類別傾向於同時出現。座標軸上的百分比表示每個維度所解釋的慣量份額。檢查每個類別的 Quality(0 到 1):Quality 低的類別通常位於中心附近,在圖上顯示不佳,不應解讀為屬於任何一組。Contr 顯示哪些類別定義了每個維度。
為什麼 MCA 中解釋的慣量如此之低?
MCA 的總慣量始終為 (K - J) / J,其中 K 是類別數,J 是變數數,因此它只取決於類別數。指示矩陣編碼將這些慣量分散到許多維度上,所以前兩個維度的百分比較低屬正常現象;應將該圖視為粗略的概括。