
多變數製程能力(非常態)
當資料偏斜(如粒徑、平面度或雜質)時,該工具將兩欄或更多欄相對於同一規格的能力進行比較。它對每一欄配適從十五種模型(包括 Weibull、Lognormal、Box-Cox 和 Johnson)中選定的同一個模型,採用 Z-Score 或 ISO 方法。每欄至少需要 4 個值。輸出為包含 Pp、PPL、PPU、Ppk 和 PPM 的表格,以及直方圖。
最後審閱
核心要點
多變數製程能力(非常態)在資料非常態時,將多個製程與同一規格進行比較,對每個製程配適相同的分配,並並排列出 Pp、Ppk 和 PPM。
用途
多變數製程能力(非常態)在資料不服從常態分配時,將多個製程、產線、機器或模穴的能力與同一規格進行比較。它對每一欄分別配適相同的分配,並將 Pp、PPL、PPU、Ppk 以及期望和觀測的每百萬件超規格數並排放入一張表中,同時為每一欄提供一個直方圖。適用於粒徑、平面度、跳動或雜質等偏斜特性,對於這類特性,基於常態分配的 Ppk 會誤判分配尾部,而您希望對各製程進行排序。
主要功能
- 兩欄或更多欄,每欄作為各自的製程,獨立配適。
- 十五種模型:Weibull、Exponential、Logistic、Loglogistic、Largest 和 Smallest Extreme Value、2-Parameter Exponential、3-Parameter Weibull、Gamma、Lognormal、3-Parameter Lognormal、3-Parameter LogLogistic、Box-Cox 和 Johnson 轉換,以及 Mixed Distribution (ISO 22514-2)。
- 指數採用 Z-Score 或 ISO 百分位數方法。
- 單側或雙側規格適用於每一欄。
- 比較表含 Pp、PPL、PPU、Ppk、PPM Expected 和 PPM Observed,以及每欄帶規格界限和配適曲線的直方圖。
統計方法
對每一欄,所選分配用最大概似法配適(Weibull、Gamma 和 Exponential 的閾值固定為 0;3 參數模型則估計閾值)。Lognormal 使用對數資料的平均值和標準差。Box-Cox 和 Johnson 將資料轉換為常態,並在轉換後的尺度上計算;Mixed Distribution 配適常態分配的混合,成分數除非固定,否則按 BIC 選擇。每欄至少需要 4 個值。
Z-Score 方法(預設):將各規格界限之外的配適機率轉換為常態分數,Z_USL = Φ⁻¹(F(USL)) 和 Z_LSL = Φ⁻¹(F(LSL)),其中 F 為配適的累積分配。然後 PPU = Z_USL / 3,PPL = −Z_LSL / 3,Pp = (Z_USL − Z_LSL) / 6,Ppk = min(PPL, PPU)。ISO 方法:指數使用配適的百分位數 X₀.₁₃₅、X₅₀ 和 X₉₉.₈₆₅(與常態分配 ±3σ 覆蓋相同比例的點):Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅),PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅),PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀)。僅有一個規格界限時,不給出 Pp,Ppk 為單側指數。
PPM Expected 是配適的總體中超出規格界限的比例乘以 1,000,000;PPM Observed 是樣本值中超出規格界限的比例。這些是基於全部資料的整體(長期)指數。它們的好壞取決於所用的分配:同一個模型應用於每一欄,因此在比較各欄之前,應先檢查每一欄的配適情況(例如使用個別值分配識別)。
輸入欄位和選項
欄位 | 說明 |
Process variables | 必填。要比較的兩個或更多數值型欄;每欄單獨配適。 |
Fit distribution | 必填。上面列出的十五種模型之一(預設為 Weibull),應用於每一欄。 |
Mixture components | 僅適用於 Mixed Distribution (ISO 22514-2):Auto(按 BIC 選擇,預設)或 2 至 6 個成分。 |
Method of analysis | Z-Score(預設)或 ISO。 |
LSL / USL | 適用於每一欄的規格界限;至少需要一個,且 LSL 必須低於 USL。 |
Company name / Report title | 報告的可選文字;預設標題為 Multiple Variables Process Capability (Nonnormal)。 |
Data Options: Subset (optional) | Exclude matching rows(預設)或 Include only matching rows,按列號(例如 3,7,12-15)和/或條件選擇。 |
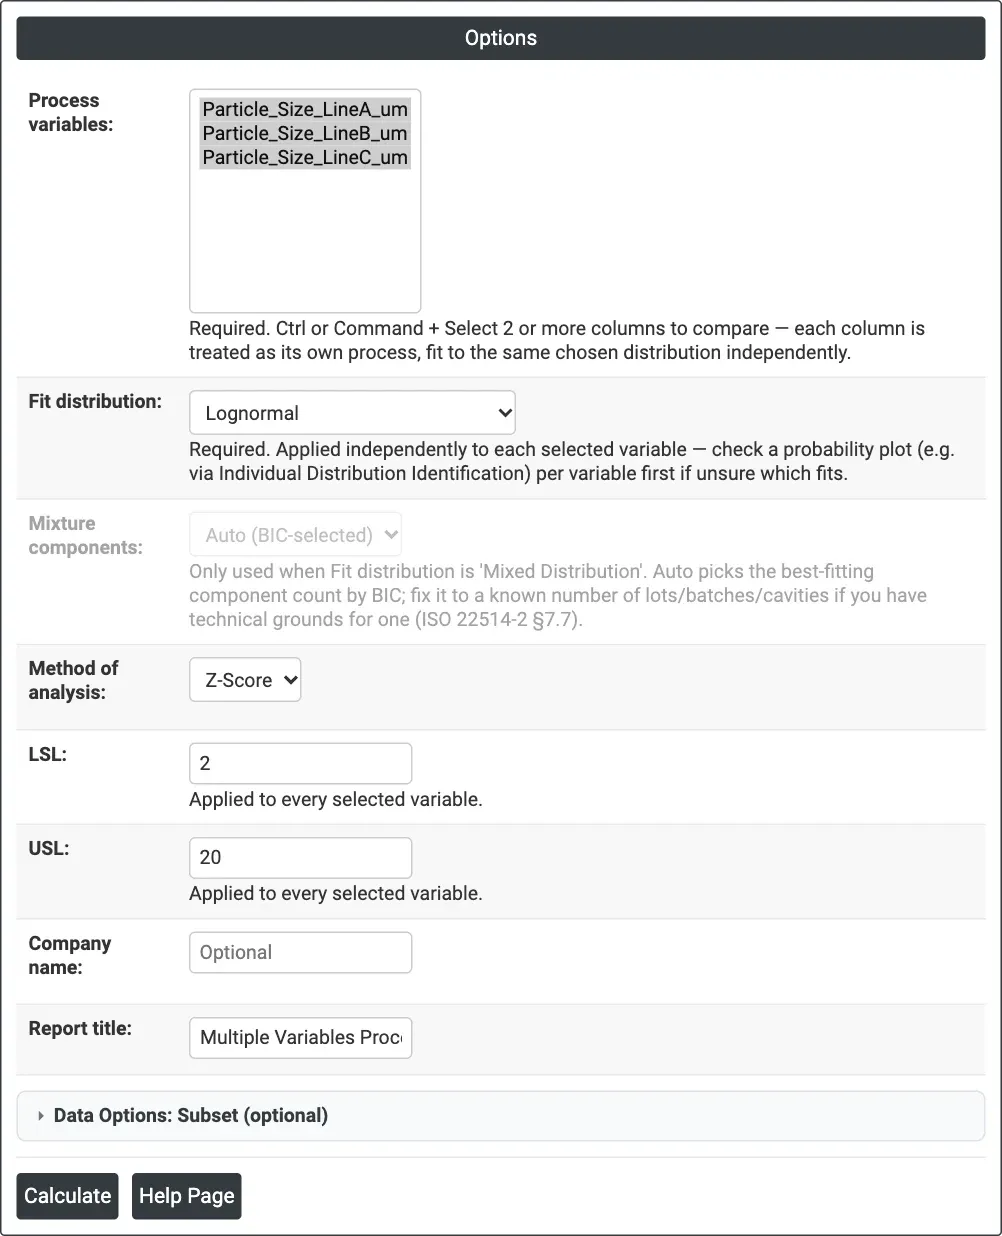
圖 1 — 範例的選項:三條產線的粒徑,Lognormal,Z-Score 方法,LSL 2 µm,USL 20 µm。
輸出說明
- Multiple Variables Process Capability (Nonnormal) —— 每欄一列:Variable、N、Distribution、Pp、PPL、PPU、Ppk、PPM Expected 和 PPM Observed。
- Histogram of <distribution> Distribution —— 每欄一個,位於欄名之下,含 LSL 和 USL 以及配適的密度曲線。
- 透過 Download 匯出 PDF。
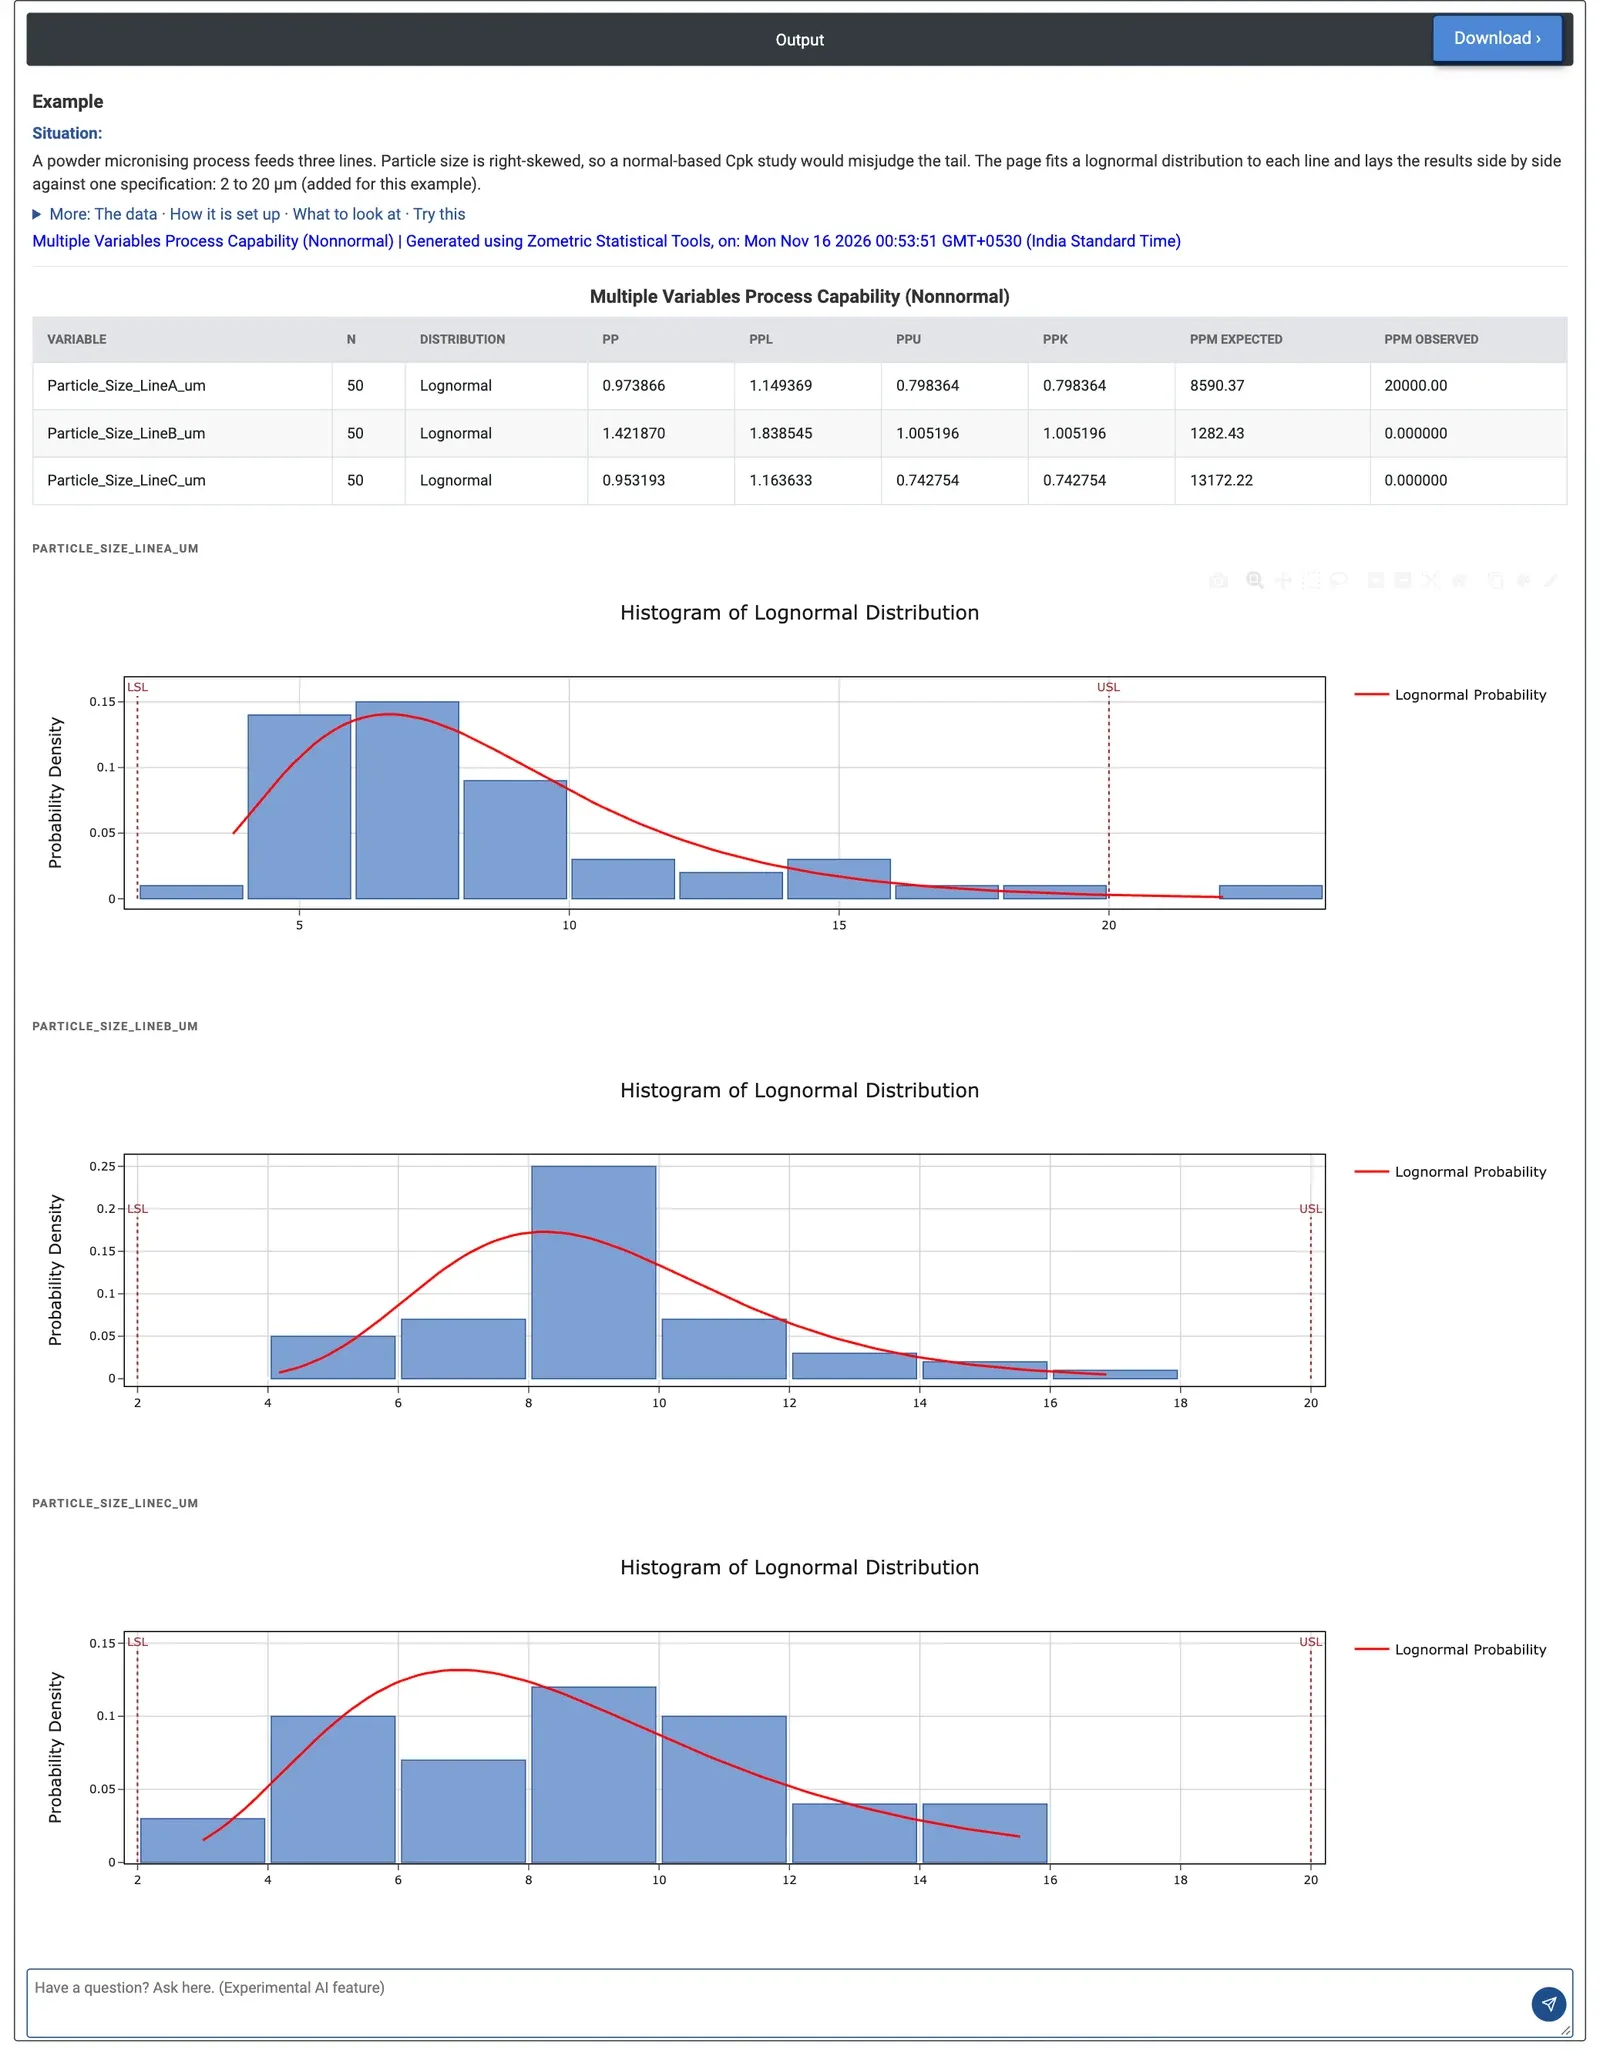
圖 2 — 三條產線的比較表和對數常態直方圖:A 線 Ppk 為 0.798,B 線為 1.005,C 線為 0.743,每條產線的 PPU 都低於 PPL;只有 A 線有樣本超過 USL。
計算範例
一道粉體微粉化製程為三條產線供料,粒徑呈右偏分配(中位數約 7 至 9 µm,粗顆粒一側有長尾)。製程工程師希望利用每條產線的 50 個樣本,對照 2 至 20 µm 的規格來比較各產線。Process variables = Particle_Size_LineA_um、Particle_Size_LineB_um 和 Particle_Size_LineC_um,Fit distribution = Lognormal,Method of analysis = Z-Score,LSL = 2,USL = 20。
A 線的 Ppk 為 0.798,期望超規格為 8,590 PPM;有一個樣本(22.11 µm)已超過 20 µm,因此觀測到 20,000 PPM。B 線最好,Ppk 為 1.005,期望為 1,282 PPM,但仍低於通常的目標值 1.33。C 線風險最大,Ppk 為 0.743,期望為 13,172 PPM。每條產線的 PPU 都低於 PPL:風險在於超過 20 µm 的粗顆粒,而不是低於 2 µm 的細顆粒,因此改善工作應針對粗顆粒的尾部,從 C 線開始。直方圖顯示出同樣的情形:每條配適曲線的長尾都朝向 USL,且 A 線有一個條形落在其之外。
模型很重要。採用 ISO 方法時,Ppk 值降至 0.694、1.008 和 0.619,排序相同。採用 Weibull 配適時,每條產線的 PPL 都變為較低的指數,排序也發生變化(Ppk 為 0.641、0.948 和 0.798,A 線現在最差)。在此頁面之外單獨計算的 Anderson-Darling 統計量顯示,A 線和 B 線更適合 lognormal(0.79 對 2.17,0.63 對 1.34),而 C 線更適合 Weibull(0.20 對 0.55),因此在將排序用於決策之前,應逐條檢查各產線。
常見問題
何時應對多個變數使用非常態能力分析?
當資料不服從常態分配時,用它將多個製程、產線、機器或模穴的能力與同一規格進行比較和排序。典型例子是粒徑、平面度、跳動或雜質等偏斜特性,對於這類特性,基於常態分配的 Ppk 會誤判分配的尾部。
Z-Score 方法和 ISO 方法有什麼區別?
Z-Score 方法將各規格界限之外的配適機率轉換為常態分數,併除以 3,得到 PPU 和 PPL。ISO 方法使用配適的第 0.135、50 和 99.865 百分位數,代替常態分配的正負 3 西格瑪範圍。如計算範例所示,兩者可能給出不同的 Ppk 值,儘管排序可能保持不變。
為什麼分配的選擇在非常態能力中很重要?
指數的好壞取決於所配適的分配,且同一個模型應用於每一欄。在計算範例中,從 Lognormal 改為 Weibull,改變了哪個指數較低,也改變了各產線的排序。在比較各欄之前,應檢查每一欄的配適情況,例如使用個別值分配識別。
PPM Expected 和 PPM Observed 有什麼區別?
PPM Expected 是配適分配下總體中超出規格界限的比例乘以 1,000,000。PPM Observed 是實際樣本值中超出規格界限的比例。兩者都是根據每欄全部資料計算的整體、長期度量。