
非線性迴歸
非線性迴歸對一個反應和一個預測變數配適參數不以線性方式進入的曲線。當製程的物理或化學規律決定了曲線形式時使用。可選擇七種內建函數之一或自訂函數,並給出合理的初始值。輸出包括帶標準誤和信賴區間的參數估計、配適線圖、相關矩陣和缺適性檢定。
最後審閱
核心要點
非線性迴歸配適參數以非線性方式進入的曲線,例如趨近極限的指數曲線,以估計極限值或速率常數等參數及其信賴區間。
用途
非線性迴歸對一個反應和一個預測變數配適參數不以線性方式進入的曲線,例如趨近極限的指數曲線、飽和曲線或 S 形增長曲線。當製程的物理或化學規律告訴您曲線的形式,並且希望得到其參數(如極限值或速率常數)的估計及信賴區間時使用。
主要功能
- 七種內建期望函數:指數衰減、指數增長、冪函數、3 參數羅吉斯、Michaelis-Menten、Gompertz 和二次函數。
- 以 X 為變數、參數為 b1、b2、… 的自訂期望函數,可使用 + − * / ^ 以及 exp、log、ln、log10、sqrt、abs、sin、cos、tan、arctan。
- Gauss-Newton、Levenberg-Marquardt 或 Trust Region Reflective 配適,可自行設定初始值、迭代次數上限和容差。
- 帶標準誤和信賴區間的參數估計,及其相關矩陣。
- 配適線圖,可選信賴帶和預測帶。
- 當預測變數有重複值時進行缺適性檢定。
- 可選的權重欄和殘差圖。
統計方法
該工具求出使誤差平方和 SSE = Σ (yᵢ − f(xᵢ, θ))² 最小的參數值 θ;若有權重欄,則為 Σ wᵢ (yᵢ − f(xᵢ, θ))²。Levenberg-Marquardt(預設)和 Trust Region Reflective 使用 SciPy 的最小平方求解器;Gauss-Newton 使用步長減半並報告迭代次數。當 SSE 和參數的相對變化降到收斂容差以下時,迭代停止。反應、預測變數或權重中含遺漏值的列將被剔除。
標準誤來自解處的線性近似:Cov(θ) = MSE·(JᵀJ)⁻¹,其中 J 是 f 對參數的導數矩陣,對於 p 個參數,MSE = SSE / (n − p);S = √MSE。信賴區間為 θ ± t(1−α/2, n−p)·SE。曲線的信賴帶使用相同的近似;預測帶則為單一新讀數加上 MSE。這些區間是近似的,若參數確定得不好則不可靠,這在相關矩陣中表現為相關係數接近 ±1。
當某些預測變數值重複時,誤差平方和被拆分為純誤差(重複之間的離散)和缺適性,F = MS 缺適性 / MS 純誤差用於檢定所選曲線是否配適。初始值很重要:內建函數從固定的預設值開始(例如 Michaelis-Menten 的 a = 1、b = 1),羅吉斯和 Gompertz 曲線的 c 取 X 的中位數;自訂函數的每個參數需要一個初始值。請給出接近預期的值,否則配適可能失敗或陷入較差的區域性極小值。
輸入欄位和選項
欄位 | 說明 |
Response (Y) / Predictor (X) | 數值欄;必須不同。必填。 |
Expectation function | Exponential decay y = a·exp(−b·x)(預設)、Exponential growth、Power y = a·x^b、Logistic (3-param)、Michaelis-Menten y = a·x/(b + x)、Gompertz、Quadratic,或 User-defined expectation function。 |
Expectation function (user-defined) | 選擇自訂時顯示。以 X 為變數、參數為 b1、b2、… 的公式,例如 b1 * exp(-b2 * X)。 |
Weights (optional) | 用於加權最小平方的權重欄。 |
Starting values (space-separated) | 每個參數一個值,按順序排列。內建函數可選(留空則使用預設值),自訂函數必填。 |
Confidence level | 預設 95。 |
Fitting algorithm | Gauss-Newton、Levenberg-Marquardt(預設)或 Trust Region Reflective。 |
Maximum number of iterations / Convergence tolerance | 預設值為 200 和 1e-05。 |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | 將這些帶新增到配適線圖中。預設關閉。 |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | 殘差圖;Four in one 將四張圖一起繪製。 |
Residuals versus the variables | 將殘差對所選欄作圖。 |
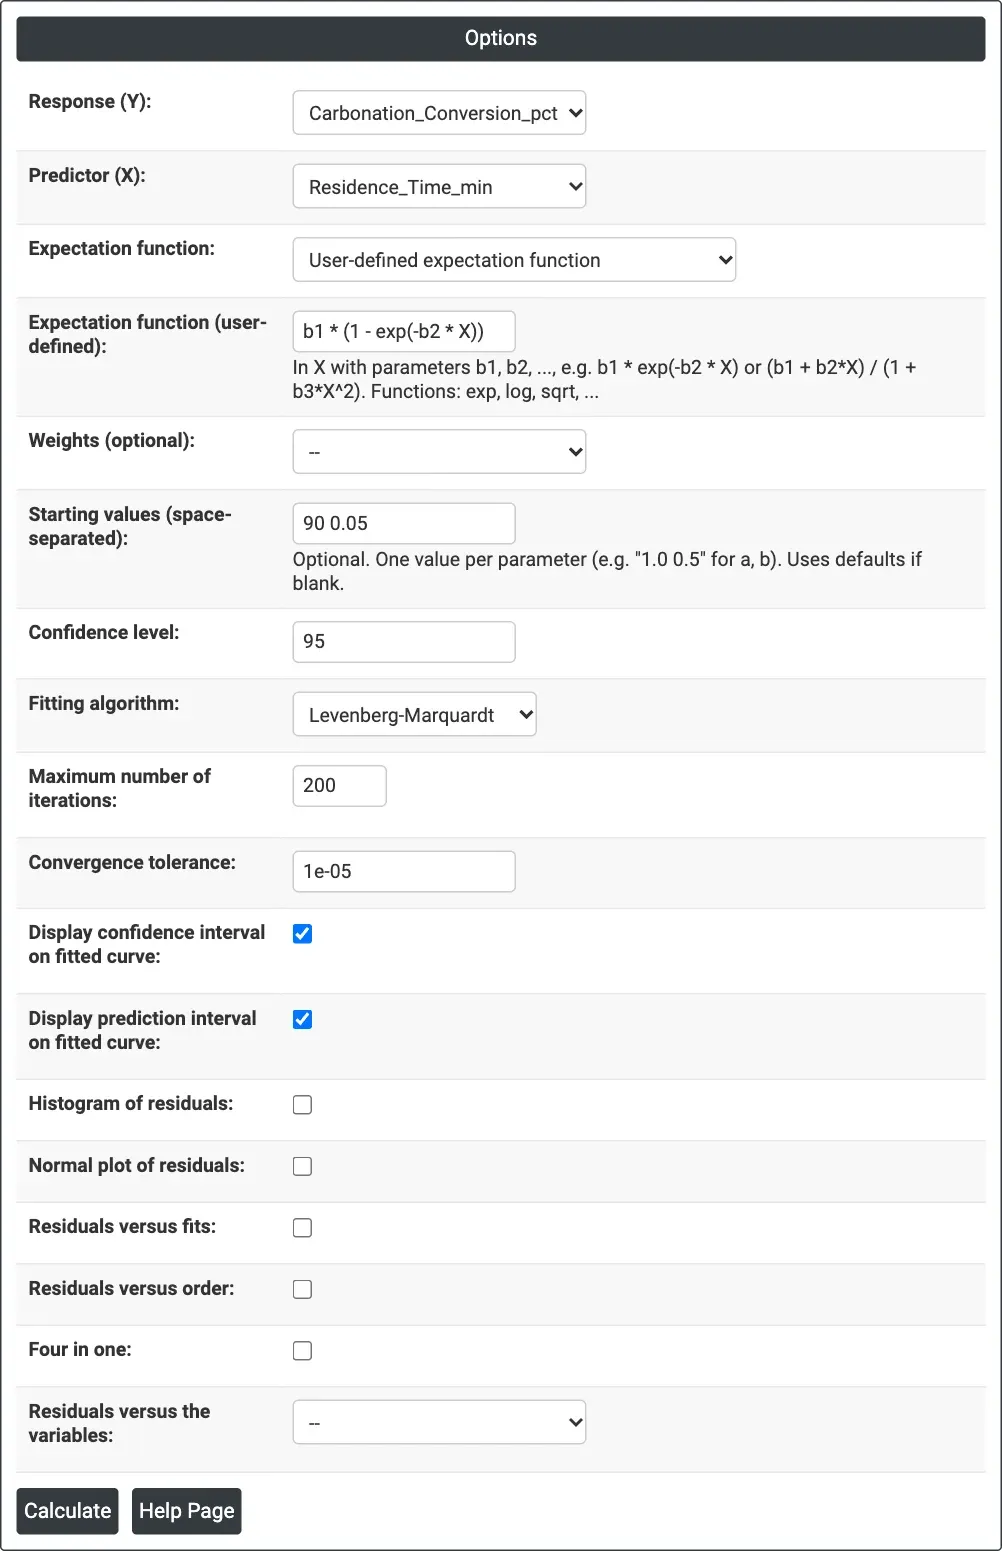
圖 1 — 碳酸化範例的選項:自訂函數 b1 * (1 - exp(-b2 * X)),初始值為 90 和 0.05,勾選信賴帶和預測帶。
輸出說明
- Method — 演算法、最大迭代次數、容差,以及對於 Gauss-Newton 所用的迭代次數。
- Starting Values for Parameters — 配適所用的起始值。
- Regression Equation — 帶欄名的配適曲線。
- Parameter Estimates — 每個參數的 Estimate、SE Estimate 和信賴限。
- Summary of Fit — Final SSE、DFE、MSE 和 S。
- Fitted Line Plot — 資料、配適曲線以及可選的 CI 和 PI 帶。
- Correlation Matrix for Parameter Estimates。
- Lack-of-Fit — 預測變數有重複值時,給出誤差、缺適性和純誤差各列及 F 和 P。
- 殘差圖(如已選擇)。
- 透過 Download 匯出 PDF。
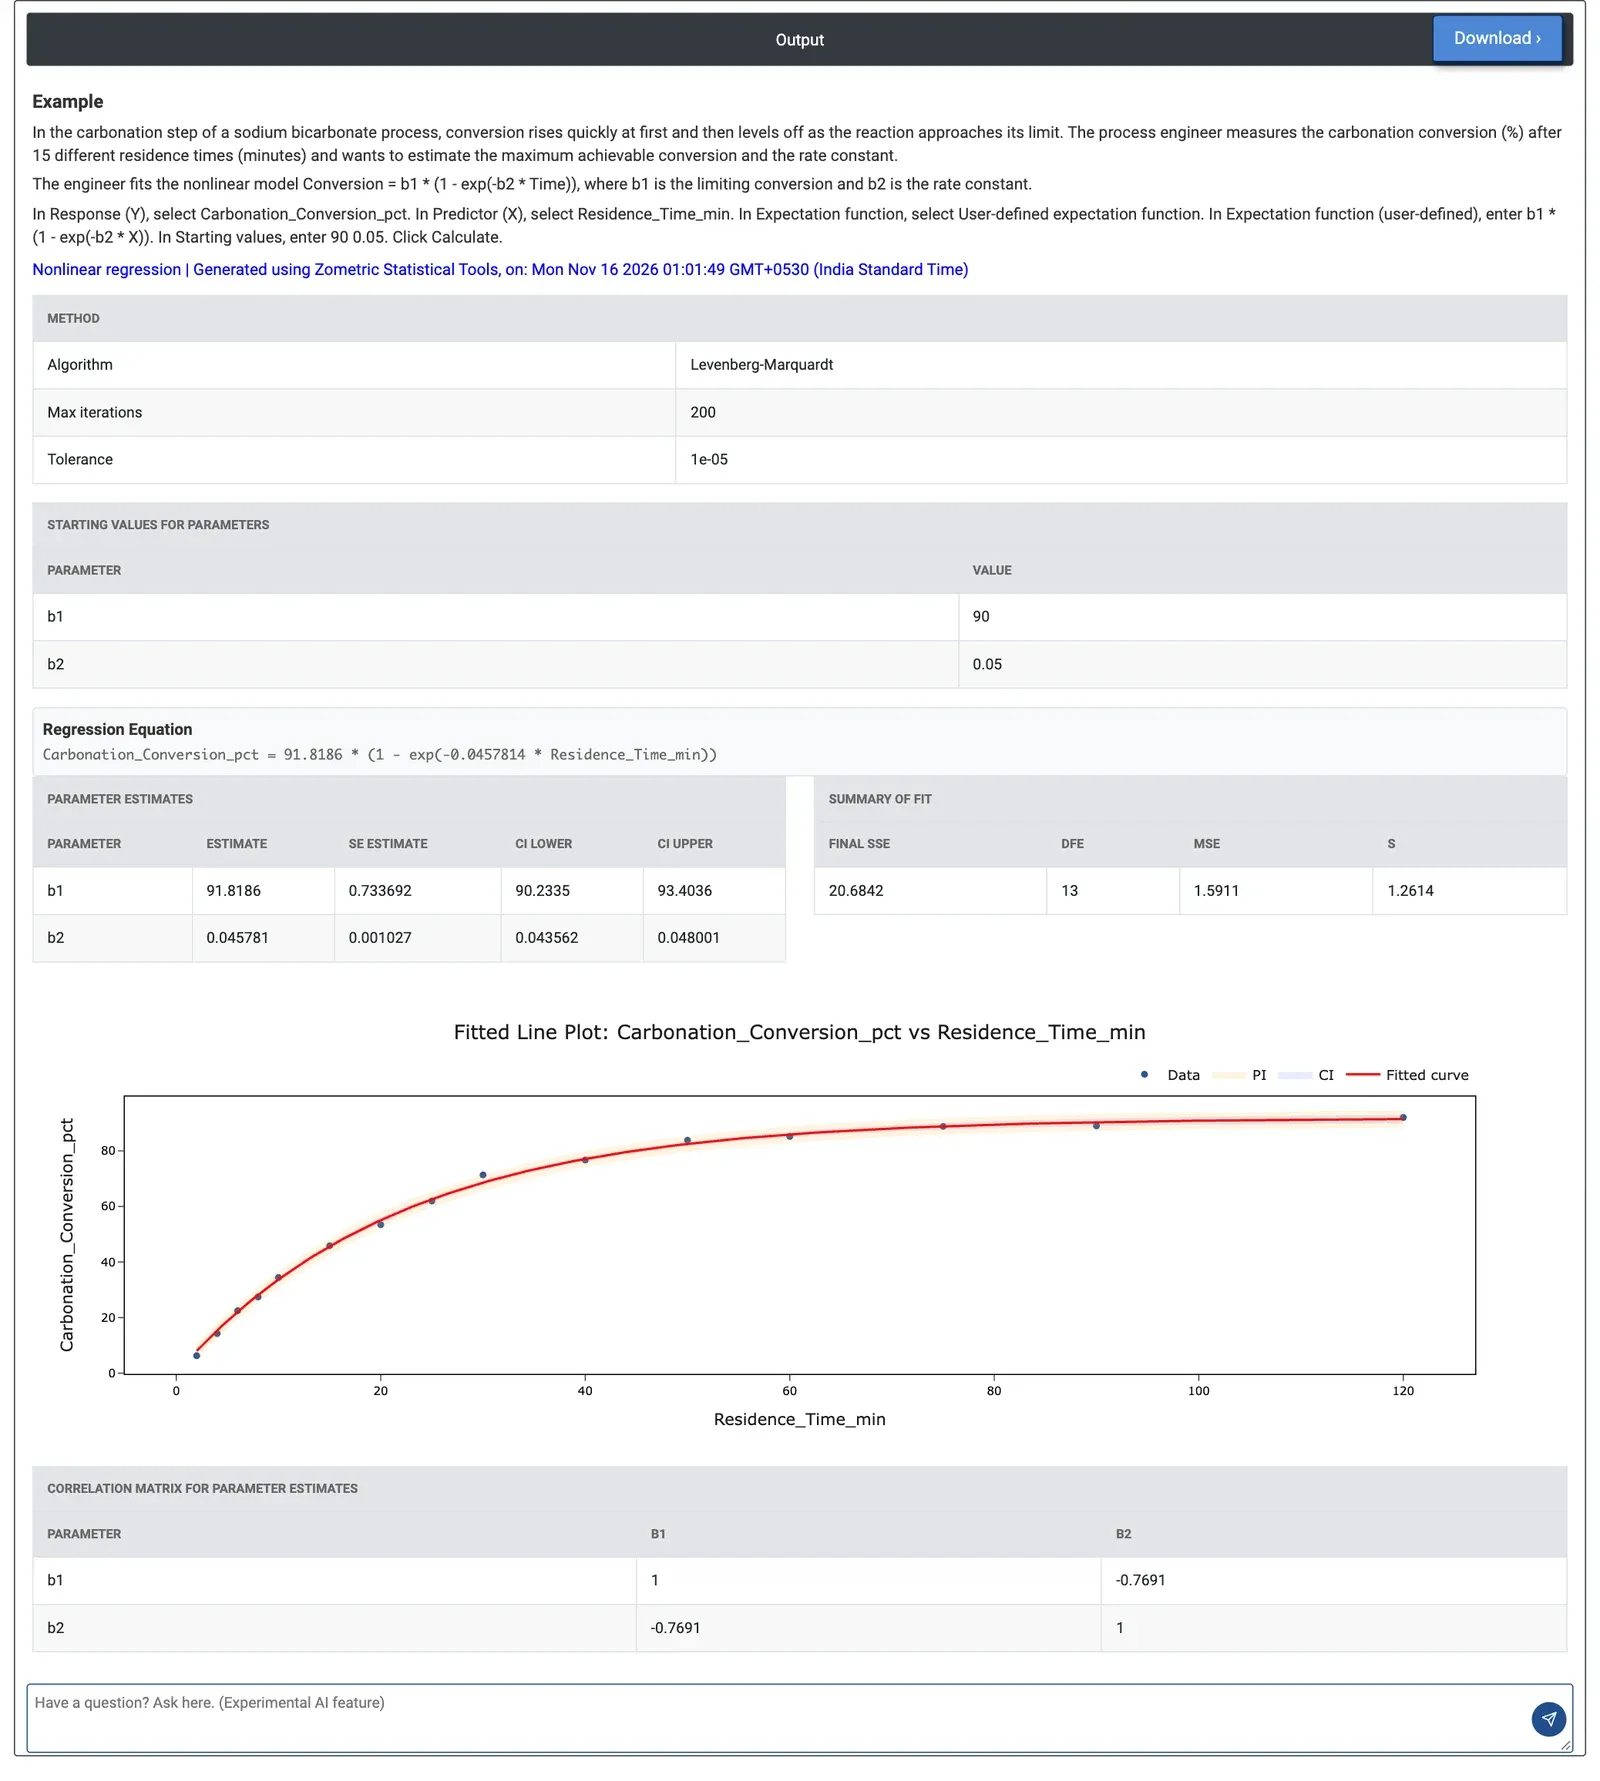
圖 2 — 轉化率隨停留時間的變化:極限轉化率 b1 = 91.82%,速率常數 b2 = 0.0458 每分鐘,S = 1.26。
計算範例
在碳酸氫鈉製程的碳酸化步驟中,轉化率迅速上升,然後趨於平緩。一名製程工程師在 2 至 120 分鐘的 15 個停留時間下量測轉化率(%),希望得到極限轉化率和速率常數。工程師將一級模型 Conversion = b1·(1 − exp(−b2·Time)) 作為自訂函數輸入,給出初始值 90 和 0.05,並勾選兩種帶。
配適收斂到 b1 = 91.82%(95% CI 為 90.23 至 93.40)和 b2 = 0.0458 每分鐘(95% CI 為 0.0436 至 0.0480)。S 為 1.26 個百分點,相對於 6 至 92% 的範圍很小,且各點在整個曲線長度上都落在曲線上。b1 與 b2 之間的相關係數為 −0.77:屬中等,因此兩個參數都確定得很好。Gauss-Newton 在 3 次迭代中給出相同的估計。由於沒有重複的停留時間,不顯示缺適性檢定。
根據配適曲線,達到極限轉化率的 90% 需要 ln(10)/b2 ≈ 50 分鐘,達到 95% 約需 65 分鐘;在 30 分鐘時轉化率僅約 69%。停留時間遠超過一小時所增加的轉化率很少,這有助於工程師設定塔的處理量。
常見問題
什麼是非線性迴歸?
非線性迴歸對一個反應和一個預測變數配適參數不以線性方式進入的曲線,例如趨近極限的指數曲線、飽和曲線或 S 形增長曲線。它找出使誤差平方和最小的參數值,並給出帶標準誤和信賴區間的參數。
什麼情況下應使用非線性迴歸?
當製程的物理或化學規律告訴您曲線的形式,並且希望得到其參數(如極限值或速率常數)的估計時,使用非線性迴歸。內建形式包括指數衰減和增長、冪函數、3 參數羅吉斯、Michaelis-Menten、Gompertz 和二次函數,也可以自訂函數。
為什麼初始值在非線性迴歸中很重要?
配適是迭代的,因此從初始值開始。內建函數使用固定的預設值,而自訂函數的每個參數需要一個初始值。接近預期的值有助於配適收斂;較差的初始值可能使配適失敗或陷入較差的區域性極小值。
如何判斷非線性迴歸的配適是否可靠?
檢查 S 以及各點與曲線的貼合程度,並檢視殘差圖。信賴區間是近似的,若參數確定得不好則不可靠,這在參數相關矩陣中表現為相關係數接近正負 1。當預測變數值重複時,缺適性 F 檢定可檢定所選曲線是否配適。