
OECD
OECD 統計決策樹工具是一個引導式統計分析系統,基於選擇並應用正確統計檢定的決策框架,用於分析試驗資料。使用者無需手動應對複雜的統計理論,工具會自動遵循 OECD 決策路徑——在每個階段評估資料類型、常態性、變異數齊性和組數——並相應地應用合適的檢定。
最後審閱
核心要點
OECD 統計決策樹工具是一個引導式統計分析系統,基於選擇並應用正確統計檢定的決策框架,用於分析試驗資料。
本頁內容
什麼是 OECD?
OECD 統計決策樹工具是一個引導式統計分析系統,基於選擇並應用正確統計檢定的決策框架,用於分析試驗資料。使用者無需手動應對複雜的統計理論,工具會自動遵循 OECD 決策路徑——在每個階段評估資料類型、常態性、變異數齊性和組數——並相應地應用合適的檢定。
該工具旨在確保統計結論在科學上有效、完全可重現,並符合國際公認的指南。這在毒理學、環境科學、藥物研究和監管申報研究中尤為關鍵,因為在這些領域,統計檢定的選擇必須有文件記錄、有依據,並經得起稽核。
簡單定義:一種智慧的自動化工具,逐步遵循 OECD 統計決策流程圖——評估您的資料類型、分配和分組結構——自動選擇並應用正確的統計檢定,使您始終獲得有效且站得住腳的結果。
何時使用 OECD?
- 當需要一次性執行完整的統計比較流程,而不是邊做邊逐個檢定地決定時,使用 OECD 流程圖方法。無需在每次檢定後停下來考慮下一步,只需預先輸入資料特徵——資料類型、常態性結果、變異數結果——整個決策樹便會一次性得出結論。
- 它主要是一個 比較框架 ——專門用於在比較各組之間(2 組或 3 組以上)或各組與對照組時,確定應採用哪種統計檢定。無需在每一步逐個檢定地決定,而是預先輸入資料特徵。主要用於 製藥領域。
該工具按嚴格的邏輯順序遵循 OECD 流程圖。每一步都會產生一個決定,該決定決定接下來走路徑的哪個分支。瞭解這一流程,有助於解讀工具的輸出,並理解為什麼針對您的特定資料選擇了某種統計檢定。
步驟 1——資料類型評估
第一個決策點判斷資料是連續型還是離散型/定量反應型。這一區分決定了後續的整個路徑。
資料類型
說明與範例
連續型資料
可在某一範圍內取任意值的量測數值,例如體重、酶活性、器官重量、濃度或血液學參數。對於連續型資料,工具接著進行常態性檢查。
離散型或定量反應型資料
計數、百分比、比率、等級或分類結果,例如受影響動物的數量、病變發生率、有無反應或嚴重程度評分。工具直接進入非參數或分類檢定的選擇。
步驟 2——常態性檢查(連續型資料)
對於連續型資料,工具使用所選的常態性檢定,檢查資料是否服從常態(鐘形曲線)分配。其結果決定接下來走哪條統計路徑。
如果未拒絕常態性(p ≥ α)——資料為常態:
→ 工具沿參數路徑繼續。
→ 參數檢定具有更高的檢定力,在常態性得到確認時應始終使用。
如果拒絕常態性(p < α)——資料為非常態:
→ 嘗試進行資料轉換(對數、平方根等)。
→ 對轉換後的資料重新檢查常態性。
→ 如果轉換後的資料為常態 → 對轉換後的資料應用參數檢定。
→ 如果轉換後的資料仍為非常態 → 工具轉入非參數路徑。
步驟 3——參數路徑
一旦確認資料為常態(或已成功轉換為常態),工具便根據所比較的組數確定合適的參數檢定。
比較 2 組
工具使用 F 檢定檢查變異數齊性,以判斷兩組的變異數在統計上是否相等。
變異數齊性結果
所應用的統計檢定
變異數相等(F 檢定不顯著)
應用 Student t 檢定。這是假定兩組變異數相等的標準雙樣本 t 檢定。
變異數不等(F 檢定顯著)
應用 Satterthwaite 法(Welch t 檢定)。該變體不假定變異數相等,並相應調整自由度。
比較 3 組或更多組
工具使用 Bartlett 檢定、Levene 檢定或 Brown-Forsythe 檢定檢查變異數齊性。
變異數齊性結果
所應用的統計檢定
變異數相等(不顯著)
應用變異數分析(ANOVA)。→ 如果 ANOVA 顯著:進行 Dunnett 檢定,將每個處理組與對照組逐一進行兩兩比較。→ 如果 ANOVA 不顯著:無需進一步檢定。停止。
變異數不等(顯著)
工具直接轉入不假定變異數齊性的相應檢定。
步驟 4——非參數路徑
當資料無法常態化,或資料由計數、百分比或等級構成時,工具遵循非參數路徑。
資料情形
所應用的檢定
結果 / 後續步驟
計數 / 百分比 / 等級資料,≥ 3 組
Kruskal-Wallis 檢定
如果顯著 → Dunn 檢定(事後檢定)。如果不顯著 → 停止。
計數 / 百分比 / 等級資料,2 組
Mann-Whitney U 檢定
直接比較兩個獨立組。
分類資料或指數資料
卡方
檢定的選擇取決於具體的資料結構和研究設計。
正確使用 OECD 的指南
- 確保資料錄入正確且一致—— 輸入階段的資料錄入錯誤 會傳遞到決策樹的每一個後續決策,並可能導致應用錯誤的檢定。
- 謹慎選擇反應欄——如果選擇多個反應,每一欄都必須代表一個 完整、獨立的組資料集。如果選擇單一反應,應確保因子欄正確且完整地標示每個觀測值所屬的組。
- 保持 Anderson-Darling 和 Shapiro-Wilk 兩種常態性檢定均處於啟用狀態(預設設定)。兩個獨立的檢定得出相同的常態性結論,可增強所選路徑在科學上的說服力。
替代方法:何時不宜使用 OECD
- 如果您的研究 不要求符合 OECD 指南 且沒有監管背景,請直接使用最合適的具體統計檢定——OECD 決策樹框架會增加結構化的額外工作量,對於純探索性或學術性分析可能並無必要。
- 如果您的研究需要 迴歸、相關分析或劑量-反應建模,而不是簡單的組間比較,請使用相應的迴歸或建模工具——OECD 工具專門用於組平均值比較,而不是配適連續型變數之間的關係。
- 如果有 配對觀測 ——例如來自同一受試物件的前後量測——請使用 配對 t 檢定或 Wilcoxon 符號秩檢定。此處實現的 OECD 決策樹假定各組相互獨立。
- 如果資料本質上是 時間序列或縱向資料,即量測值隨多個連續時間點變化,請使用 重複量測變異數分析、混合效應模型或時間序列分析
- 如果主要分析目標是 等價性檢定或非劣效性評估 而不是檢測差異,請使用專門的等價性檢定方法,而不是 OECD 決策樹的標準優效性框架。
OECD 範例
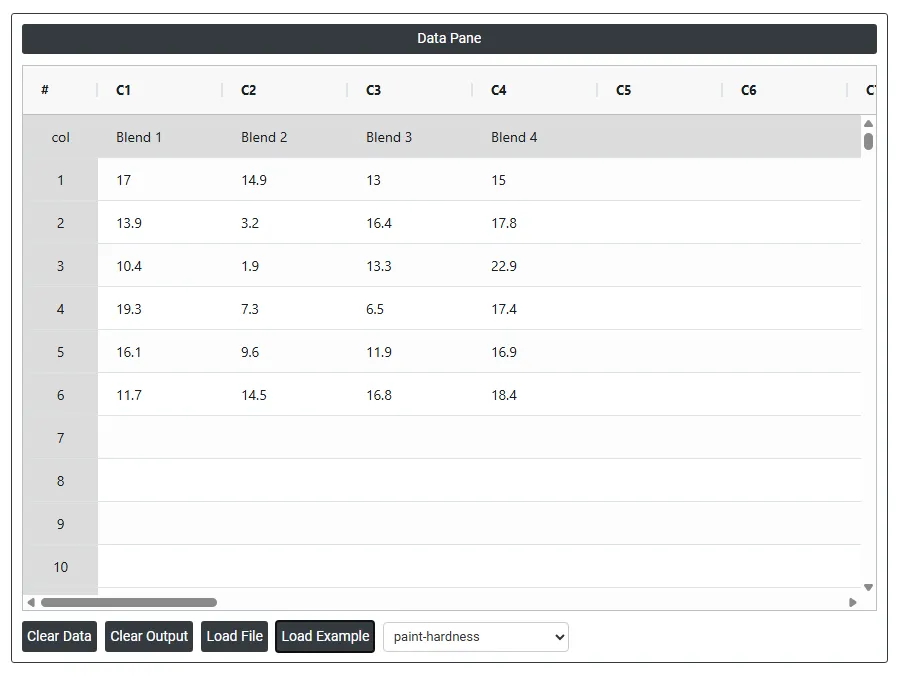
一名化學工程師想比較四種油漆配方的硬度。每種油漆配方取六個樣品塗在一塊金屬上,然後固化。隨後量測每個樣品的硬度。步驟如下:
- 收集所需資料。
2. 現在,在 Zometric Statistical Software 中分析資料,網址為 https://statsai.zometric.com/。
3. 要找到 OECD,請選擇 Statistical module> OECD>OECD。
4. 在工具中輸入資料及其他輸入項,如下所示:
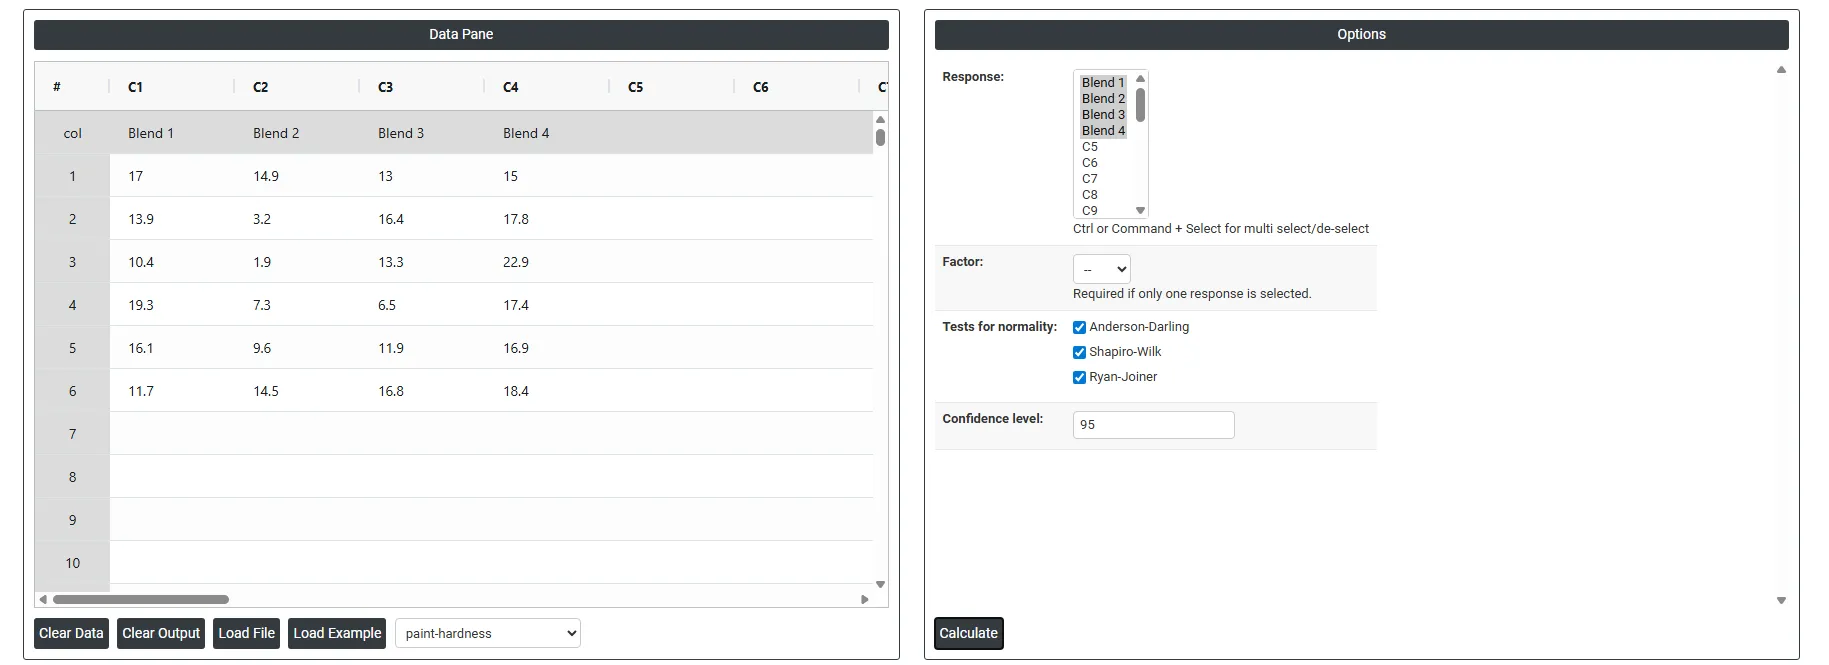
5. 使用上述工具後,得到如下輸出:
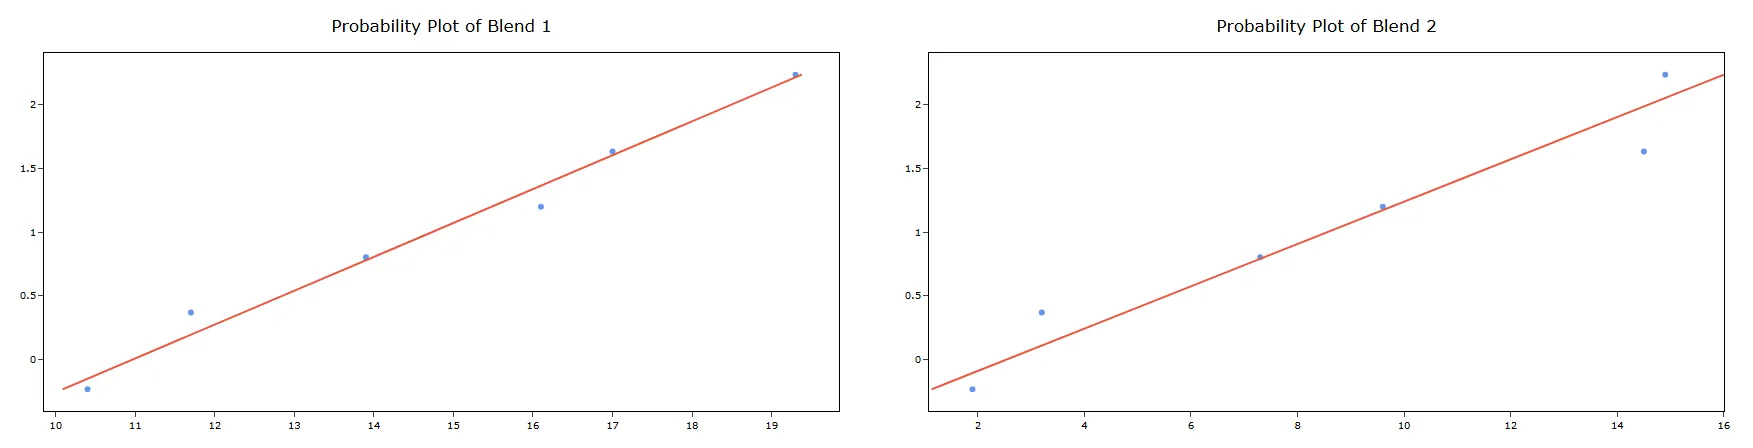
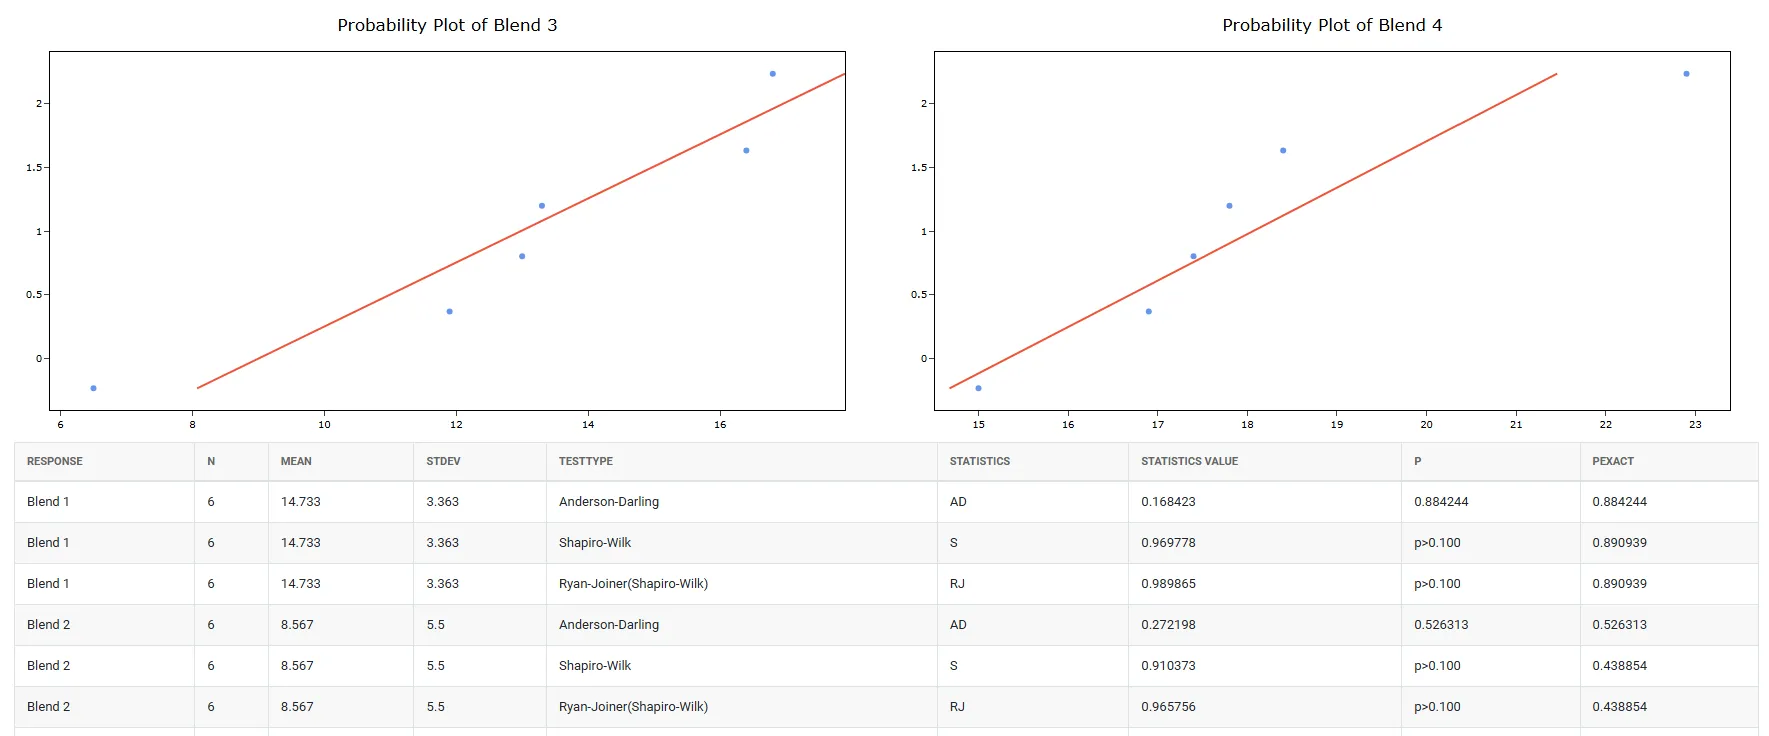
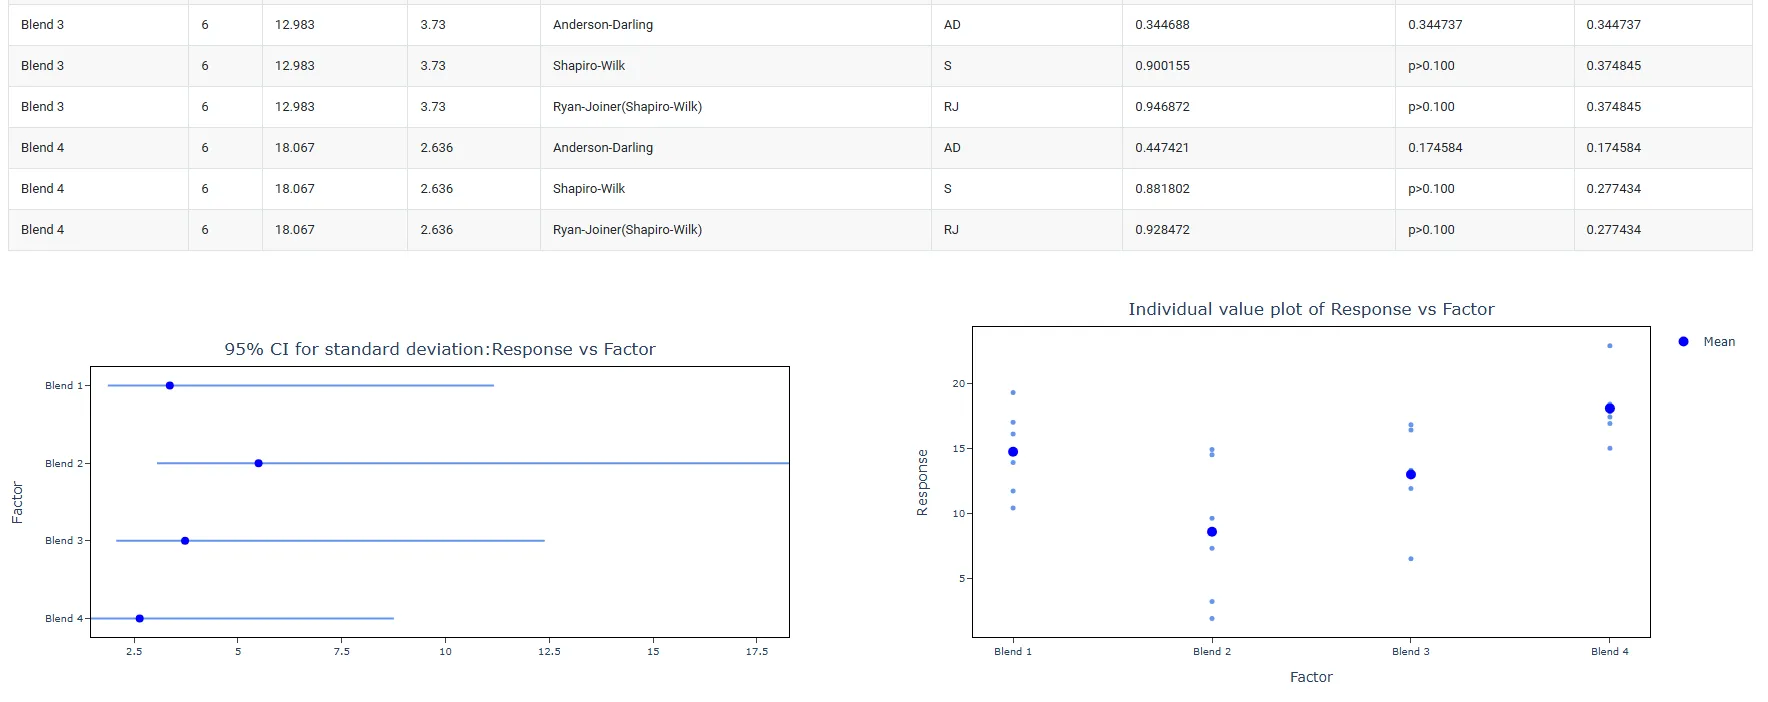
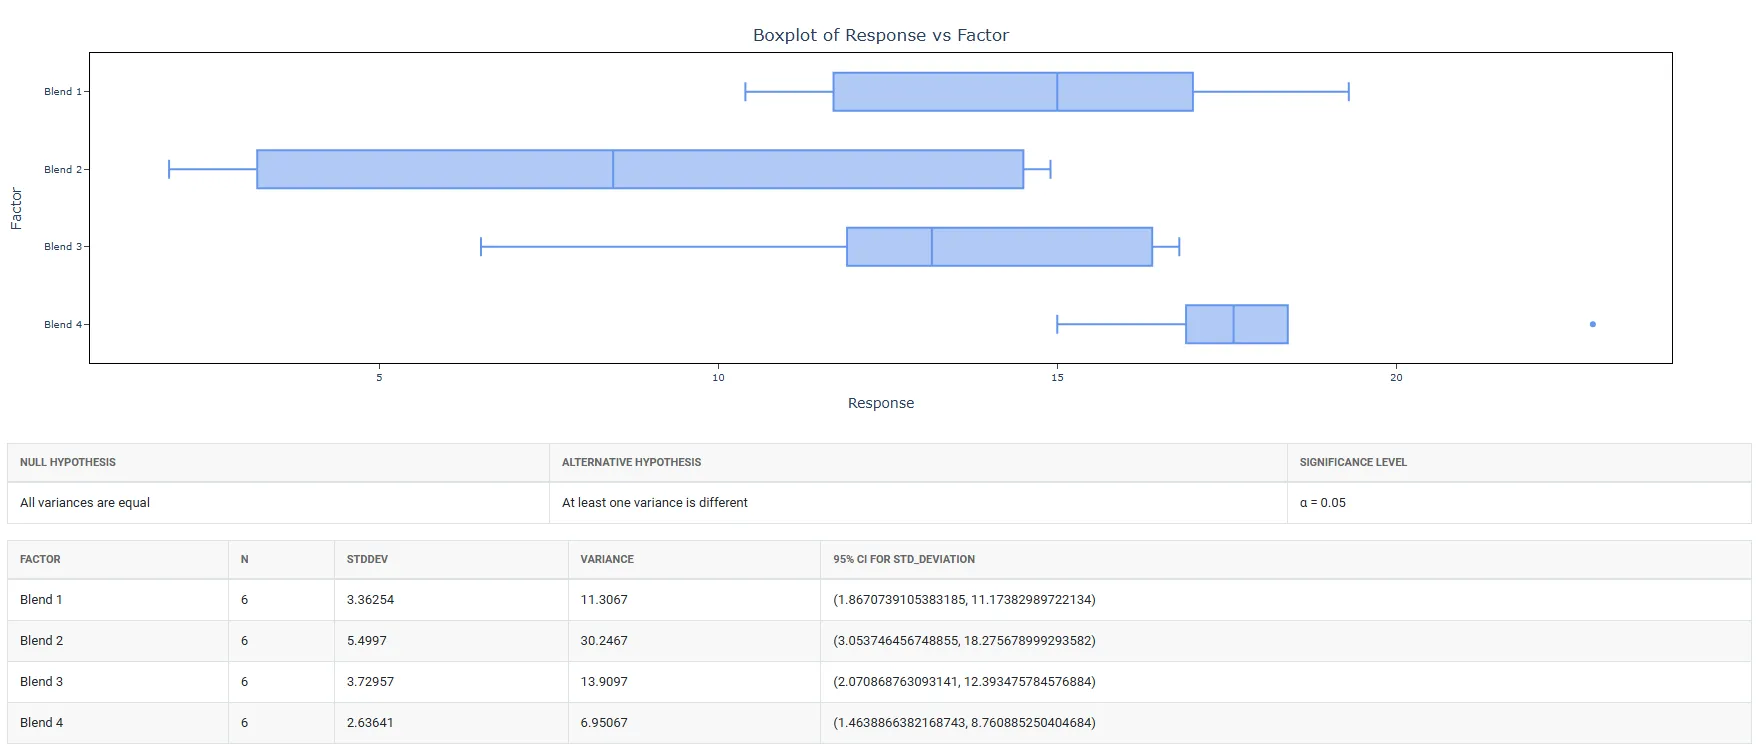
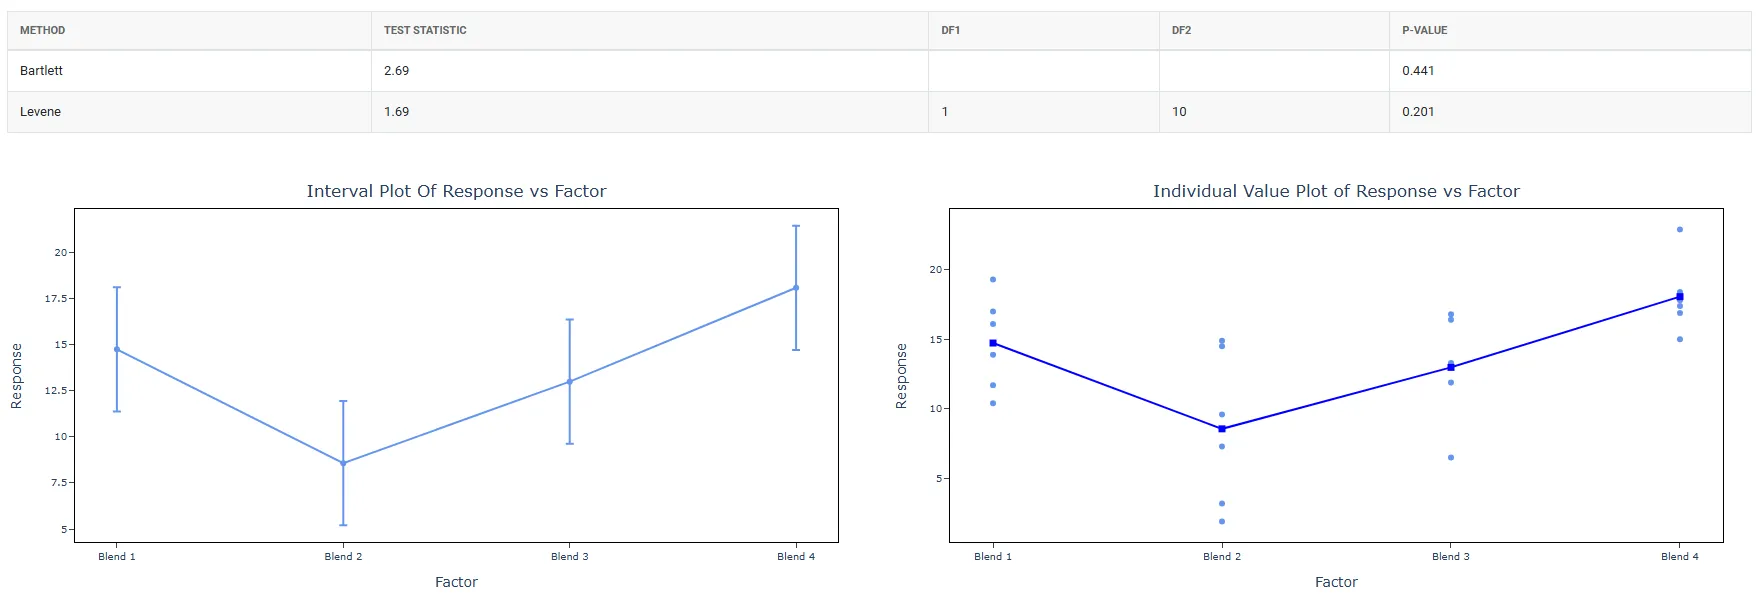
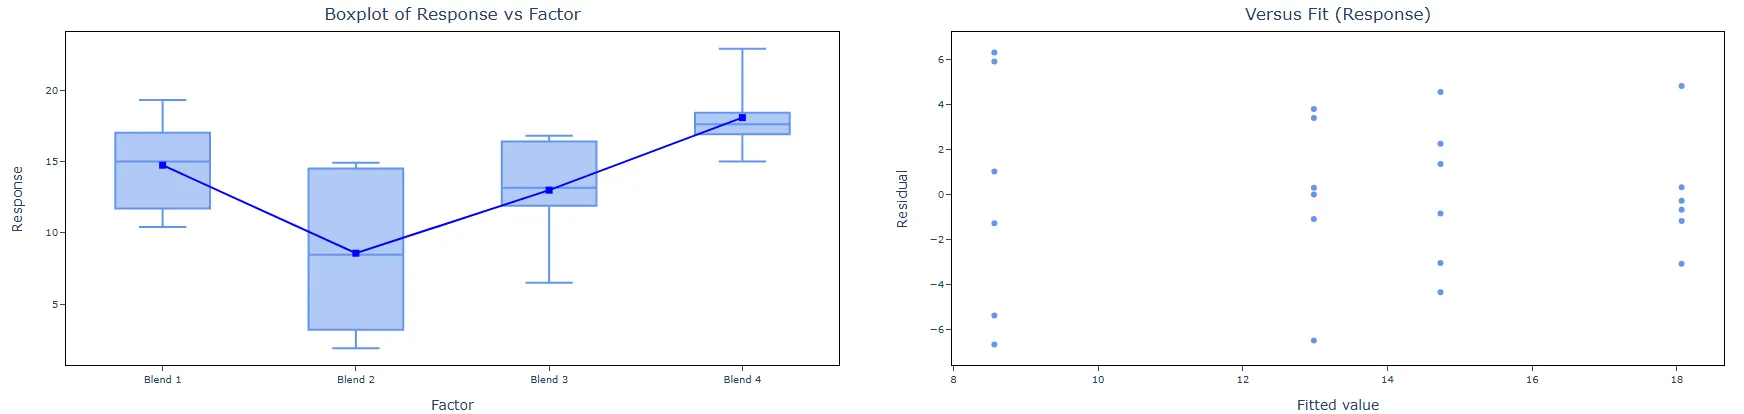
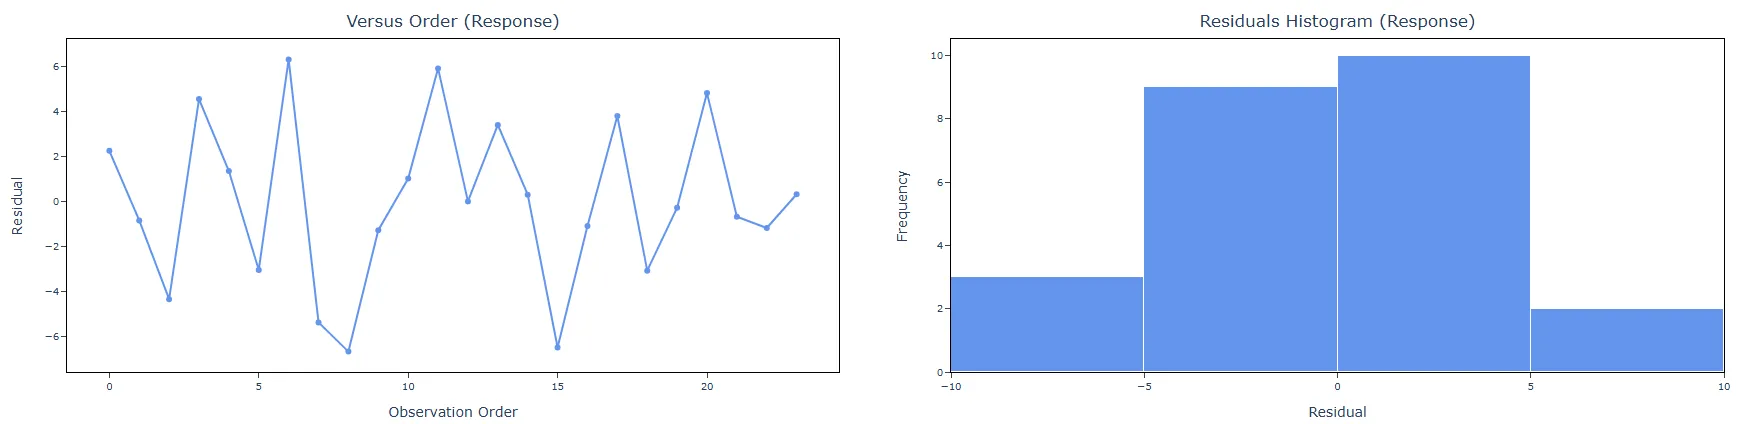
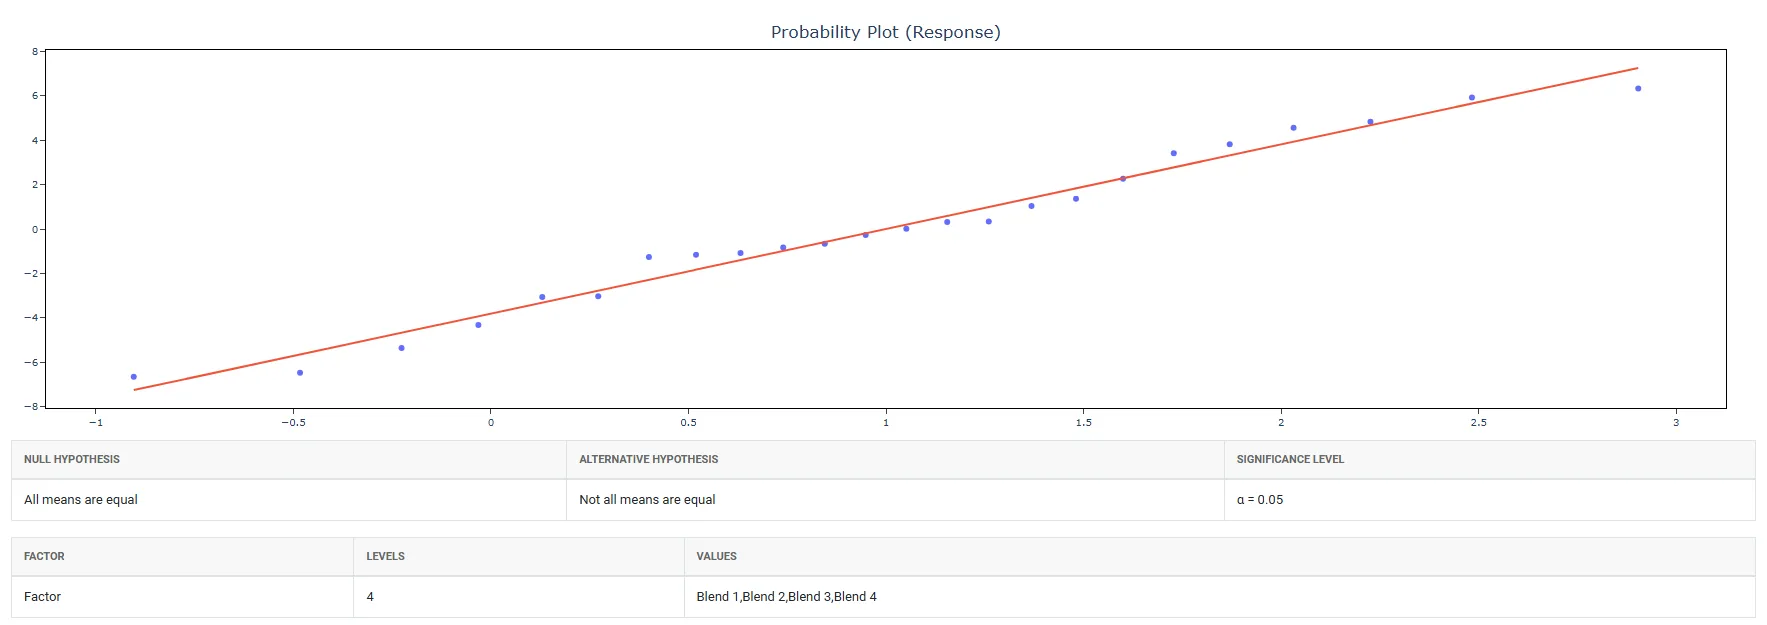
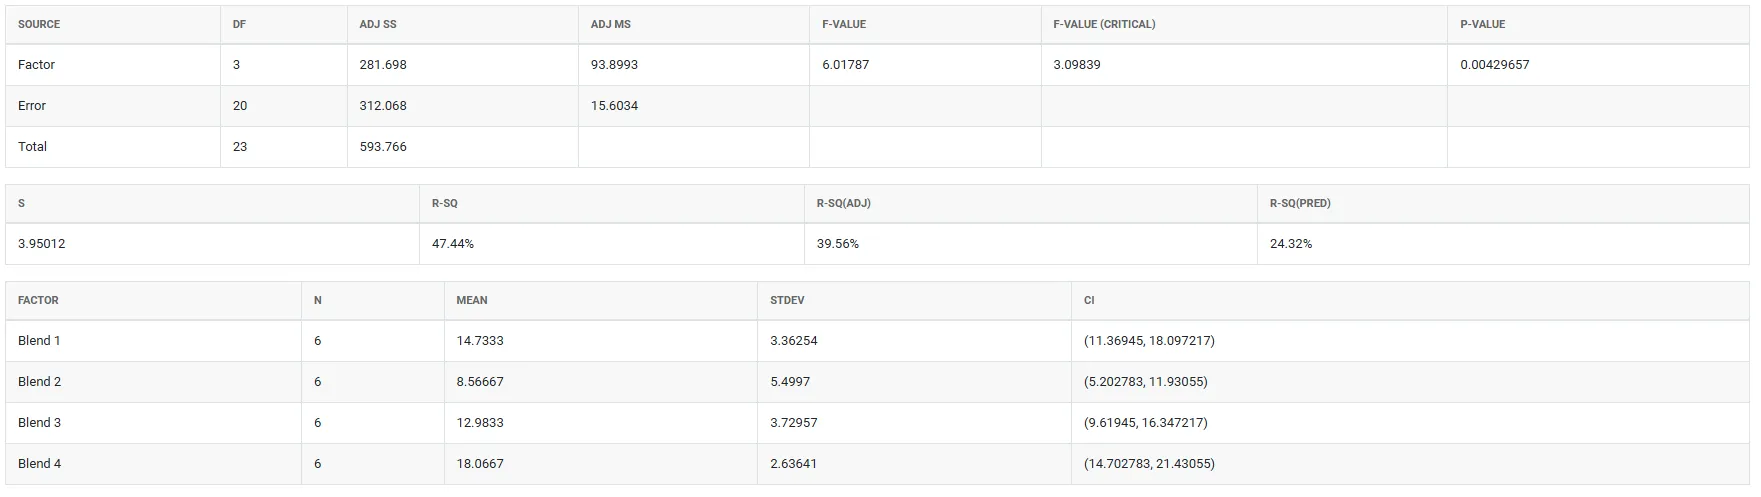
如何進行 OECD
操作步驟如下:
- 登入 Zometric Statistical Software,網址為 https://statsai.zometric.com/
- 在首頁選擇 Statistical Tool> OECD>OECD。
- 接下來,手動更新資料,或從 Excel 表格中完整複製(Ctrl+C)資料並貼上(Ctrl+V);也可以使用 Load Example 選項載入範例資料。
- 接下來,填寫所需選項。
- 最後,點選頁面底部的 calculate,即可得到所需結果。
OECD 的工具介面分為兩部分。
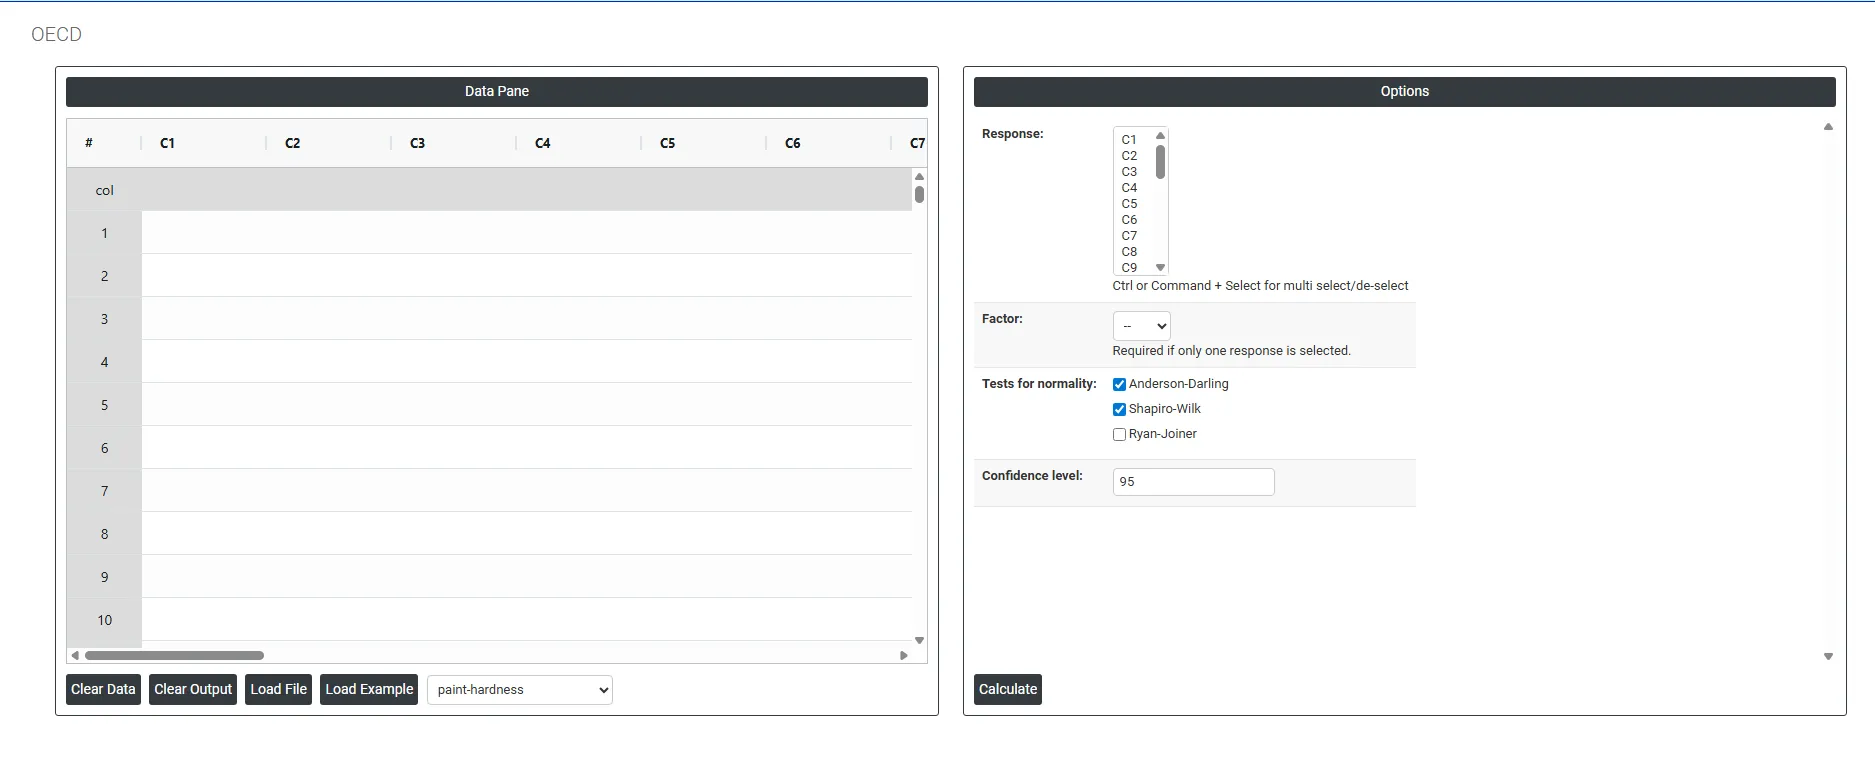
左側為資料窗格(Data Pane)。在 Data Pane 中,每一列構成一個子群組。可以手動輸入資料,也可以從 Excel 表格中完整複製(Ctrl+C)資料並貼上(Ctrl+V)到此處。
Load example: 將載入範例資料。
Load File: 用於直接載入 Excel 資料。
右側提供以下選項:
- Response: 選擇包含要分析的結果量測值的一欄或多欄——例如體重、酶活性、腫瘤發生率、血液學數值,或研究中各組記錄的任何其他終點。使用 Ctrl 或 Command + 點選可同時選擇多個反應欄。
所選反應欄的數量直接決定 Factor 選項是否為必填:
選擇
工具的行為
選擇了多個反應
每個所選欄代表一個獨立的組。工具直接用這些欄來定義分組——無需額外的 Factor 欄。各欄中的量測值直接相互比較。
選擇了單一反應
所有量測值堆疊在一欄中,必須另選一個 Factor 欄,以標示每個量測值所屬的組。沒有 Factor 欄,工具就無法確定哪些觀測值屬於哪個組。
⚠ 重要:當選擇單一反應時,Factor 欄位變為必填。在分析繼續之前,工具會提示您選擇 Factor 欄。
- Factor: 選擇標示每個觀測值所屬組的欄。該欄包含分類標籤或編碼,表明資料的每一列屬於哪個試驗組——例如 Control、Low Dose、Mid Dose、High Dose,或 Group 1、Group 2、Group 3。因子欄告訴工具如何將單一反應欄拆分為多個組進行比較。如果未正確指定因子,所有量測值都會被視為屬於同一組,也就無法進行有意義的比較。只有恰好選擇一個反應欄時,此欄位才為必填。選擇多個反應欄時,每一欄代表一個組,無需 Factor。選擇多個反應時,該欄位將呈灰色或被忽略
- Tests for Normality: 定義在決策樹的步驟 2 使用哪種或哪幾種統計檢定來評估反應資料是否服從常態分配。該檢定的結果決定整個分析遵循參數分析路徑還是非參數分析路徑。提供三種檢定:
- Anderson-Darling : 一種檢定力較強的綜合性常態性檢定,特別強調分配的尾部——即極高值和極低值。這使其對尾部偏離常態性的情況尤為敏感,而在毒理學和環境資料中,尾部往往是實際上最重要的區域。Anderson-Darling 檢定推薦用於各種樣本數的通用場合,在預期尾部行為與常態分配不同時尤其有效。
- Shapiro-Wilk: 被廣泛認為是小樣本(通常 n < 50)下檢定力最強、最可靠的常態性檢定,而這正是 OECD 指南研究中最常見的情形,其組大小通常為 5 至 20 只動物。Shapiro-Wilk 檢定是 OECD 統計指南中引用的主要常態性檢定,也是製藥和毒理學統計中的標準選擇。強烈建議在監管研究分析中始終保持啟用該檢定。
- Ryan-Joiner: 一種基於相關性的常態性檢定,透過度量觀測資料與理論常態分位數之間的相關性,來評估資料與常態分配所預期模式的吻合程度。它在概念上與 Shapiro-Wilk 檢定類似,但採用不同的計算方法。在監管工作中較少需要,但當審評機構特別要求或偏好基於相關性的常態性評估時,可以啟用。
- 當選擇了多種常態性檢定時,工具會執行所有勾選的檢定並報告所有結果。總體的常態性判定基於最保守的結果——只要任何一項所選檢定表明非常態(p < α),資料就被視為非常態,並遵循非參數路徑
Confidence Level (Default: 95): 設定在整個決策樹中對每一項假設檢定一致使用的顯著性閾值——包括常態性檢定、變異數齊性檢定和最終的組間比較檢定。所輸入的值表示信賴度百分比,所有決策所用的相應 α 水準按 (100 − Confidence Level) ÷ 100 計算。
信賴水準
α 水準及適用場合
95(預設)
Alpha = 0.05。大多數科學研究和監管性 OECD 研究的標準信賴水準。得出假陽性結論的機率為 5%。這是 OECD 指南和各國監管機構最常要求的水準。
99
Alpha = 0.01。檢定更為保守——需要更強的證據才能宣佈結果顯著。可減少假陽性,但可能漏掉較小的真實效應。當假陽性的後果特別嚴重時使用。
90
Alpha = 0.10。檢定更為靈敏,可檢出更小的差異,但會增加假陽性結論的風險。僅適用於探索性研究或預試驗,此類研究中漏掉真實效應是更大的顧慮。
常見問題
什麼是 OECD 統計決策樹?
OECD 統計決策樹工具是一個引導式分析系統,可為試驗資料選擇並應用正確的統計檢定。它遵循 OECD 決策路徑,在每個階段評估資料類型、常態性、變異數齊性和組數,因此結論可重現且站得住腳。它用於毒理學、環境科學、藥物研究和監管申報。
OECD 決策樹對常態資料應用哪些檢定?
對於兩組,用 F 檢定檢查變異數:變異數相等時採用 Student t 檢定,變異數不等時採用 Satterthwaite 法(Welch t 檢定)。對於三組或更多組,用 Bartlett 檢定、Levene 檢定或 Brown-Forsythe 檢定檢查變異數;變異數相等時應用 ANOVA,若 ANOVA 顯著,則再進行與對照組比較的 Dunnett 檢定。
在 OECD 決策樹中,資料不服從常態分配時會怎樣?
如果拒絕常態性,會嘗試對數或平方根等轉換,並重新檢查常態性。如果轉換後的資料仍為非常態,則遵循非參數路徑:三組或更多組採用 Kruskal-Wallis 檢定及 Dunn 事後檢定,兩組採用 Mann-Whitney U 檢定,分類資料或指數資料採用卡方檢定。
何時不應使用 OECD 決策樹?
不要將其用於配對觀測(應使用配對 t 檢定或 Wilcoxon 符號秩檢定)、迴歸或劑量-反應建模、時間序列或縱向資料,或等價性和非劣效性檢定。在沒有 OECD 監管背景的情況下,直接使用最合適的具體檢定可能更簡單。