
順序邏輯迴歸
順序邏輯迴歸是一種統計模型,用於分析一個或多個預測變數與具有三個或更多順序類別的反應變數之間的關係。這些類別具有自然的等級或順序,例如低/中/高或不同意/中立/同意——但它們之間的確切距離無法度量。
最後審閱
核心要點
順序邏輯迴歸是一種統計模型,用於分析一個或多個預測變數與具有三個或更多順序類別的反應變數之間的關係。
什麼是順序邏輯迴歸?
順序邏輯迴歸是一種統計模型,用於分析一個或多個預測變數與 具有三個或更多順序類別的反應變數之間的關係。這些類別具有自然的等級或順序,例如低/中/高或不同意/中立/同意——但它們之間的確切距離無法度量。它根據預測變數預測落入各類別的機率。
何時使用順序邏輯迴歸?
預測變數
- 預測變數可以是 連續型、分類型,或二者混合
- 離散變數可根據水準數和分析目的,視為連續型或分類型
- 僅有一個連續型預測變數且反應為連續型 → 請使用 配適線圖
- 有多個預測變數且反應為連續型 → 請使用 配適迴歸模型
反應變數
- 反應必須具有 三個或更多順序類別,且有自然的等級(例如低/中/高、從不/有時/總是)
- 順序很重要——但類別之間的間隔不必相等
- 反應僅有 兩個類別(合格/不合格)→ 請使用 二元邏輯迴歸
- 反應具有 無序類別(劃痕/凹痕/撕裂)→ 請使用 名目邏輯迴歸
- 反應為 連續型 → 請使用 配適迴歸模型 或 配適線圖
正確使用順序邏輯迴歸的指南
- 確保反應變數具有 三個或更多有意義的順序類別;若順序無關緊要,請改用名目邏輯迴歸。
- 預測變數可以是 連續型或分類型;執行模型之前,請確保每個預測變數的類型分類正確。
- 確保資料 準確代表目標總體;有偏或不完整的資料會產生不可靠的結果。
- 每個類別應收集 足夠的資料點,以確保在所有反應水準上得到穩定可靠的機率估計。
- 儘可能 準確地量測所有變數;分類或量測中的誤差會直接影響模型的準確性。
- 按 收集的順序 記錄資料,以幫助發現任何基於時間的趨勢或不一致。
- 配適之後,使用 適合度統計量和殘差診斷來驗證模型;配適不佳的模型會產生誤導性的預測。
- 檢查 比例優勢假設 ——順序邏輯迴歸假定每一對結果組之間的關係是一致的。若該假設不成立,請考慮改用名目邏輯迴歸。
替代方法:何時不宜使用順序邏輯迴歸
- 若反應 只有兩個類別(例如合格/不合格),請改用 二元邏輯迴歸。
- 若反應類別 沒有自然順序(例如劃痕/凹痕/撕裂),請改用 名目邏輯迴歸。
- 若反應變數為 連續型,請改用 配適迴歸模型 或 配適線圖。
- 若 只有一個連續型預測變數 且反應為連續型,請改用 配適線圖。
- 若有 多個預測變數 且反應為連續型,請改用 配適迴歸模型。
順序邏輯迴歸範例
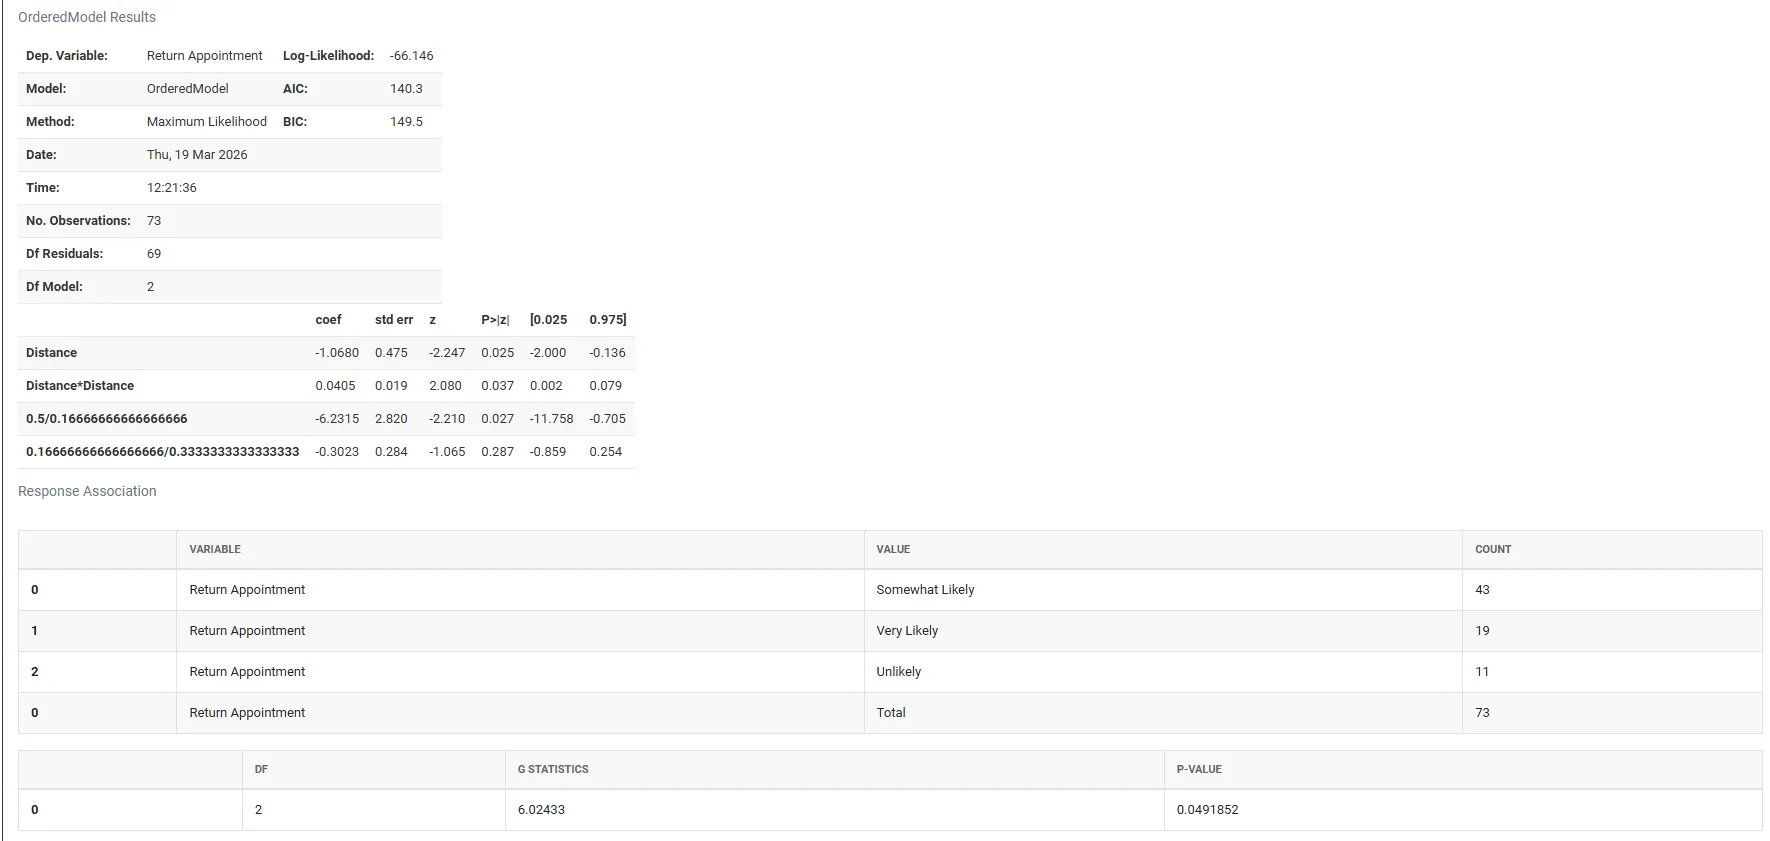
一家診所的經理想找出影響患者滿意度的因素。診所就患者再次來院接受後續治療的可能性對患者進行調查,回答分為不太可能、有些可能或非常可能。由於這些反應類別具有自然順序,經理將結果視為順序變數,並使用順序邏輯迴歸,檢定患者再次來院的可能性與就業狀況、年齡和與診所的距離等預測變數之間的關係。使用 0.05 的顯著水準來評估模型的統計顯著性和適合度。步驟如下:
- 收集所需資料。
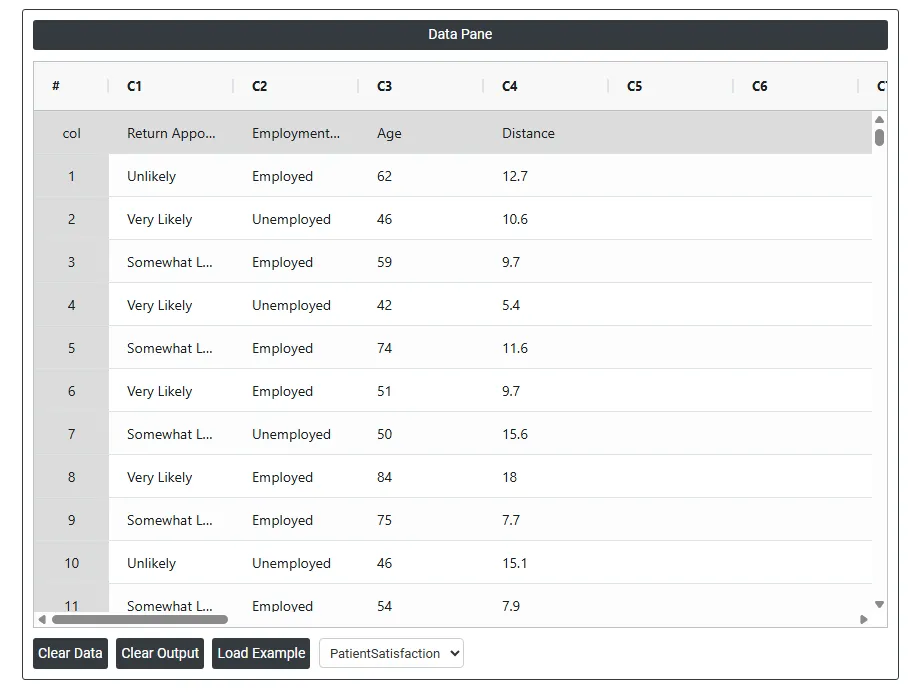
- 現在,在 Zometric Statistical Software 中分析資料,網址為 https://statsai.zometric.com/。
- 要找到順序邏輯迴歸,請選擇 Statistical module> Regression>Ordinal Logistic Regression.
- 在工具中,輸入資料及其他輸入項如下:
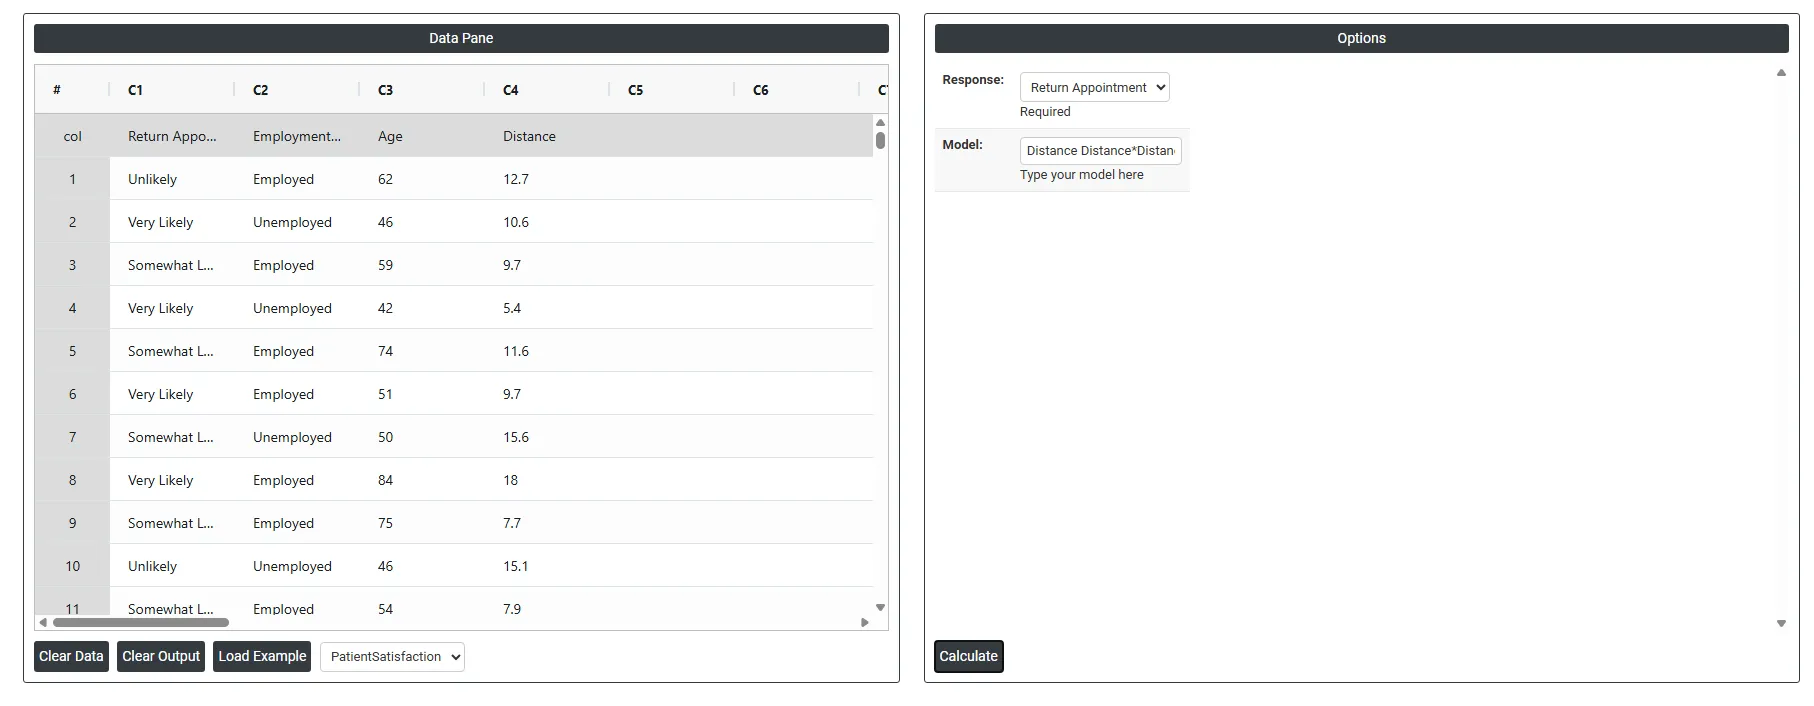
5. 使用上述工具後,得到的輸出如下:
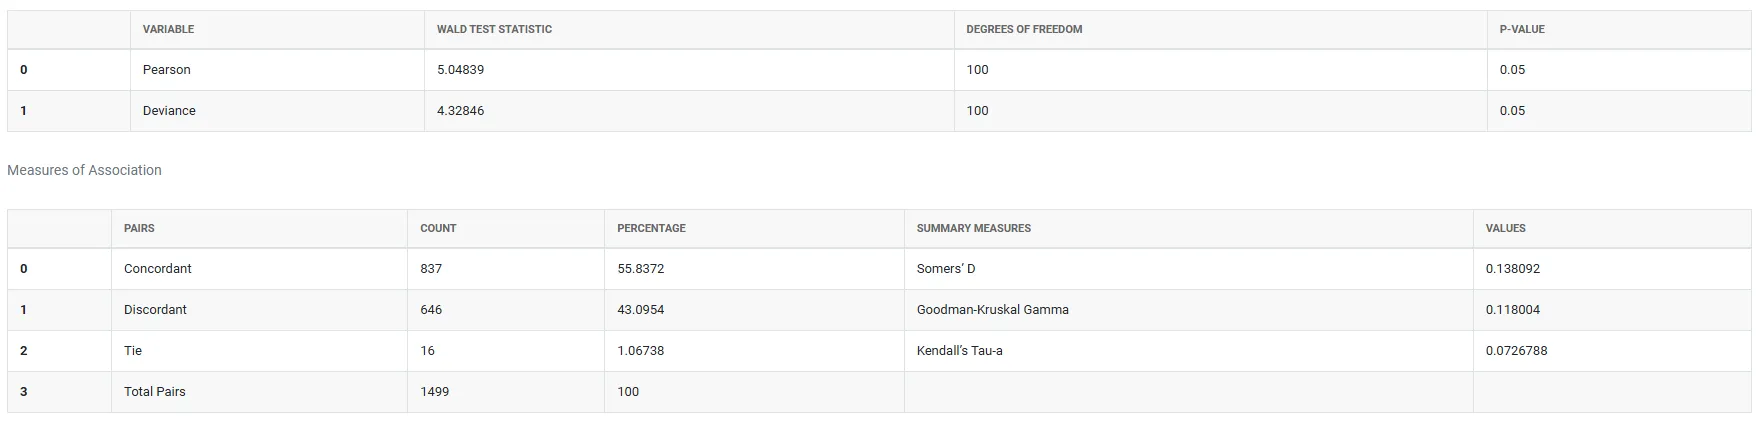
如何進行順序邏輯迴歸
操作步驟如下:
- 登入 Zometric Statistical Software,網址為 https://statsai.zometric.com/
- 在首頁選擇 Statistical Tool> Regression > Ordinal Logistic Regression.
- 接下來,手動更新資料,或從 Excel 表格中複製(Ctrl+C)資料並貼上(Ctrl+V)到此處,也可以使用 Load Example 選項載入範例資料。
- 接下來,填寫所需的選項。
- 最後,點選頁面底部的 calculate,即可得到所需結果。
在順序邏輯迴歸的工具介面中,視窗分為兩部分。
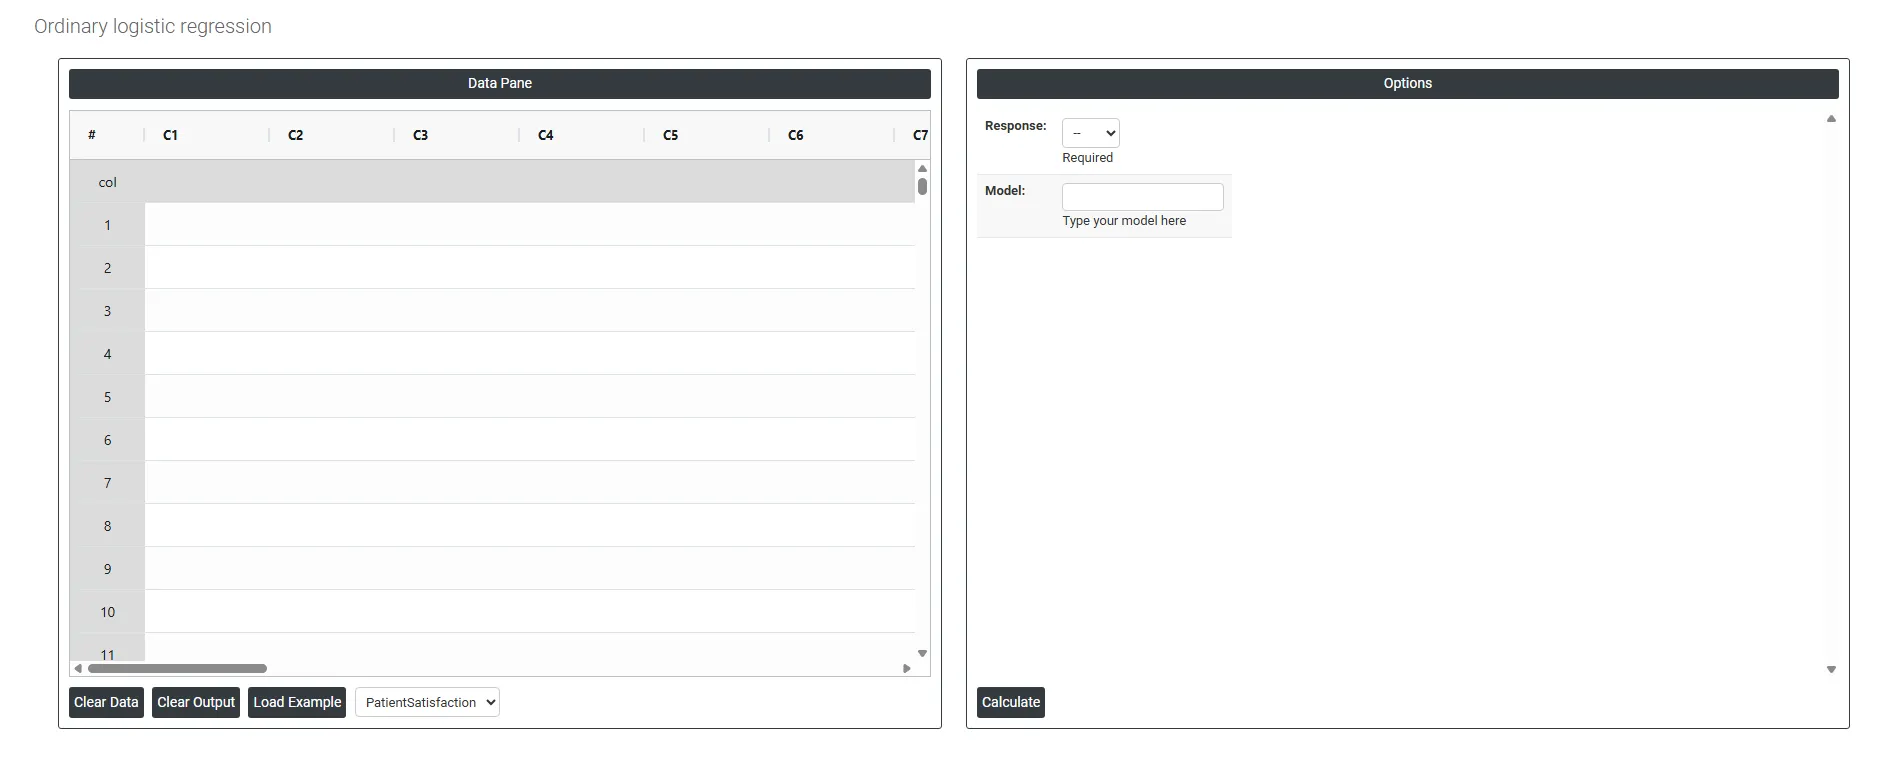
左側是資料窗格(Data Pane)。在 Data Pane 中,每一列構成一個子群組。可手動輸入資料,也可從 Excel 表格中完整複製(Ctrl+C)資料並貼上(Ctrl+V)到此處。
Load example:將載入範例資料。
Load File: 用於直接載入 Excel 資料。
右側提供以下選項:
- Response: 反應是您要預測或研究的結果變數。在順序邏輯迴歸中,反應必須包含 三個或更多具有自然、有意義順序的類別 ——即類別可以排序,但類別之間的間隔不必相等。
例如:
隨後,模型根據預測變數計算觀測值落入各類別的機率。 - 疼痛程度 → 輕度 / 中度 / 重度
- 調查回答 → 不同意 / 中立 / 同意
- Model 定義分析的結構,指定模型中包含哪些 預測變數和互動作用項。您可以包含:
- 連續型預測變數 ——數值變數,例如溫度、年齡或劑量
- 分類型預測變數 ——分組變數,例如性別、材料類型或地區
- 互動作用項 ——兩個或多個預測變數的組合,其共同作用可能超出各自單獨的貢獻
常見問題
什麼是順序邏輯迴歸?
順序邏輯迴歸分析一個或多個預測變數與具有三個或更多順序類別(如低/中/高或不同意/中立/同意)的反應之間的關係,這些類別具有自然的等級,但它們之間的距離無法度量。它根據預測變數預測落入各類別的機率。
何時應使用順序邏輯迴歸而不是名目邏輯迴歸?
當反應類別具有有意義的順序(如從不/有時/總是)時,使用順序邏輯迴歸。若順序無關緊要(如劃痕/凹痕/撕裂),請使用名目邏輯迴歸。對於合格/不合格等兩類反應,請使用二元邏輯模型;對於連續型反應,請使用迴歸模型或配適線模型。
什麼是比例優勢假設?
順序邏輯迴歸假定每一對結果組之間的關係是一致的,這稱為比例優勢假設。配適之後應檢查該假設;若不成立,請考慮改用名目邏輯迴歸。使用適合度統計量和殘差診斷來驗證模型。
順序邏輯迴歸可以使用哪些預測變數?
預測變數可以是連續型(如溫度、年齡或劑量)、分類型(如材料類型或地區),或二者混合。離散變數可根據水準數和分析目的視為其中任一類型。模型還可以包含預測變數之間的互動作用項。