
卜瓦松迴歸
卜瓦松迴歸針對固定時間、面積或產品數量內的事件計數,建立其與連續型和分類預測變數之間的模型。應使用它而不是普通迴歸,因為計數不能為負,且其離散程度隨平均值增大。假定反應服從卜瓦松分配,採用對數、平方根或恆等連結函數。輸出包括係數、偏差分析、適合度檢定和殘差圖。
最後審閱
核心要點
卜瓦松迴歸是一種廣義線性模型,用最大概似法配適,將每班缺陷數或每月故障次數等計數型反應與連續型和分類預測變數聯絡起來。
用途
卜瓦松迴歸將每班缺陷數、每月故障次數或每塊面板瑕疵數等計數型反應與連續型和分類預測變數聯絡起來。當反應是固定時間、面積或產品數量內的事件計數時,應使用它而不是普通迴歸:計數不能為負,且其離散程度隨平均值增大,而最小平方法並未考慮這一點。
主要功能
- 連續型和分類預測變數,並可從項列表中選擇互動作用項和平方項。
- 對數(預設)、平方根或恆等連結函數。
- 對項進行逐步、向前選擇或向後剔除,並可將某些項強制納入每個模型。
- 含信賴區間和 VIF 的係數、分類預測變數每個水準的迴歸方程、模型彙總和適合度檢定。
- 透過 Wald 檢定或概似比檢定(調整或序貫)進行偏差分析。
- 異常觀測值、殘差圖、主效應圖和互動作用圖,以及配適計數的等高線圖和曲面圖。
- 對您輸入的設定進行預測,並提供反應最佳化器。
統計方法
假定反應服從平均值為 μ 的卜瓦松分配,μ 透過連結函數依賴於預測變數:採用對數連結函數時,ln μ = b₀ + b₁x₁ + …,因此預測變數每增加一個單位,每個係數會使期望計數乘以 exp(b)。該模型是用最大概似法(迭代重加權最小平方)配適的廣義線性模型。分類預測變數相對於參考水準採用 (1, 0) 編碼,預設以排序後的第一個水準為參考水準。含遺漏值的列會被剔除;次數欄用於重複列,權重欄用於給出變異數權重。
係數表給出 Wald z 值(Coef / SE Coef)和信賴區間。偏差分析對每一項進行檢定:預設使用 Wald 卡方(連續項為 z²,分類項為對其虛擬變數欄的聯合檢定);使用 LR 檢定時,則依據將該項從完整模型中去掉(調整,Type III)或按順序加入(序貫,Type I)時偏差的變化。Deviance R-Sq = 1 − 殘差偏差 / 零偏差。
適合度檢定將偏差和 Pearson 卡方與誤差自由度對應的卡方分配進行比較。p 值較小,或 Mean(偏差 / DF)遠大於 1,表示計數的變異超出了卜瓦松模型所允許的範圍(過度離散),此時各項的 p 值會偏小。標準化殘差超出 ±2 的觀測值標記為 R,槓桿值大於 3p/n 的觀測值標記為 X。
輸入欄位和選項
欄位 | 說明 |
Response | 計數欄。必填。 |
Continuous Predictors / Categorical Predictor | 數值型和文字(或編碼)預測變數欄;至少一欄。按住 Ctrl 或 Command 並點選可多選。 |
Model terms (optional) | 項列表:勾選各項,或使用 Add all、Interactions 和 Powers,最高至 Terms through order 中選擇的階數(2 或 3)。取消勾選 In model 可去掉線性項而保留其互動作用項。 |
Reference level (optional) | 對於分類預測變數,格式為「Predictor Level」,以逗號分隔。預設:排序後的第一個水準。 |
Stepwise method | None(預設)、Stepwise、Forward selection 或 Backward elimination;另有 Alpha to enter 和 Alpha to remove(0.15)、層次規則、Terms in every model (E)、Initial model terms (I) 以及 Model selection details。 |
Frequency (optional) / Weights (optional) | 列次數欄和權重欄。 |
Link function | Log(預設)、Square root 或 Identity。 |
Confidence level / Type of confidence interval | 預設為 95,Two-sided;或 Lower bound 或 Upper bound。 |
Fits and diagnostics for all observations | 列出每一列的配適值和殘差,而不僅是異常觀測值。 |
Test for ANOVA table / Type of deviance (LR test only) | Wald test(預設)或 LR test;對於 LR,可選 Adjusted (Type III,預設) 或 Sequential (Type I)。 |
Residuals for diagnostics/plots | Deviance(預設)或 Pearson。 |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | 殘差圖。 |
Main effects plot / Interaction plot | 配適計數相對於每個預測變數的變化,其餘預測變數保持在其平均值或參考水準。 |
Contour plot / Surface plot / Overlaid contour plot of fitted values | 需要 X1 和 X2 座標軸變數;疊加等高線圖還需要 Response low 和 Response high。 |
Prediction / Response Optimizer | 新增一個面板,可在您輸入的設定下預測平均計數(含 SE 和信賴區間),或搜尋滿足計數目標的設定。 |
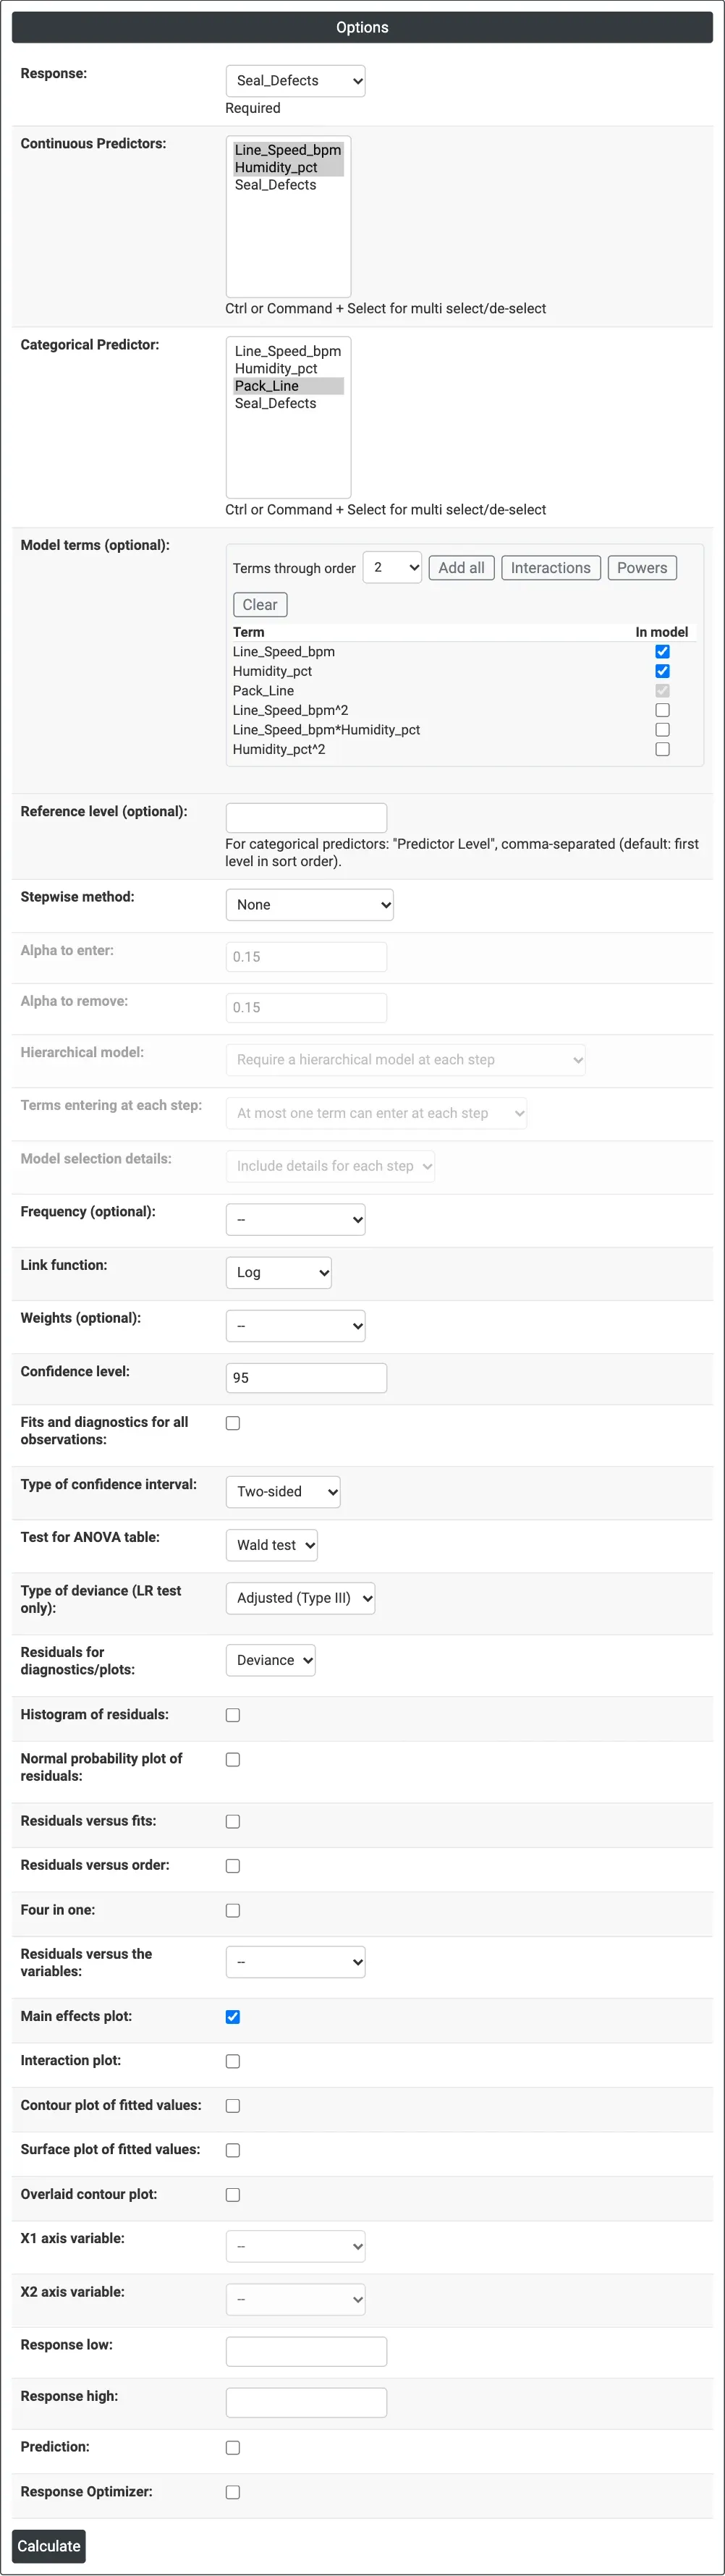
圖 1 — 包裝袋封口範例的選項:以 Seal_Defects 作為反應,線速度和溼度作為連續型預測變數,包裝線作為分類預測變數,並勾選主效應圖。
輸出說明
- Method — 連結函數、分類編碼和所用列數。
- Response Information — 計數的 N、平均值、標準差、最小值和最大值。
- Coefficients — Coef、SE Coef、Z-Value、P-Value、信賴限和 VIF。
- Regression Equation — 分類預測變數每個水準對應的線性預測值 Y'(採用對數連結函數時為期望計數的自然對數)。
- Model Summary — deviance R-Sq、Adj R-Sq、AIC、AICc 和 BIC。
- Goodness-of-Fit Tests — 偏差檢定和 Pearson 卡方檢定。
- Fits and Diagnostics for Unusual Observations(異常觀測值的配適與診斷)。
- Analysis of Deviance — 迴歸和每一項的卡方與 p 值。
- 所選時還包括 Stepwise selection 表、殘差圖、析因圖、等高線圖和曲面圖,以及預測和最佳化器面板。
- 透過 Download 匯出 PDF。
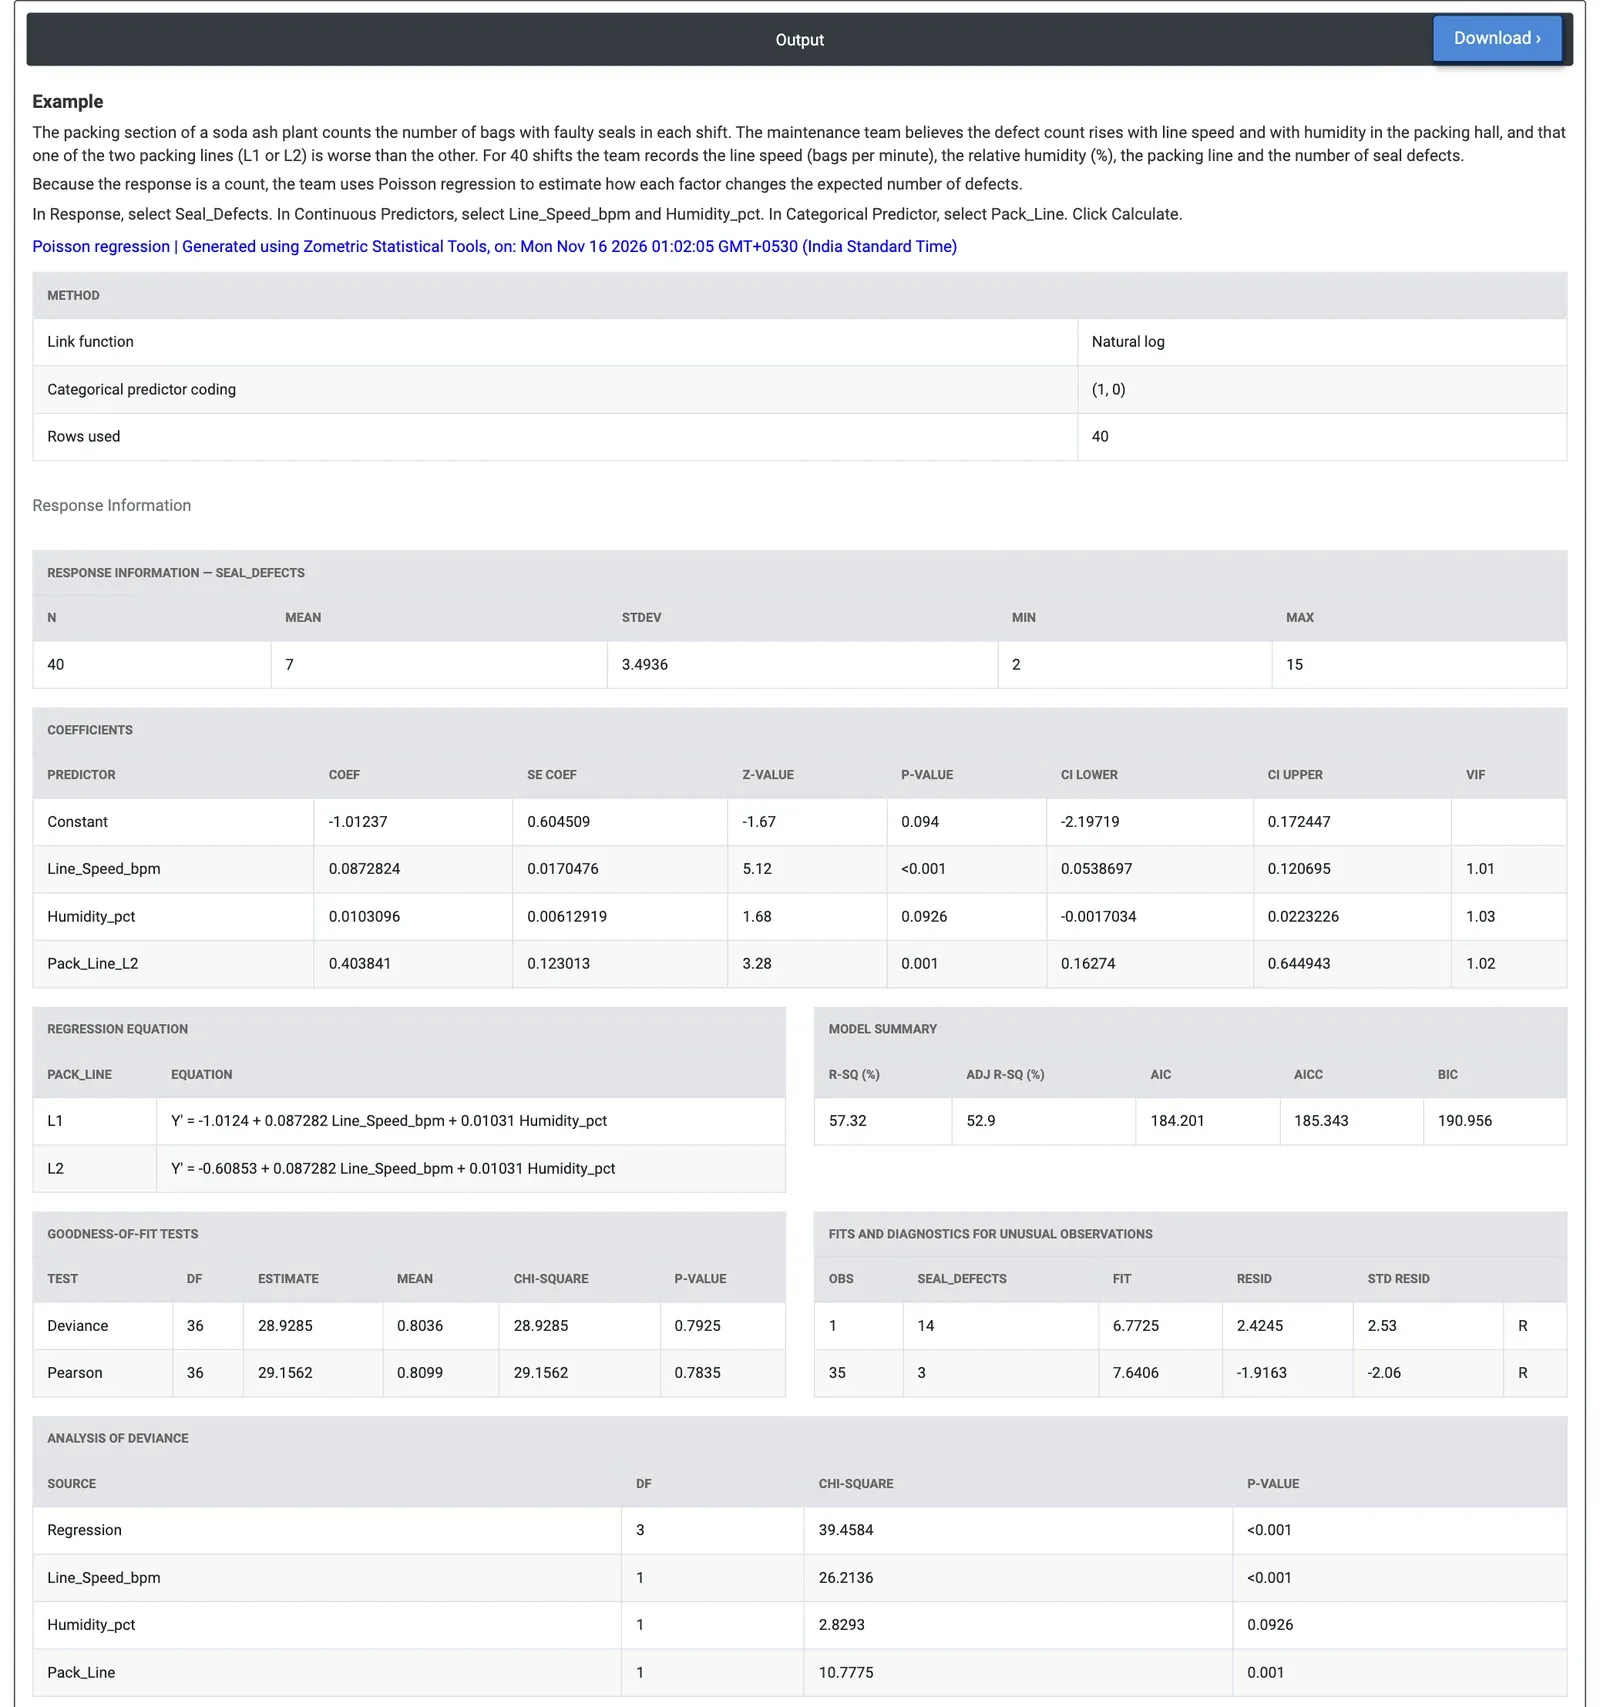
圖 2 — 每班封口缺陷數的卜瓦松迴歸:線速度(p < 0.001)和包裝線(p = 0.001)有影響,溼度在 5% 水準上無影響(p = 0.0926)。
計算範例
某純鹼廠的包裝工段統計每班封口有缺陷的袋數。對於 40 個班次,團隊記錄了線速度(每分鐘袋數)、包裝現場溼度(%)、包裝線(L1 或 L2)以及封口缺陷數(2 至 15,平均值 7)。他們選擇 Seal_Defects 作為反應,線速度和溼度作為連續型預測變數,Pack_Line 作為分類預測變數,並保持對數連結函數。
線速度的影響最強(Wald 卡方 26.21,p < 0.001):其係數 0.0873 表示每分鐘每多一袋,期望缺陷數乘以 exp(0.0873) = 1.09,每分鐘快 5 袋則約乘以 1.55。包裝線 L2 的係數為 0.404(p = 0.001),因此在相同速度和溼度下,其產生的封口缺陷數約為 L1 的 1.50 倍。溼度的方向相同(相對溼度每增加 10%,缺陷約增加 11%),但在 5% 水準上不顯著(p = 0.0926)。
該模型對計數配適良好:偏差卡方 28.93,自由度 36(p = 0.7925),Pearson 為 29.16(p = 0.7835),Mean 小於 1,因此沒有過度離散的跡象。有兩個班次被標記:班次 1 缺陷數為 14,而配適值為 6.8;班次 35 缺陷數為 3,而配適值為 7.6。團隊首先檢查 L2 的封口夾爪和速度設定值,並在決定是否除溼之前繼續收集溼度資料。
常見問題
何時應使用卜瓦松迴歸而不是普通最小平方迴歸?
當反應是固定時間、面積或產品數量內的事件計數(如每班缺陷數或每月故障次數)時,使用卜瓦松迴歸。計數不能為負,且其離散程度隨平均值增大,而最小平方迴歸並未考慮這一點。卜瓦松迴歸將其作為用最大概似法配適的廣義線性模型來處理。
如何解讀卜瓦松迴歸的係數?
採用預設的對數連結函數時,期望計數的自然對數等於 b0 + b1x1 + ...,因此預測變數每增加一個單位,每個係數會使期望計數乘以 exp(b)。例如,線速度係數為 0.0873,表示每分鐘每多一袋,期望缺陷數乘以 exp(0.0873) = 1.09。分類預測變數相對於參考水準進行比較。
如何檢查卜瓦松迴歸中的過度離散?
適合度檢定將偏差和 Pearson 卡方與誤差自由度對應的卡方分配進行比較。p 值較小,或 Mean(偏差除以 DF)遠大於 1,表示計數的變異超出了卜瓦松模型所允許的範圍。此時模型各項的 p 值會偏小,不應輕信。
卜瓦松迴歸中如何標記異常觀測值?
標準化殘差超出正負 2 的觀測值標記為 R,槓桿值大於 3p/n 的觀測值標記為 X。它們列在 Fits and Diagnostics for Unusual Observations 表中,還可以新增殘差與配適值圖、殘差常態機率圖等殘差圖,以進一步考察這些觀測值。