
雙變異數檢定的檢定力與樣本數
規劃比較兩組(如兩臺機器或兩個量具)離散程度的雙變異數檢定。輸入每組樣本數、標準差比和檢定力中的任意兩項,工具即以各組樣本數相等、採用精確 F 分配計算求解第三項。它假定資料服從常態分配,對非常態性敏感。輸出含實際檢定力的結果表和檢定力曲線。
最後審閱
核心要點
雙變異數的檢定力與樣本數用於規劃比較兩個獨立組離散程度的 F 檢定,可求解每組樣本數、檢定力或可檢測的標準差比。
用途
雙變異數的檢定力與樣本數用於規劃兩個獨立組離散程度的比較,例如兩臺機器、兩個量具或兩家供應商的重複性。離散程度的差異以兩個標準差之比 (σ₁/σ₂) 輸入,因此無需輸入標準差本身。輸入樣本數、比值和檢定力中的任意兩項,工具即求解第三項:每組需要多少個單元、計畫的樣本能達到多大檢定力,或給定樣本能檢出的最小比值。請在進行雙變異數檢定之前使用。
主要功能
- 求解樣本數、檢定力或比值:將需要求解的一項留空。
- 可一次輸入多個值,例如比值「1.5 2」和檢定力值「0.8 0.9」,每種組合各給出一列。
- 雙側或單側對立假設,信賴水準可自選。
- 採用精確 F 分配計算,兩組樣本數相等。
- 針對每個比值繪製檢定力隨樣本數變化的檢定力曲線,並標出求解的點。
統計方法
該計算所依據的檢定是雙變異數 F 檢定:當兩組各有 n 個單元且來自常態總體時,若標準差相等,則 F = S₁²/S₂² 服從自由度為 (n − 1, n − 1) 的 F 分配。如果真實比值為 r = σ₁/σ₂,則 F 為這種變數的 r² 倍。顯著水準為 α = 1 − 信賴水準 / 100。
對於「大於」對立假設 (σ₁ > σ₂),檢定力 = P(F > f₁₋α / r²);對於「小於」,檢定力 = P(F < f_α / r²);對於雙尾檢定,兩個尾部都計入,使用 f_α/2 和 f₁₋α/2,即自由度為 (n − 1, n − 1) 的 F 分配的分位數。達到目標檢定力所需的樣本數透過數值方法求得並向上取整,並將該整數對應的檢定力作為實際檢定力報告。求解比值時,對於「小於」對立假設,工具在 1 以下搜尋,其他情況在 1 以上搜尋。
由於兩組樣本數相同,比值 r 與比值 1/r 給出相同的雙側結果(1.5 和 0.667 都需要每組 50 個才能達到 80% 檢定力)。F 檢定假定資料服從常態分配,對偏離常態性很敏感。
輸入欄位和選項
欄位 | 說明 |
Sample sizes | 每組的樣本數。以空格或逗號分隔,例如「10 20 30」。留空則求解樣本數。 |
Ratio(s) | 以空格或逗號分隔,例如「1.5 2」。要檢出的兩個真實標準差之比 (σ₁/σ₂)。留空則求解該比值。 |
Power values | 以空格或逗號分隔,例如「0.8 0.9」。留空則求解檢定力。 |
Confidence level | 預設為 95(α = 0.05);範圍 75 至 100。 |
Alternative hypothesis | σ1/σ2 ≠ 1(預設)、σ1/σ2 < 1 (σ₁ < σ₂) 或 σ1/σ2 > 1 (σ₁ > σ₂)。 |
Power curve | 預設勾選:繪製檢定力隨樣本數變化的曲線。 |
Title | 顯示在輸出和檢定力曲線上的標題。 |
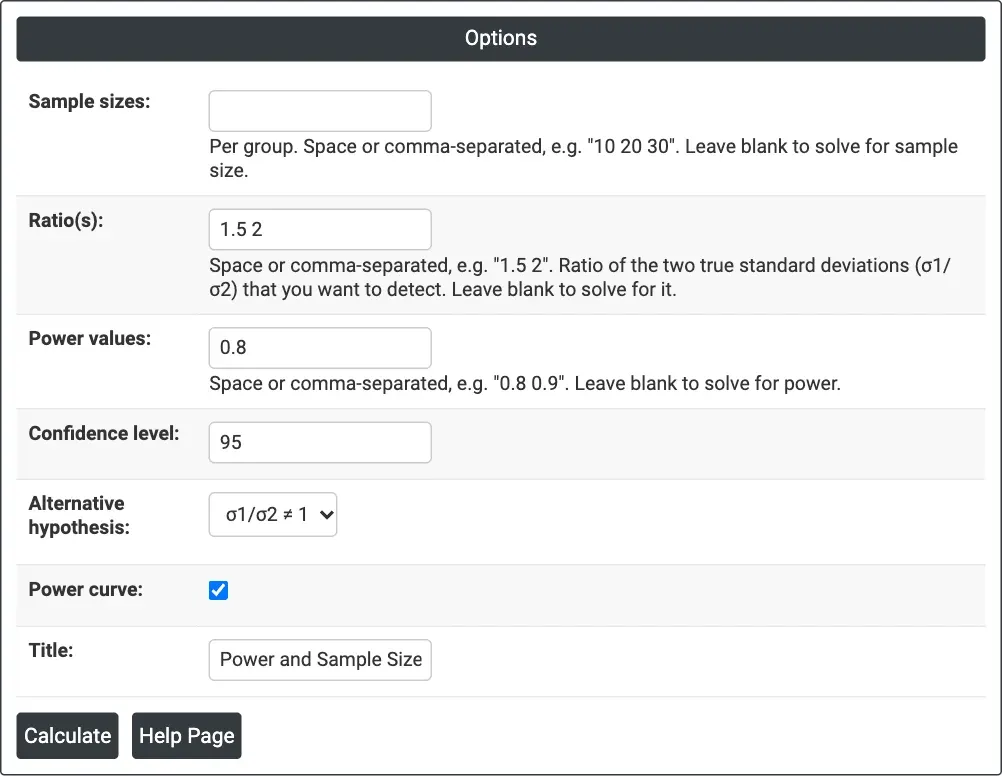
圖 1 — 求解樣本數:Ratio(s) = 1.5 2,Power values = 0.8,95% 信賴水準下雙側。
輸出說明
- Settings — 所求解的項、信賴水準和對立假設。
- Results — 每種組合一列:比值、每組樣本數;求解樣本數時為目標檢定力和實際檢定力,求解檢定力時為檢定力,求解比值時為比值。
- Power Curve — 針對每個比值繪製檢定力隨樣本數變化的曲線,並標出計算得到的點。
- 透過 Download 匯出 PDF。
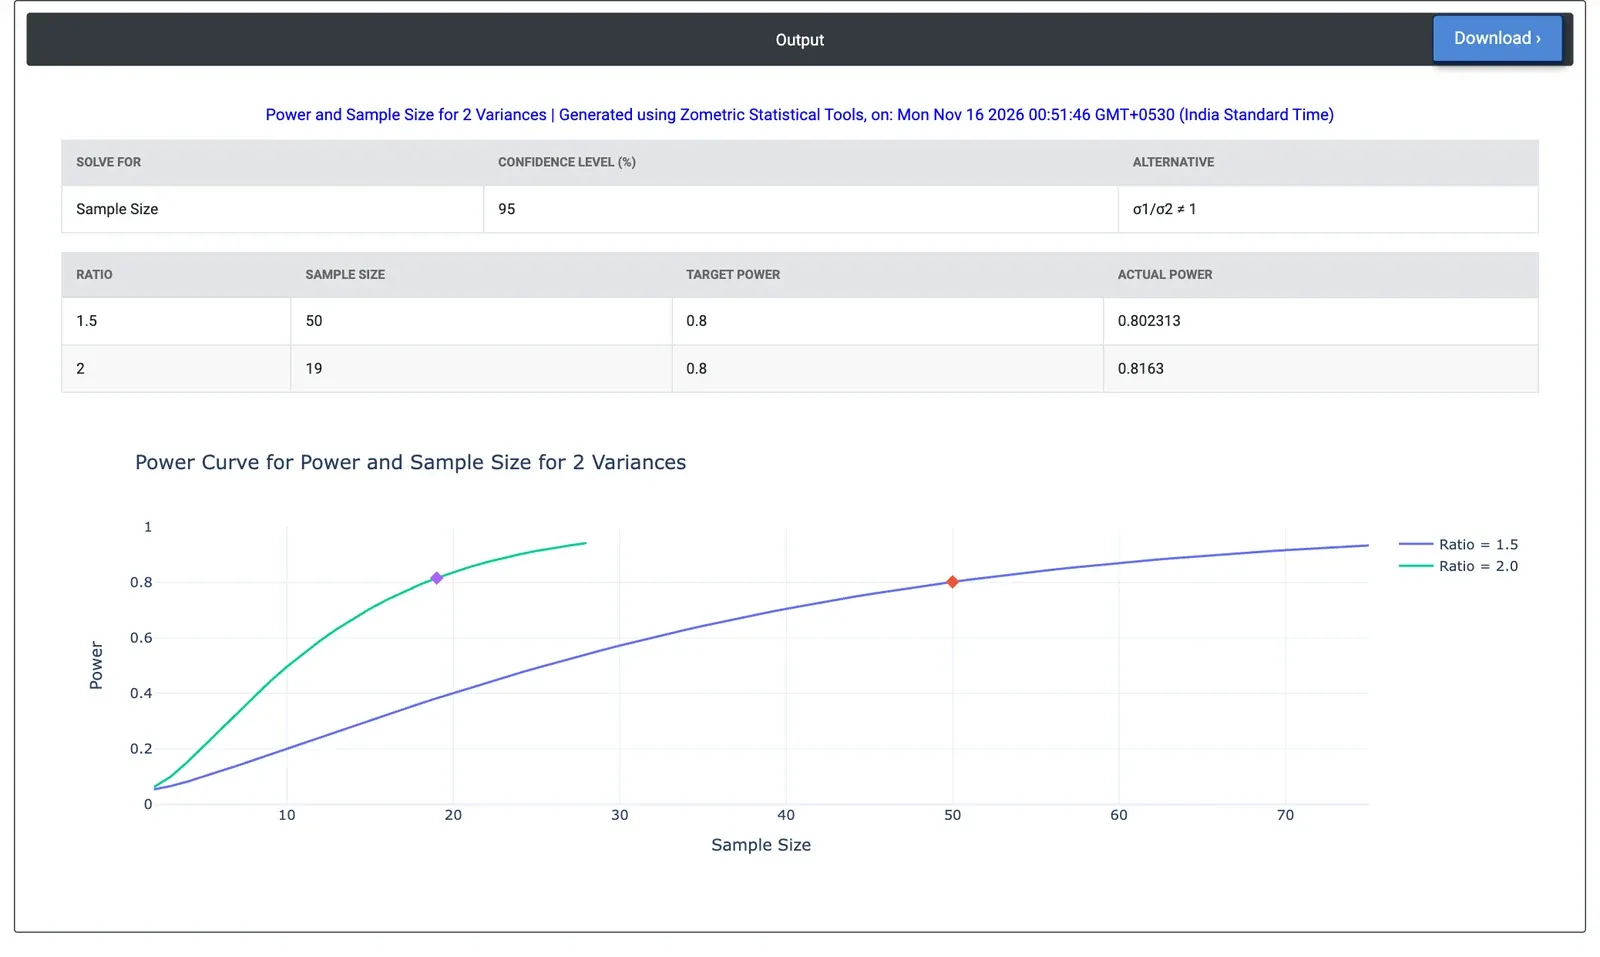
圖 2 — 範例結果:檢出比值 1.5 需要每臺機器 50 個零件,檢出比值 2 需要每臺機器 19 個,二者的檢定力均為 80%。
計算範例
一家機加工現場想比較一臺舊 CNC 機床和一臺新 CNC 機床的孔徑變異。標準差之比為 1.5 時,值得將關鍵工作轉移到較好的機床上,比值為 2 則很嚴重。工程師將 Sample sizes 留空,輸入 Ratio(s) = 1.5 2 和 Power values = 0.8,並保持 95% 信賴水準下的雙側對立假設。
工具需要每臺機器 50 個零件,才能以 80% 的檢定力檢出比值 1.5(實際檢定力 0.802),檢出比值 2 則每臺需要 19 個零件(實際檢定力 0.816)。若要達到 90% 的檢定力,所需數量分別增至每臺機器 66 個和 24 個零件。每臺機器 20 個零件的試驗,對於比值 1.5 的檢定力僅為 0.402,因此這類試驗得到不顯著的結果說明不了什麼。如果只想知道舊機床是否更差(對立假設 σ1/σ2 > 1),則每臺機器 40 個零件即可在比值 1.5 時達到 80% 的檢定力。
常見問題
為什麼離散程度的差異以標準差之比輸入?
雙變異數 F 檢定使用 F = S1 的平方除以 S2 的平方。如果標準差的真實比值為 r,則 F 為自由度 (n - 1, n - 1) 的 F 變數的 r 平方倍,因此只有比值起作用。您輸入比值 sigma1/sigma2 即可,無需標準差本身。
比較兩個變異數需要多少樣本?
在一個計算範例中,95% 信賴水準下雙側,檢出標準差之比 1.5 在 80% 檢定力下需要每臺機器 50 個零件,90% 檢定力下需要 66 個,而比值 2 分別需要 19 個和 24 個。每臺機器 20 個零件的試驗,對於比值 1.5 的檢定力僅為 0.402,因此不顯著的結果說明不了什麼。
比值與其倒數是否按相同方式處理?
對於雙尾檢定,是的。由於兩組樣本數相同,比值 r 與比值 1/r 給出相同的結果:1.5 和 0.667 都需要每組 50 個單元才能達到 80% 檢定力。對於單側對立假設,工具在「小於」對立假設時於 1 以下搜尋,其他情況在 1 以上搜尋。
雙變異數檢定力計算有哪些假設?
它假定兩組均來自常態總體,且樣本數相等。F 檢定對偏離常態性很敏感,因此在進行檢定時應檢查資料的形狀。如果只關心一個方向,單側對立假設所需單元更少:在計算範例中,每臺機器 40 個零件即可在比值 1.5 時達到 80% 的檢定力。