
檢定力與樣本數:單因子變異數分析
規劃比較多個組平均值的單因子變異數分析(One-Way ANOVA)。輸入水準數、共同標準差,以及每個水準的樣本數、平均值間最大差異和檢定力三者中的任意兩個,工具求出第三個。它假定各組服從常態分配、標準差相等且設計均衡,並採用最不利的平均值排列,因此結果偏保守。
最後審閱
核心要點
單因子變異數分析的檢定力與樣本數用於計算每組需要多少單位才能檢出三個或更多組平均值之間給定的最大差異、計算所規劃設計的檢定力,或計算可檢出的差距。
用途
單因子變異數分析的檢定力與樣本數用於規劃三個或更多組平均值的比較,例如多臺爐子、供應商、操作員或配方。效應大小以希望檢出的任意兩個組平均值之間的最大差異輸入。輸入每個水準的樣本數、最大差異和檢定力三者中的任意兩個,工具即可求出第三個:每組需要多少單位、所規劃的設計具有多大的檢定力,或給定設計能檢出的最大與最小平均值之間的差距。可在進行單因子變異數分析(One-Way ANOVA)之前使用。
主要功能
- 求解樣本數、檢定力或最大差異:將想要求解的那個留空。
- 可同時輸入多個值,例如最大差異「1.5 2」和檢定力值「0.8 0.9」,每種組合各給出一列。
- 水準數可為 2 及以上的任意數量,採用均衡設計(每個水準的樣本數相同)。
- 求解樣本數時,報告每個水準的整數樣本數及其對應的實際檢定力。
- 每個最大差異的檢定力隨每個水準樣本數變化的曲線,並標出求解得到的點。
統計方法
計算假定有 k 個相互獨立的組,來自具有共同標準差 σ 的常態母體,每個水準有 n 個單位(總計 N = n·k)。顯著水準為 α = 1 − 信賴水準 / 100。為將最大差異 Δ 轉換為效應量,工具與 Minitab 一樣,採用對該 Δ 給出最小檢定力的平均值排列:兩個水準位於 −Δ/2 和 +Δ/2,其餘 k − 2 個水準位於總平均值。效應量為 f = σₘ/σ,其中 σₘ 是這 k 個平均值的標準差,因此 σₘ² = Δ²/(2k)。
檢定力是變異數分析 F 檢定拒絕平均值相等假設的機率。它根據自由度為 k − 1 和 N − k、非中心參數為 λ = f²·N 的非中心 F 分配計算。對於樣本數,先求出達到目標檢定力的總樣本數 N,再除以 k 並按每個水準向上取整,該樣本數處的檢定力作為實際檢定力報告。對於最大差異,先求出達到目標檢定力的效應量,再換算回 Δ。
由於這是最不利的排列,因此結果偏保守:如果平均值分配得更分散,例如兩個水準位於各個極端,則實際檢定力高於所報告的值,所需單位更少(見計算範例)。只有兩個水準時,只存在一種排列。
輸入欄位和選項
欄位 | 說明 |
Sample sizes | 每個水準的樣本數(均衡設計)。以空格或逗號分隔,例如「10 20 30」。留空則求解樣本數。 |
Maximum difference between means | 以空格或逗號分隔,例如「1 2 3」。希望檢出的最大平均值與最小平均值之間的差距。留空則求解該差異。 |
Power values | 以空格或逗號分隔,例如「0.8 0.9」。留空則求解檢定力。 |
Standard deviation | 必填。假定的或歷史的共同標準差,各水準相同。 |
Number of levels | 必填,至少為 2。被比較的組數。 |
Confidence level | 預設 95(α = 0.05);取值 75 至 100。 |
Power curve | 預設勾選:繪製檢定力隨每個水準樣本數變化的曲線。 |
Title | 輸出和檢定力曲線上顯示的標題。 |
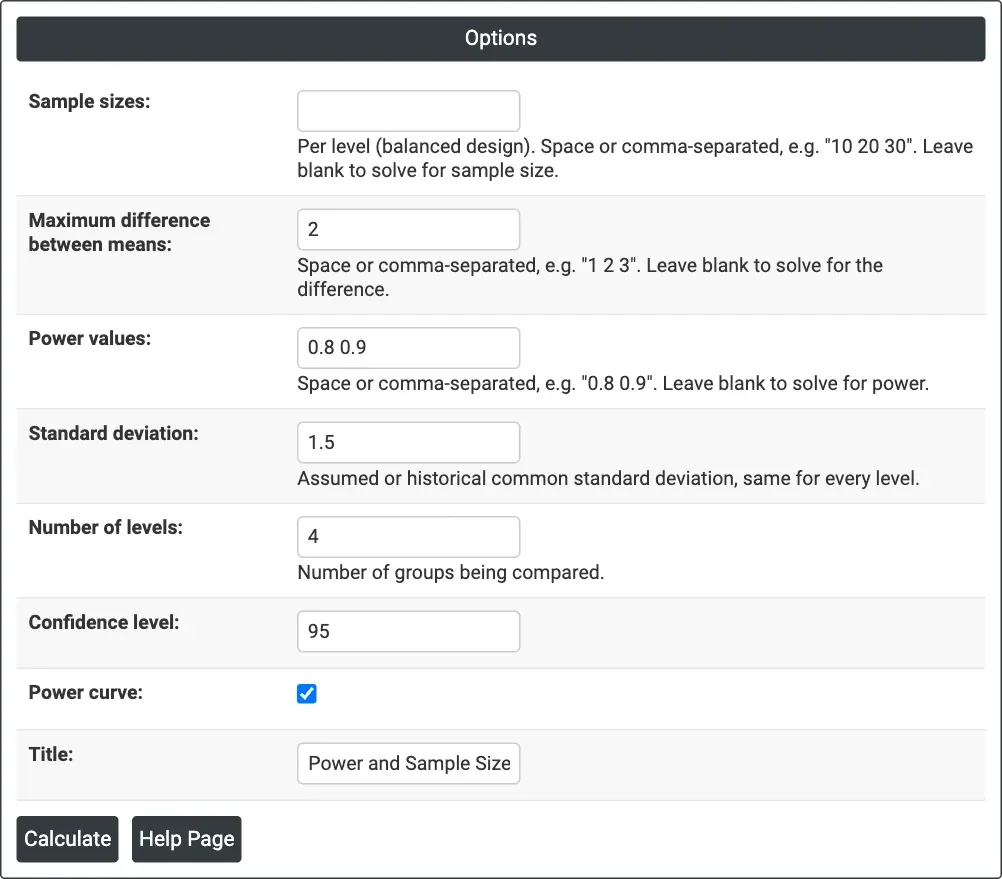
圖 1 — 求解樣本數:Maximum difference between means = 2,Power values = 0.8 0.9,Standard deviation = 1.5,Number of levels = 4,信賴水準 95%。
輸出說明
- Settings——求解的物件、水準數、標準差和信賴水準。
- Results——每種組合一列:求解樣本數時給出最大差異、每個水準的樣本數以及目標檢定力和實際檢定力,求解檢定力時給出檢定力,求解最大差異時給出最大差異。
- Power Curve——每個最大差異的檢定力隨每個水準樣本數變化的曲線,並標出計算得到的點。
- 透過 Download 匯出 PDF。
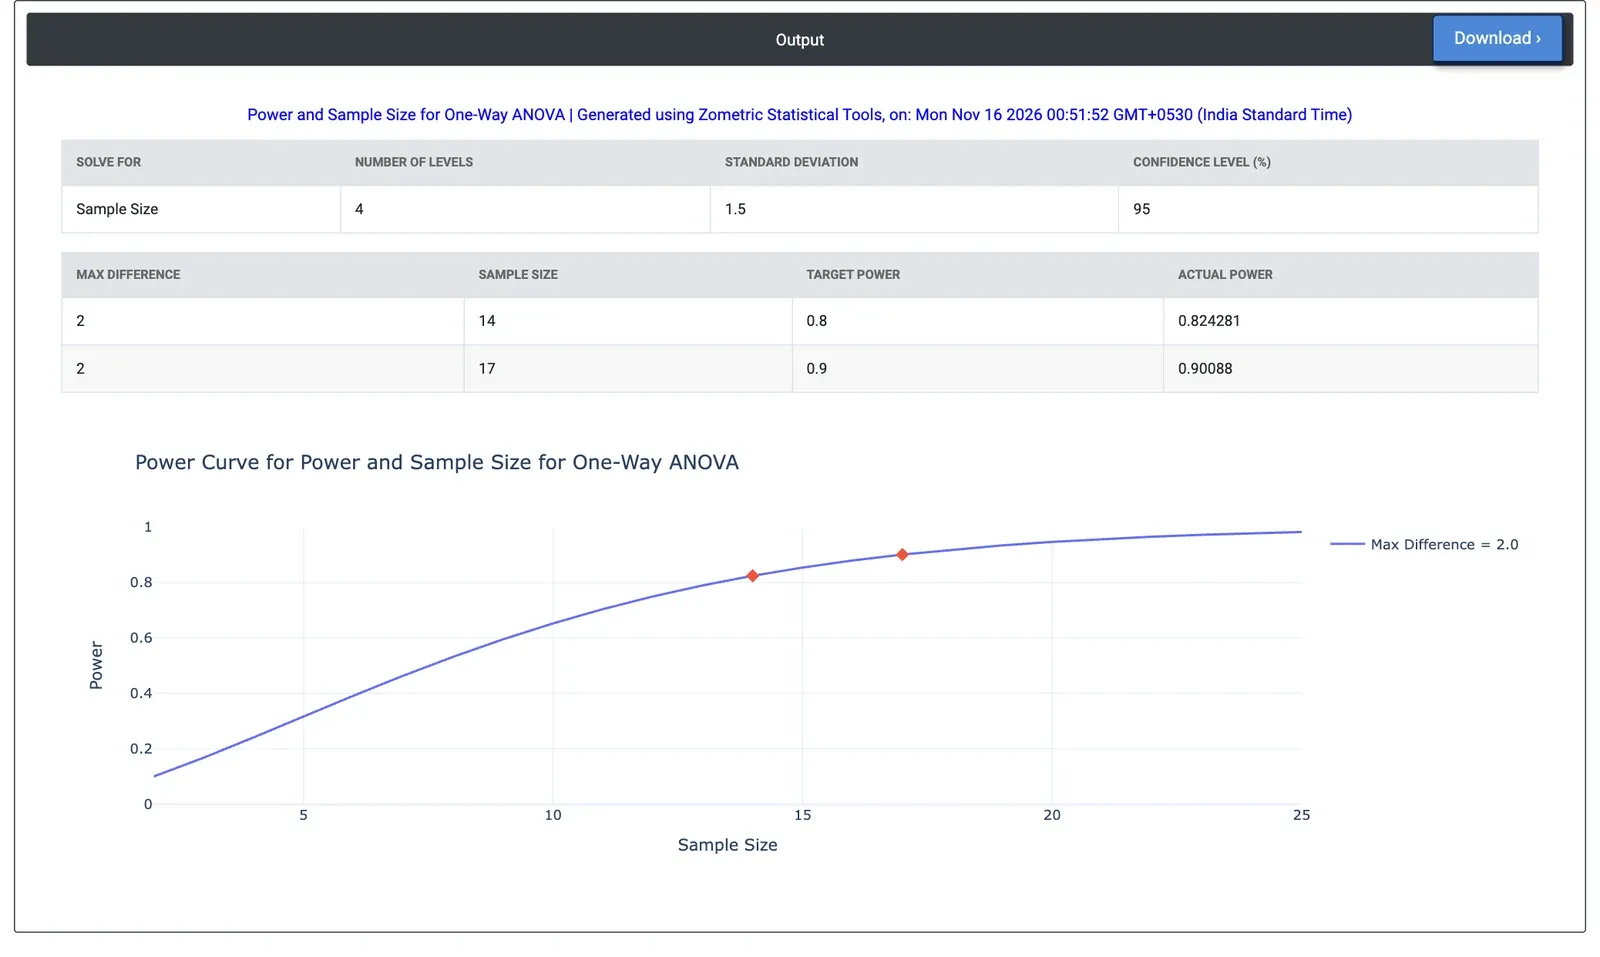
圖 2 — 範例的結果:80% 檢定力每臺爐子需要 14 個零件(實際 0.824),90% 檢定力需要 17 個(實際 0.901)。
計算範例
某熱處理產線運轉四臺爐子,希望檢查它們的平均表面硬度是否相同。最佳爐子與最差爐子之間相差 2 HRC 就會有影響,而單臺爐子內部的硬度標準差約為 1.5 HRC。冶金工程師將 Sample sizes 留空,輸入 Maximum difference between means = 2、Power values = 0.8 0.9、Standard deviation = 1.5 和 Number of levels = 4,信賴水準為 95%。
工具給出:80% 檢定力每臺爐子需要 14 個零件(實際檢定力 0.824),90% 檢定力每臺爐子需要 17 個零件(實際檢定力 0.901),即總共 56 個和 68 個零件。每臺爐子 8 個零件時,檢定力僅為 0.532,5 個零件時為 0.317。每臺爐子 14 個零件、80% 檢定力時,該研究能檢出的最小最大差異為 1.94 HRC。這些數字假定了最不利的模式:一臺爐子偏高、一臺偏低,另外兩臺居中。如果改為每個極端各有兩臺爐子,則每臺爐子 8 個零件就已經能達到 0.852 的檢定力,因此該方案偏於穩妥。
常見問題
單因子變異數分析的檢定力如何計算?
檢定力是變異數分析 F 檢定拒絕平均值相等的機率。它根據自由度為 k - 1 和 N - k 的非中心 F 分配計算。最大差異采用最不利的平均值排列轉換為效應量:兩個水準分別位於差異一半的負值和正值處,其餘水準位於總平均值。
為什麼單因子變異數分析的樣本數偏保守?
工具假定對所輸入的最大差異給出最小檢定力的組平均值排列。如果平均值分配得更分散,例如兩個水準位於各個極端,則實際檢定力高於所報告的值,所需單位更少。在計算範例中,在這種更有利的模式下,每臺爐子 8 個零件即可達到 0.852 的檢定力。
單因子變異數分析每組需要多少樣本?
在一個有四臺爐子、標準差為 1.5 HRC、最大差異為 2 HRC、信賴水準 95% 的計算範例中,每臺爐子 14 個零件可達到 80% 檢定力,17 個零件可達到 90%,即總共 56 個和 68 個零件。每臺爐子 8 個零件時,檢定力為 0.532,5 個零件時為 0.317。
單因子變異數分析檢定力計算有哪些假設?
它假定有 k 個相互獨立的組,來自具有共同標準差的常態母體,且設計均衡,每個水準的樣本數相同。水準數必須至少為 2,且必須提供標準差,通常來自歷史資料。只有兩個水準時,平均值只有一種可能的排列。