
配對 t 檢定的檢定力與樣本數
用於規劃每個單元被量測兩次的配對 t 檢定,例如變更前後。輸入配對差值的標準差,以及對數、平均值差和檢定力中的任意兩項,工具求解第三項。它假定差值大致服從常態分配,並使用非中心 t 分配。輸出包含實際檢定力的結果表和檢定力曲線。
最後審閱
核心要點
配對 t 的檢定力與樣本數工具用於計算:配對 t 檢定需要多少對資料才能檢出有意義的平均值差,計畫的對數所能達到的檢定力,或可檢出的最小平均值差。
用途
配對 t 的檢定力與樣本數(Power and Sample Size for Paired t)用於規劃每個單元被量測兩次的研究,例如變更前後、使用兩種方法或在兩個夾具上量測,所關心的問題是平均值差是否為零。它回答:需要多少對資料才能檢出有意義的平均值差,計畫的對數能達到多大的檢定力,或給定的對數能檢出的最小平均值差是多少。輸入樣本數、差值和檢定力中的任意兩項,工具即可求解第三項。在進行配對 t 檢定之前使用。
主要功能
- 求解對數、檢定力或差值:將想求解的一項留空。
- 可一次輸入多個值,例如差值「0.5 1」和檢定力值「0.8 0.9」,每種組合給出一列結果。
- 雙側(Mean difference ≠ 0)或單側(Mean difference < 0、Mean difference > 0)對立假設,信賴水準可自行選擇。
- 求解樣本數時,報告整數對數及其對應的實際檢定力。
- 針對每個差值繪製檢定力隨對數變化的檢定力曲線,並標出求解得到的點。
統計方法
配對 t 檢定是對每對資料內差值進行的單樣本 t 檢定,因此計算方法即對差值應用單樣本 t 檢定。它假定差值大致服從常態分配,標準差為 σ_d。顯著水準為 α = 1 − 信賴水準 / 100,標準化差值為 d = 平均值差 / σ_d。
檢定力根據自由度為 n − 1、非中心參數為 δ = d·√n 的非中心 t 分配計算,其中 n 為對數:對於雙尾檢定,檢定力 = P(T > t₁₋α/₂) + P(T < −t₁₋α/₂);對於單尾檢定,只計入對立假設一側的尾部,因此位於另一側的平均值差給出的檢定力接近 0(據此求解樣本數會返回錯誤資訊)。對於樣本數,找到能達到目標檢定力的 n 並向上取整,在該 n 處的檢定力作為實際檢定力報告。對於差值,找到在給定 n 下能達到目標檢定力的最小平均值差。
應輸入的標準差是配對差值的標準差,而不是單一讀數的標準差。當同一單元的兩次讀數同向變化時,σ_d 遠小於單元之間的離散程度,這就是配對設計通常比兩個獨立組所需單元少得多的原因。檢定力隨對數和差值的增大而上升,隨 σ_d 的增大而下降。
輸入欄位和選項
欄位 | 說明 |
Sample sizes | 對數。以空格或逗號分隔,例如「10 20 30」。留空則求解樣本數。 |
Differences | 以空格或逗號分隔,例如「1 2 3」。希望檢出的配對平均值差。留空則求解差值。 |
Power values | 以空格或逗號分隔,例如「0.8 0.9」。留空則求解檢定力。 |
Standard deviation of the differences | 必填。配對差值的假定標準差或歷史標準差,例如來自試執行。 |
Confidence level | 預設值為 95(α = 0.05);範圍 75 至 100。 |
Alternative hypothesis | Mean difference ≠ 0(預設)、Mean difference < 0 或 Mean difference > 0。 |
Power curve | 預設勾選:繪製檢定力隨樣本數變化的曲線。 |
Title | 顯示在輸出和檢定力曲線上的標題。 |
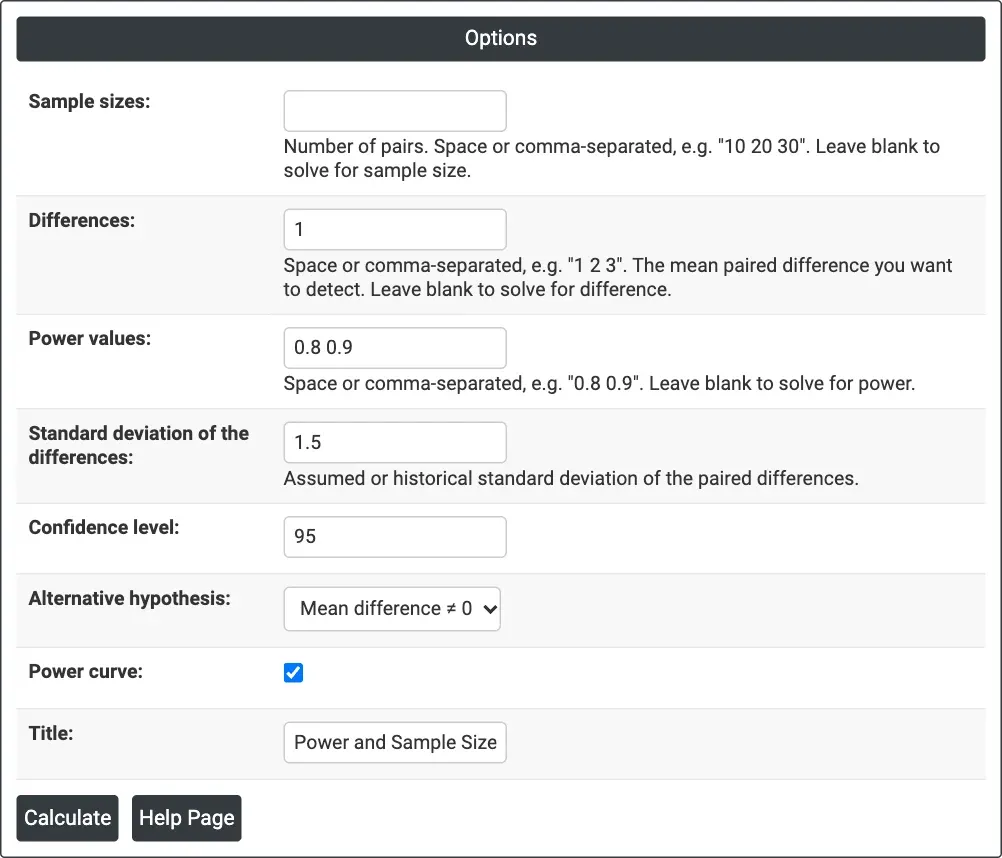
圖 1 — 求解樣本數:Differences = 1,Power values = 0.8 0.9,Standard deviation of the differences = 1.5,信賴水準 95%,雙側。
輸出說明
- Settings —— 求解的物件、差值的標準差、信賴水準和對立假設。
- Results —— 每種組合一列:差值、樣本數(對數);求解樣本數時給出目標檢定力和實際檢定力,求解檢定力時給出檢定力,求解差值時給出差值。
- Power Curve —— 每個差值的檢定力隨樣本數變化的曲線,並標出計算得到的點。
- 透過 Download 匯出 PDF。
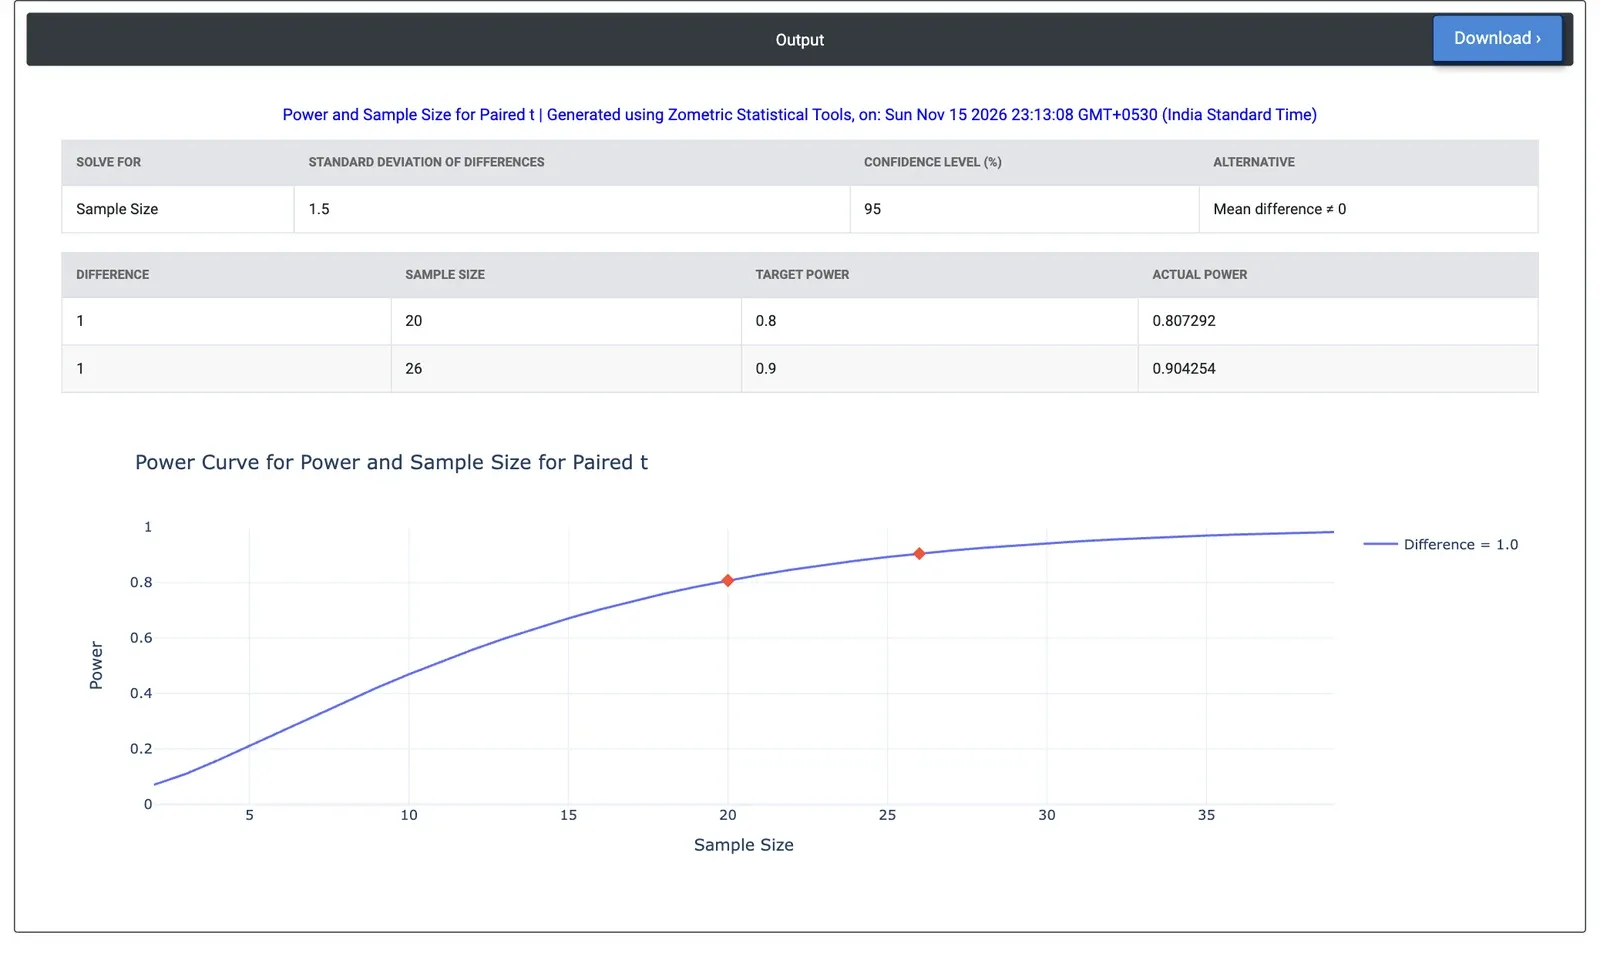
圖 2 — 範例結果:檢出油耗 1 g/kWh 的變化,80% 檢定力需要 20 臺引擎,90% 檢定力需要 26 臺。
計算範例
某引擎工廠正在試用新的標定軟體,並將在臺架上對每臺引擎在更新前後各測試一次。比油耗變化 1 g/kWh 就有意義,而此前的前後對比試驗給出的差值標準差為 1.5 g/kWh。試驗工程師將 Sample sizes 留空,輸入 Differences = 1、Power values = 0.8 0.9 和 Standard deviation of the differences = 1.5,並保持雙側對立假設和 95% 的信賴水準。
工具顯示,80% 檢定力需要 20 臺引擎(實際檢定力 0.807),90% 檢定力需要 26 臺(實際檢定力 0.904)。一週內可用的 12 臺引擎只能給出 0.558 的檢定力。如果臺架結果的雜訊比預期更大,σ_d = 2 g/kWh,則 80% 檢定力需要 34 臺引擎。如果唯一的問題是油耗是否改善,採用單側對立假設時,80% 檢定力需要 16 臺引擎。
常見問題
配對 t 檢定的檢定力如何計算?
配對 t 檢定是對每對資料內差值進行的單樣本 t 檢定,因此檢定力根據自由度為 n - 1、非中心參數為 d 乘以 n 的平方根的非中心 t 分配計算,其中 n 為對數,d 為平均值差除以差值的標準差。
為什麼配對設計比兩個獨立組所需的單元更少?
當同一單元的兩次讀數同向變化時,配對差值的標準差遠小於單元之間的離散程度。由於檢定力取決於平均值差相對於該標準差的大小,配對設計通常比兩個獨立組所需的單元少得多。應輸入差值的標準差,而不是單一讀數的標準差。
配對 t 檢定需要多少對資料?
在一個計算範例中,檢出 1 g/kWh 的變化,差值標準差為 1.5 g/kWh,信賴水準 95%,雙側,20 臺引擎給出 80% 的檢定力,26 臺給出 90%。12 臺引擎給出的檢定力為 0.558。如果差值的雜訊更大,達到 2 g/kWh,則 80% 檢定力需要 34 臺引擎。
配對 t 檢定應採用單側還是雙側?
當只有一個方向重要時(例如油耗是否改善),使用單側對立假設;在計算範例中,80% 檢定力只需 16 臺引擎,而不是 20 臺。單尾檢定只計入對立假設一側的尾部,因此位於另一側的平均值差給出的檢定力接近 0,據此求解樣本數會返回錯誤。