
機率圖
機率圖將有序資料繪製在使分配呈直線的刻度上,並帶有信賴界限,用於檢驗資料是否配適某一分配。它支援包括 Normal、Lognormal、Weibull 和 Exponential 在內的九種分配,並為每種分配報告 Anderson-Darling 統計量和 p 值。可在進行假定常態性的能力分析、管制界限或 t 檢定之前使用,也可用於選擇可靠度分配。
最後審閱
核心要點
機率圖透過將有序資料繪製在使所選分配呈直線的刻度上,檢驗資料是否服從所選分配(最常用的是常態分配),並給出 Anderson-Darling 統計量和 p 值。
用途
機率圖用於檢驗資料是否服從所選分配,最常用的是常態分配。有序資料被繪製在使所選分配呈直線的刻度上:如果各點沿直線分配,則該分配配適。可在進行假定常態性的能力分析、管制界限、容忍區間或 t 檢定之前使用,也可用於為可靠度或非常態能力研究選擇分配(Weibull、對數常態、指數)。
主要功能
- 九種分配:Normal、Lognormal、Weibull、Exponential、2-Parameter Exponential、Smallest Extreme Value、Largest Extreme Value、Logistic 和 Loglogistic。
- 帶有所選水準(預設 95%)的逐點信賴界限的配適參考線。
- 圖例中給出每種分配的 Anderson-Darling(AD)統計量及其 p 值,便於比較各分配的配適程度。
- 可將多個變數疊加在一張圖上,或用 By 欄將一個變數分成若干組,每組各有一條配適線。
- 對於 Lognormal、Weibull 和 Loglogistic,資料軸採用對數刻度,與標準機率紙相同。
統計方法
對每個變數或組(至少 3 個值),將資料排序,x₍₁₎ ≤ … ≤ x₍ₙ₎,並為每個值賦予繪圖位置 pᵢ = (i − 0.3) / (n + 0.4),即 Benard 中位等級近似。縱軸為所選分配的反累積分配函數,以百分數標註,因此來自該分配的樣本會落在接近直線的位置。參考線為配適的累積分配函數:對於 Normal,使用樣本平均值和標準差(除數為 n − 1);對於其他分配,使用最大概似法,其中 Lognormal、Weibull、Exponential 和 Loglogistic 的閾值固定為 0(這些分配要求取正值)。
信賴界限穿過每個點繪製:在水準 C 下,下界為 Beta(i, n − i + 1) 分配的 α/2 分位數,上界為 Beta(i + 1, n − i) 分配的 1 − α/2 分位數,其中 α = 1 − C/100。超出界限的點是反對該分配的證據。
Anderson-Darling 統計量 AD = −n − (1/n) Σ (2i − 1)[ln F(x₍ᵢ₎) + ln(1 − F(x₍ₙ₊₁₋ᵢ₎))] 度量各點與配適累積分配函數 F 的距離,並對尾部賦予額外權重;越小越好。圖例中顯示每種分配的這一未經調整的 AD,與 Minitab 相同。p 值來自修正後的統計量,如 D'Agostino 和 Stephens 所述:對於 Normal 和 Lognormal(取對數後),AD·(1 + 0.75/n + 2.25/n²) 再用 Stephens 近似換算;對於 Weibull 和兩種極值分配,為 AD·(1 + 0.2/√n);對於 Exponential,為 AD·(1 + 0.6/n);對於 Logistic 和 Loglogistic,為 AD·(1 + 0.25/n)。後三者透過查 Stephens 臨界值表並插值得到,因此超出表範圍的 p 值以界限形式顯示,如 >0.250 或 <0.010。對於 2-Parameter Exponential,將 n − 1 個間隔 x₍ᵢ₎ − x₍₁₎ 作為指數分配進行檢定。p 值低於 0.05 表明資料不服從該分配;在各分配之間,p 值越大通常表示配適越接近。
輸入欄位和選項
欄位 | 說明 |
Variables | 必填。一個數值欄,或多個疊加的欄(「Multiple」機率圖)。 |
By (grouping) column | 可選。每組一條配適線。僅在選擇單一變數時使用。 |
Distribution | Normal(預設)、Lognormal、Weibull、Exponential、2-Parameter Exponential、Smallest Extreme Value、Largest Extreme Value、Logistic 或 Loglogistic。 |
Confidence level (%) | 預設 95;範圍 1 至 99.99。信賴界限的水準。 |
Display confidence interval bounds | 預設勾選。以虛線繪製界限。 |
Title | 圖的標題。預設為「Probability Plot」。 |
Data Options: Subset (optional) | Exclude matching rows(預設)或 Include only matching rows;透過 Row numbers(例如 3,7,12-15)和/或 Condition(例如 Tensile_Strength_MPa > 205)選擇列。 |
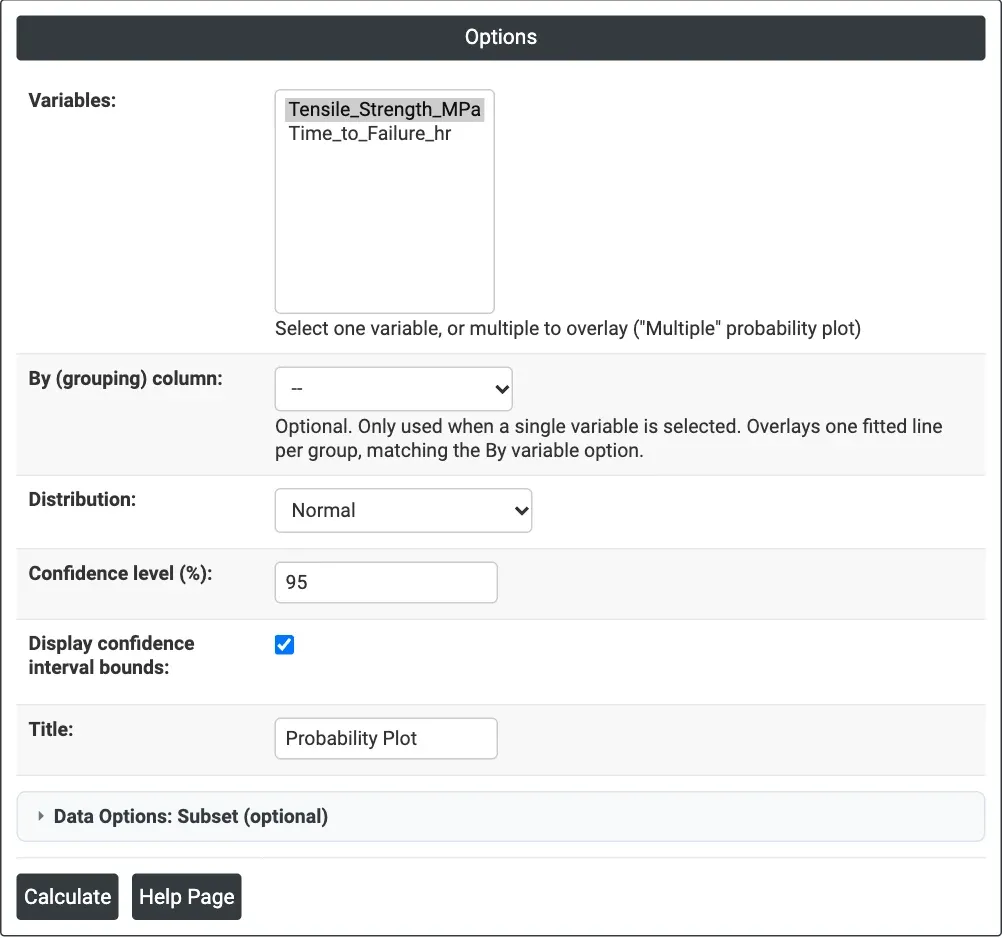
圖 1 — 範例所用選項:Tensile_Strength_MPa 的 Normal 機率圖,95% 界限。
輸出說明
- Probability Plot — 資料(橫軸)對分配機率刻度上的百分數,帶有配適線和虛線信賴界限。圖例給出每個系列的 AD 統計量及其 p 值。
- 透過 Download 匯出 PDF。
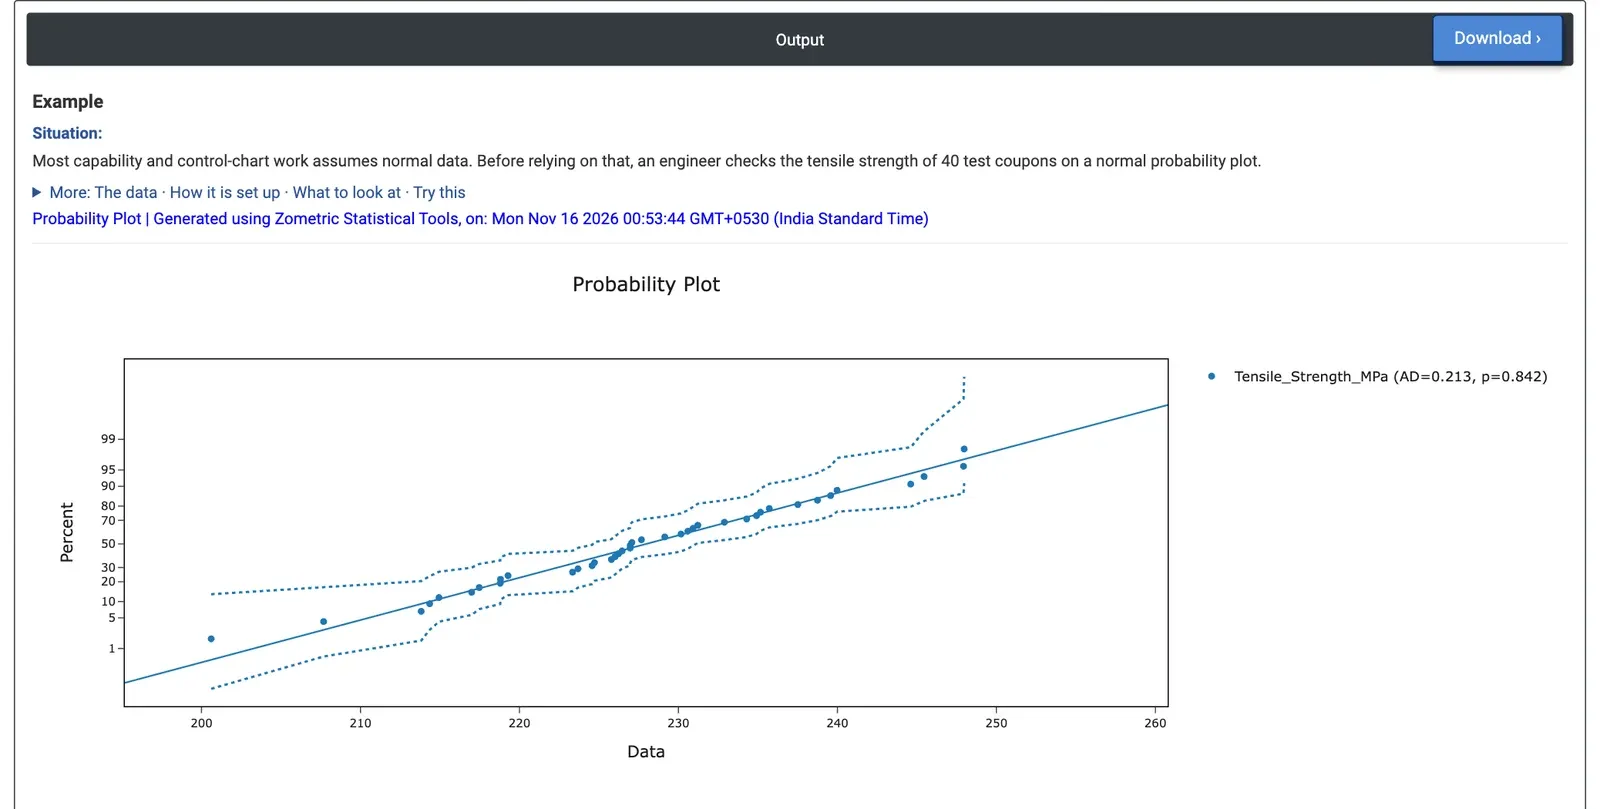
圖 2 — 40 個試樣抗拉強度的 Normal 機率圖:AD = 0.213,p = 0.842。
計算範例
在設定管制界限和計算能力之前,一名工程師檢查 40 個試樣的抗拉強度是否可視為常態。Variables = Tensile_Strength_MPa,Distribution = Normal,Confidence level 為 95,顯示界限。
各點沿直線分配,在從 200.61 到 247.97 MPa 的整個範圍內都位於虛線界限之內。圖例顯示 AD = 0.213,p = 0.842,遠高於 0.05:沒有證據反對常態性。配適線的平均值為 227.97 MPa,標準差為 10.61 MPa,因此可以使用基於常態分配的能力和管制圖方法。如果兩端的點偏離直線彎曲,則表明分配偏斜或為重尾分配。
同一工作表中還有 40 個失效時間(小時)。將 Time_to_Failure_hr 對多種分配作圖,得到 Weibull 的 AD = 0.210,p > 0.250(形狀參數 3.23,尺度參數 192.96 小時),Normal 的 AD = 0.158,p = 0.947,Lognormal 的 AD = 1.228,p < 0.005,Exponential 的 AD = 7.628,p < 0.010。假定失效率恆定的 Exponential 明顯不配適,Lognormal 也不配適。Weibull 和 Normal 都配適良好;對於失效時間,通常選擇 Weibull,因為其形狀參數大於 1 可描述磨損失效,且不會預測出負的壽命。
常見問題
如何解讀機率圖?
如果各點沿配適直線分配並位於信賴界限之內,則該分配配適。超出界限的點是反對該分配的證據,兩端的點偏離直線彎曲則表明分配偏斜或為重尾分配。圖例給出 Anderson-Darling 統計量和 p 值;p 值低於 0.05 表明資料不服從該分配。
何時應使用機率圖?
用於在進行假定資料常態的能力分析、管制界限、容忍區間或 t 檢定之前檢定常態性。它也用於為可靠度或非常態能力研究選擇分配,如 Weibull、對數常態或指數分配。每個變數或組至少需要 3 個值,並且可以疊加多個變數或組。
如何在機率圖上比較各分配?
將同一資料對多種分配作圖,比較 Anderson-Darling 統計量和 p 值;AD 越小、p 值越大,通常表示配適越接近。在一個基於 40 個失效時間的計算範例中,Weibull(p > 0.250)和 Normal(p = 0.947)配適良好,而 Lognormal 和 Exponential(p < 0.010)不配適。
機率圖可以檢驗哪些分配?
九種:Normal、Lognormal、Weibull、Exponential、2-Parameter Exponential、Smallest Extreme Value、Largest Extreme Value、Logistic 和 Loglogistic。Lognormal、Weibull、Exponential 和 Loglogistic 要求取正值,Lognormal、Weibull 和 Loglogistic 使用對數資料軸,與標準機率紙相同。