
隨機資料
隨機資料從 26 種分配之一(包括 Normal、Lognormal、Weibull、Triangular、Binomial、Poisson 和 Multivariate Normal)中抽取 10 到 10,000 列、最多 10 個獨立欄的資料。數值的抽取沒有固定種子,因此每次執行都會得到新的數字。可選的四捨五入以及包含直方圖、Anderson-Darling 常態性檢定、信賴區間和機率圖的圖形彙總,可用於描述所產生的資料。
最後審閱
核心要點
隨機資料可從 26 種連續、離散或多元常態分配中的任意一種產生隨機數,並放入資料窗格,用於訓練資料、模擬、假設情景研究,以及觀察樣本的變異程度。
用途
隨機資料從 26 種分配之一產生隨機數,並放入資料窗格,可直接複製或用於其他工具。可用它製作訓練用的練習資料,觀察來自已知製程的樣本有多大的變異(來自理想常態製程的 30 個值的直方圖很少呈鐘形),在真實資料到來之前試用某項分析,或模擬某個製程進行假設情景研究,例如根據三角分配估計的週期時間,或根據韋伯模型得到的失效時間。可選的圖形彙總用於描述所產生的數字。
主要功能
- Distribution 清單中共有 26 種分配:連續分配(Normal、Lognormal、Weibull、Exponential、Gamma、Uniform、Triangular 等)、離散分配(Binomial、Poisson、Geometric、Hypergeometric、Integer、Discrete 等)以及 Multivariate Normal。
- 僅顯示所選分配的參數欄位。
- 10 到 10,000 列,1 到 10 個獨立欄(data_1、data_2……)。
- 可選擇將數值四捨五入到指定的小數位數。
- 可選的所有產生值的圖形彙總:直方圖、彙總統計量、Anderson-Darling 常態性檢定、信賴區間和機率圖。
- Multivariate Normal:根據平均值向量和協變異數矩陣產生相關的欄,並給出樣本相關矩陣和協變異數矩陣以供核對。
統計方法
數值使用 NumPy 和 SciPy 隨機數產生器獨立抽取,沒有固定種子,因此每次 Calculate 都會得到新的數字。每一欄都是來自同一分配、大小為所選值的單獨樣本。參數遵循通常的定義:例如 Normal(平均值 μ,標準差 σ)、Weibull(形狀 β,尺度 η,可選的閾值會加到每個值上)、Exponential(尺度 = 平均值,可選閾值)、Integer(從 Minimum 到 Maximum 的整數,兩端均包含)、Geometric(直到並包括首次事件為止的試驗次數)和 Negative Binomial(達到所需事件數之前的非事件數)。對於 Lognormal,輸入的是資料本身的平均值和標準差:工具會將其轉換為對數尺度參數 σ = √ln(1 + (s/m)²) 和 μ = ln(m) − σ²/2。對於 Discrete,各機率會重新縮放使其總和為 1。
勾選 Graphical Summary 後,所有欄會合併為一個樣本並加以描述:平均值、標準差、變異數、偏度、峰度、N、最小值、四分位數、中位數、最大值和變異係數(%);Anderson-Darling 常態性檢定(A 平方和 p 值);平均值(t)、中位數(Hettmansperger-Sheather)和標準差(卡方)的 95% 信賴區間。勾選 Exclude outliers 後,落在 Q1 − 1.5×IQR 或 Q3 + 1.5×IQR 之外的值僅從彙總中剔除;所產生的資料仍保留這些值。對於 Multivariate Normal,協變異數矩陣必須是方陣、對稱、半正定,並且與平均值的個數一致。
輸入欄位和選項
欄位 | 說明 |
Distribution | 必填。26 種分配之一;下方的參數欄位會隨之變化。 |
Number of rows of data to generate | 必填,10 到 10,000。 |
Number of columns | 預設值為 1,最多 10。每欄是一個獨立樣本。Multivariate Normal 不使用此項(每個平均值對應一欄)。 |
Graphical Summary | 預設不勾選。將所產生值的圖形彙總新增到輸出中。 |
Exclude outliers (1.5×IQR rule) | 可選。除非勾選了 Graphical Summary,否則不起作用;勾選後,僅從彙總中剔除離群值。 |
Decimals | 可選,0 到 10。對連續分配(Normal、Lognormal、Weibull、Exponential、T、F、Beta、Cauchy、Chi-Square、Gamma、Laplace、極值分配、Logistic、Loglogistic、Triangular 和 Uniform)所產生的值進行四捨五入。對於 Normal,至少保留足以顯示標準差的小數位數。對於給出整數或列出值的分配(Binomial、Poisson、Bernoulli、Discrete、Geometric、Hypergeometric、Integer 和 Negative Binomial)以及 Multivariate Normal,不顯示此項。 |
Mean / Standard Deviation | Normal;Lognormal(資料的平均值和標準差);Poisson 僅使用 Mean。 |
Number of trials / Event probability | Binomial。僅 Event probability:Bernoulli 和 Geometric;與 Number of events (required successes) 一起使用:Negative Binomial。 |
Shape parameter / Scale parameter / Threshold parameter | Weibull(threshold 可選);Gamma 和 Loglogistic 使用 shape 和 scale。 |
Scale parameter / Threshold parameter | Exponential(threshold 可選)。 |
Location parameter / Scale parameter | Cauchy、Laplace、Largest Extreme Value、Smallest Extreme Value 和 Logistic。 |
Degrees of freedom / Numerator and Denominator degrees of freedom | T 和 Chi-Square;F。 |
First shape parameter / Second shape parameter | Beta。 |
Values / Probabilities | Discrete。以逗號或空格分隔,個數相同,例如「1 2 3」和「0.2 0.3 0.5」(如果總和不為 1,則重新正規化)。 |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric。事件數和樣本數不能超過母體大小。 |
Minimum / Maximum / Mode (most likely value) | Integer(minimum 和 maximum);Triangular(三項都需要,mode 介於二者之間)。 |
Lower endpoint / Upper endpoint | Uniform。 |
Means / Covariance matrix | Multivariate Normal。Means 每個變數一個,例如「10 20 30」;協變異數矩陣的各列以分號分隔,例如「4,2,0; 2,9,1; 0,1,1」。 |
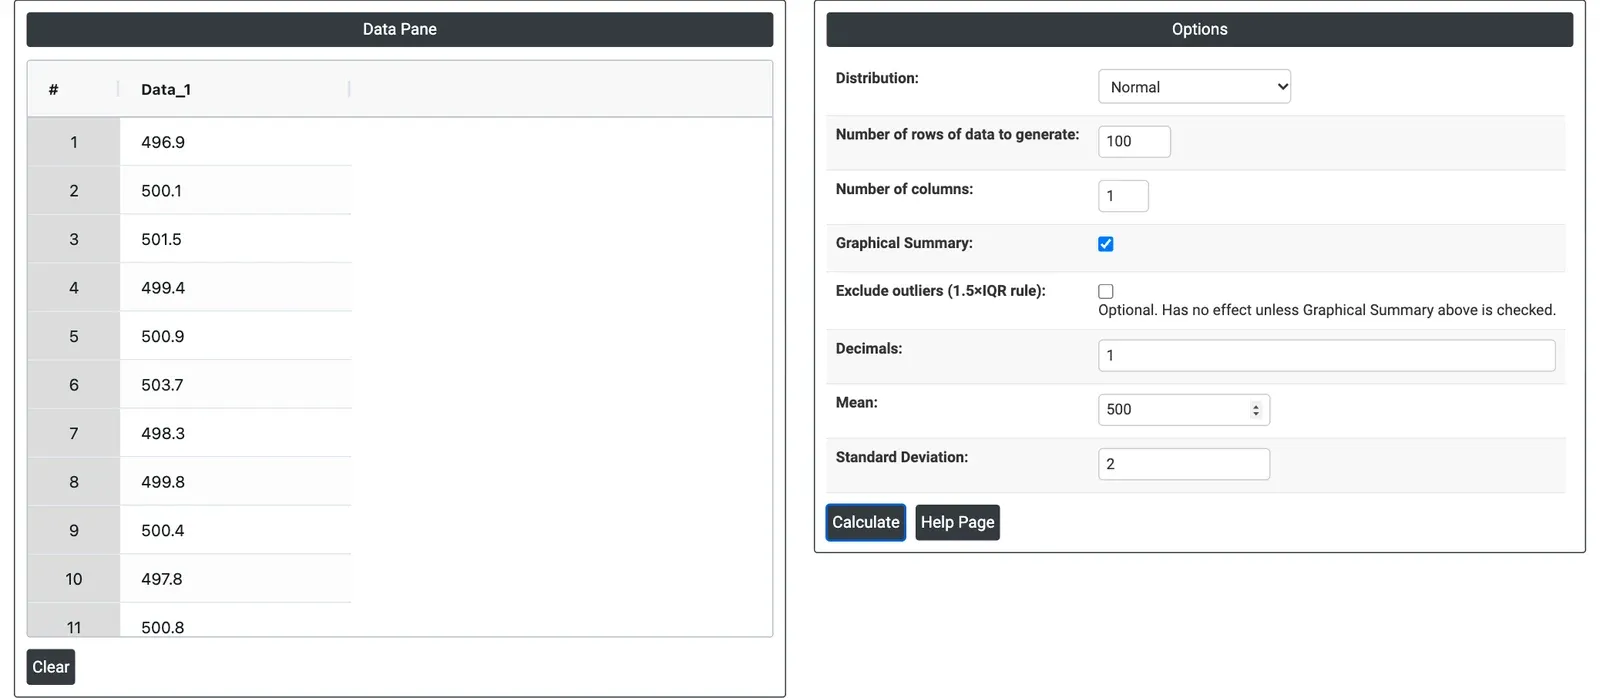
圖 1 — 資料窗格(左)中來自平均值為 500、標準差為 2 的 Normal 分配的 100 個值,四捨五入到 1 位小數,右側為 Options。
輸出說明
- Data Pane — 所產生的值,每個樣本一欄(data_1、data_2……),替換原有內容。
- Graphical summary(勾選時)— 帶配適常態曲線的直方圖和盒鬚圖;彙總表,包含 A-Squared、p-value、Mean、StDev、Variance、Skewness、Kurtosis、N、Minimum、1st Quartile、Median、3rd Quartile、Maximum 和 Coeff Var;平均值和中位數的 95% Confidence Intervals 圖;帶 Anderson-Darling 結果的 Probability Plot;以及平均值、中位數和標準差的 95% 下限和上限表,並給出每個區間的半寬。
- Multivariate Normal — 所產生各欄的樣本相關矩陣和協變異數矩陣。
- 透過 Download as PDF 匯出 PDF。
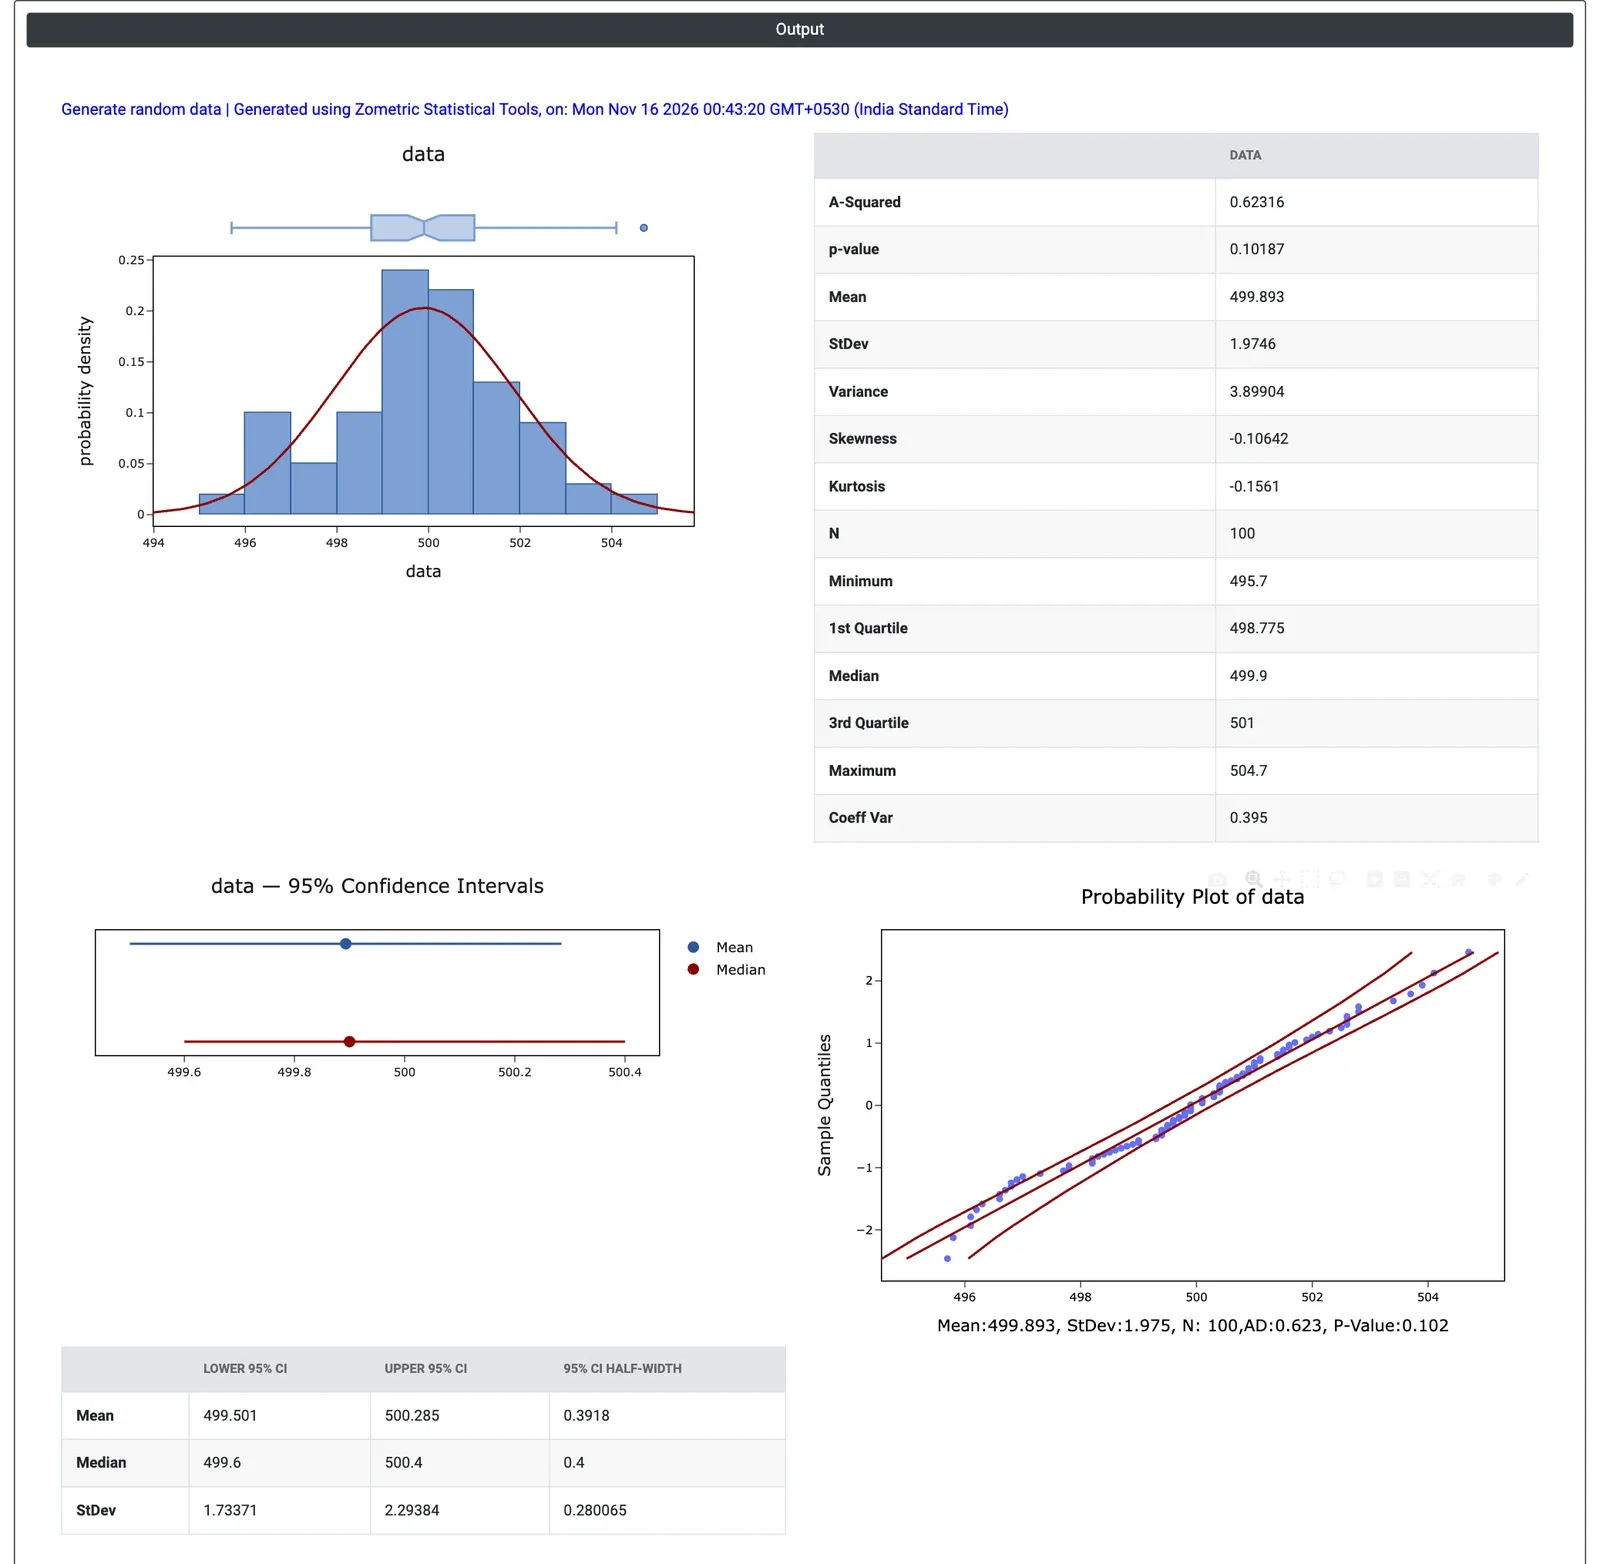
圖 2 — 100 個產生值的圖形彙總:平均值 499.89,StDev 1.97,Anderson-Darling p 值 0.102。
計算範例
某品質訓練師為充填線操作員準備關於製程變異的訓練課程。該生產線充填 500 g 的瓶子,標準差約為 2 g。為了展示僅由正常變異造成的情形,訓練師選擇 Distribution = Normal、Number of rows = 100、Number of columns = 1、Mean = 500、Standard Deviation = 2 和 Decimals = 1,並勾選 Graphical Summary。
模擬的 100 個充填重量介於 495.7 至 504.7 g 之間,平均值為 499.89 g,標準差為 1.97 g,並不恰好是 500 和 2,儘管製程設定得完全精確。直方圖參差不齊,並非整齊的鐘形曲線,但 Anderson-Darling 檢定給出 p = 0.102,因此沒有證據表明資料不服從常態分配。平均值的 95% 信賴區間 499.50 至 500.29 g(半寬 0.39 g)包含真實值 500,標準差的區間 1.73 至 2.29 g 包含真實值 2。
要向操作員說明的要點是:一個穩定且居中的製程仍會產生偏離目標 4 g 的單一瓶子,以及與真實值不同的樣本統計量。每次 Calculate 都會抽取新的樣本,數字略有不同,訓練師可藉此展示樣本之間的變異。產生 5 欄、每欄 20 列,可得到五個小樣本供比較,也可以將資料複製到能力分析或管制圖工具中進行練習。
常見問題
隨機資料產生在品質工作中有什麼用途?
它用於製作訓練用的練習資料,觀察來自已知製程的樣本有多大的變異,在真實資料到來之前試用某項分析,以及模擬某個製程進行假設情景研究,例如根據三角分配估計的週期時間,或根據韋伯模型得到的失效時間。所產生的資料可複製到能力分析或管制圖等其他工具中。
可以從哪些分配產生隨機資料?
共有 26 種:連續分配,如 Normal、Lognormal、Weibull、Exponential、Gamma、Uniform 和 Triangular;離散分配,如 Binomial、Poisson、Geometric、Hypergeometric、Integer 和 Discrete;以及 Multivariate Normal,它根據平均值向量和協變異數矩陣產生相關的欄。僅顯示所選分配的參數欄位。
為什麼隨機樣本與母體平均值和標準差並不完全一致?
每個樣本都會因偶然因素而變化。在一個計算範例中,來自平均值為 500、標準差為 2 的常態製程的 100 個值,樣本平均值為 499.89,標準差為 1.97,直方圖參差不齊而非鐘形,但 Anderson-Darling 檢定給出 p = 0.102,表明沒有證據顯示資料不服從常態分配。
產生隨機資料時如何輸入對數常態分配的參數?
對於 Lognormal 分配,輸入的是資料本身的平均值和標準差,而不是對數的平均值和標準差。工具會將其轉換為對數尺度參數:sigma 等於 ln(1 + (s/m) 的平方) 的平方根,mu 等於 ln(m) 減去 sigma 的平方除以 2。