
隨機指數資料
隨機指數資料模擬獨立事件(如機器故障或顧客到達)之間的等待時間,假定失效率恆定(無記憶性)。您需設定列數和欄數、尺度(即事件間平均時間,1/速率),以及可選的、使數值整體上移的門檻值。如果失效率隨時間變化,請改用隨機韋伯資料。
最後審閱
核心要點
隨機指數資料根據給定的事件間平均時間,從指數分配產生嚴格為正的值,用於模擬以恆定速率發生的故障間隔時間、到達間隔時間或服務完成時間。
什麼是隨機指數資料?
隨機指數資料從指數分配產生數值,該分配用於對連續獨立事件之間的時間建模,例如機器故障間隔時間、顧客到達間隔時間或服務完成時間。您指定平均值(事件之間的平均時間),工具隨即產生隨機的事件間隔時長。
簡單定義:產生事件之間的隨機等待時間,廣泛用於可靠度工程和排隊分析,以模擬距離下一次故障或到達還有多久。
何時使用隨機指數資料?
- 用於模擬 故障間隔時間、到達間隔時間或服務完成時間。
- 用於 測試可靠度分析,這些分析假定失效率恆定(指數失效模型)。
正確使用隨機指數資料的指南
- 指數分配假定 失效率恆定(無記憶性):如果失效率隨時間變化,請改用韋伯分配。
- 所有產生的值均 嚴格為正。
- 將平均值設為歷史資料中 已知的事件間平均時間。
替代方法:何時不宜使用隨機指數資料
- 如果失效率 隨時間變化,請使用 隨機韋伯資料
- 對於 偏斜的正連續量測值(與時間無關),請使用 隨機對數常態資料
隨機指數資料範例
產生隨機指數資料的步驟如下:
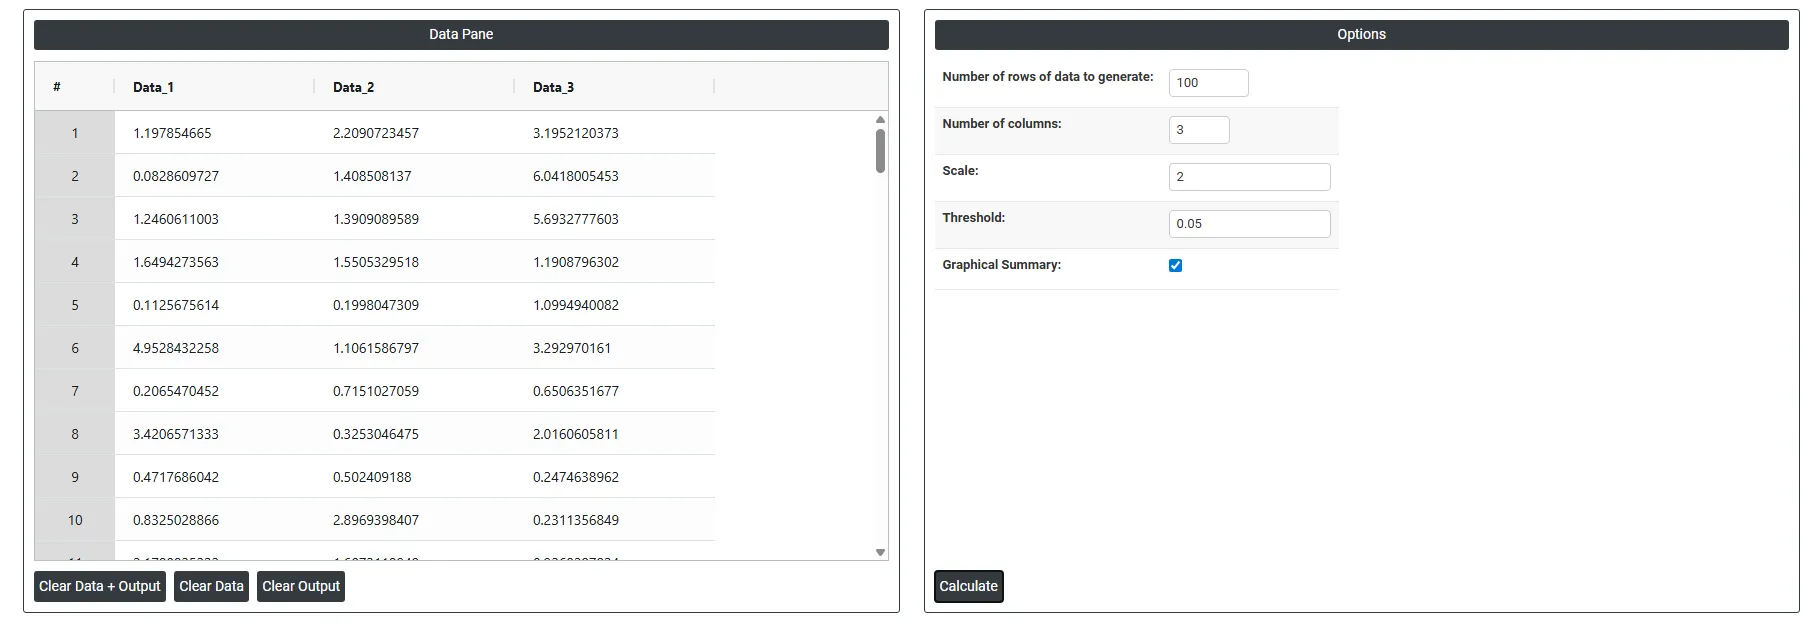
- 要產生隨機指數資料,需要填寫所需選項。
- 現在,在 Zometric Statistical Software 中分析資料,網址為 https://statsai.zometric.com/。
- 要找到隨機指數資料,請選擇 Statistical module> Random Data > Random Exponential Data
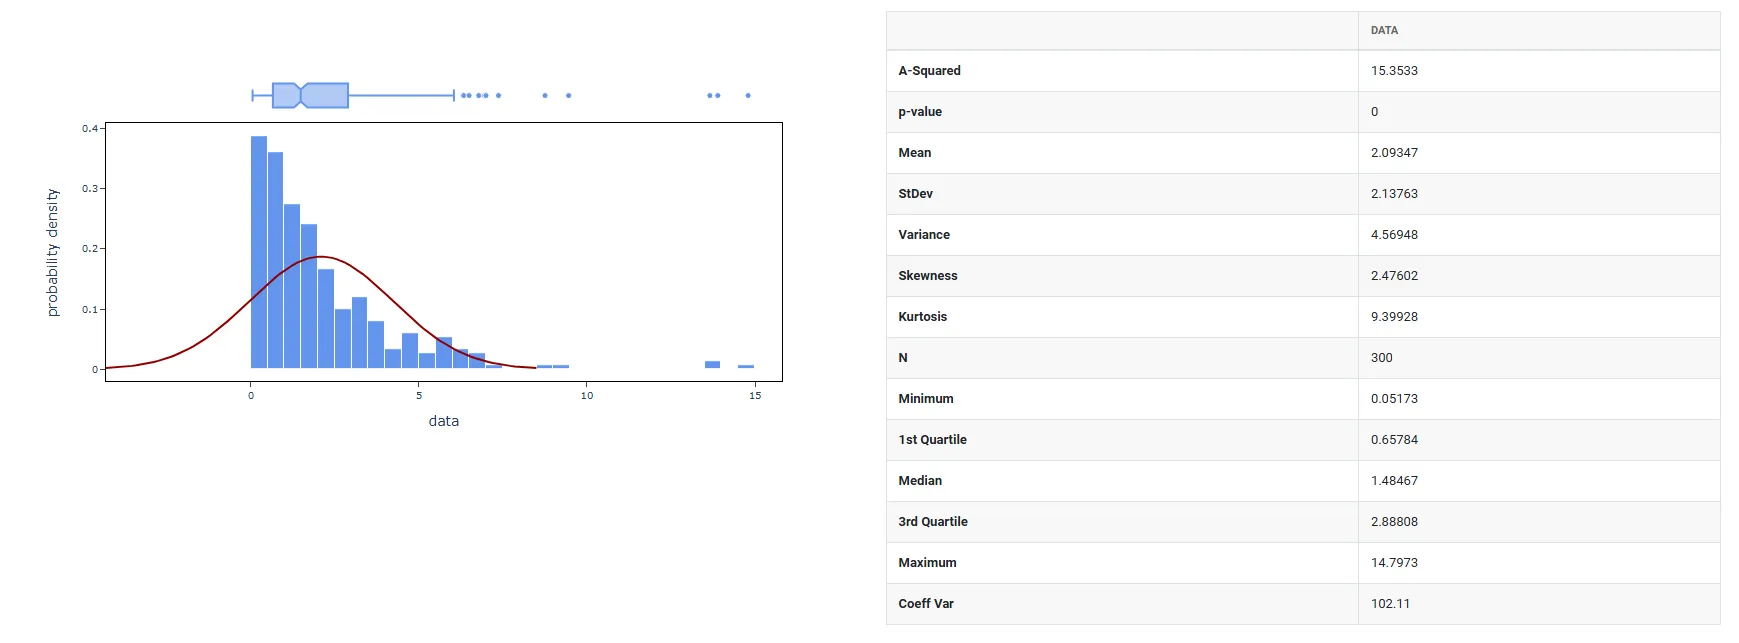
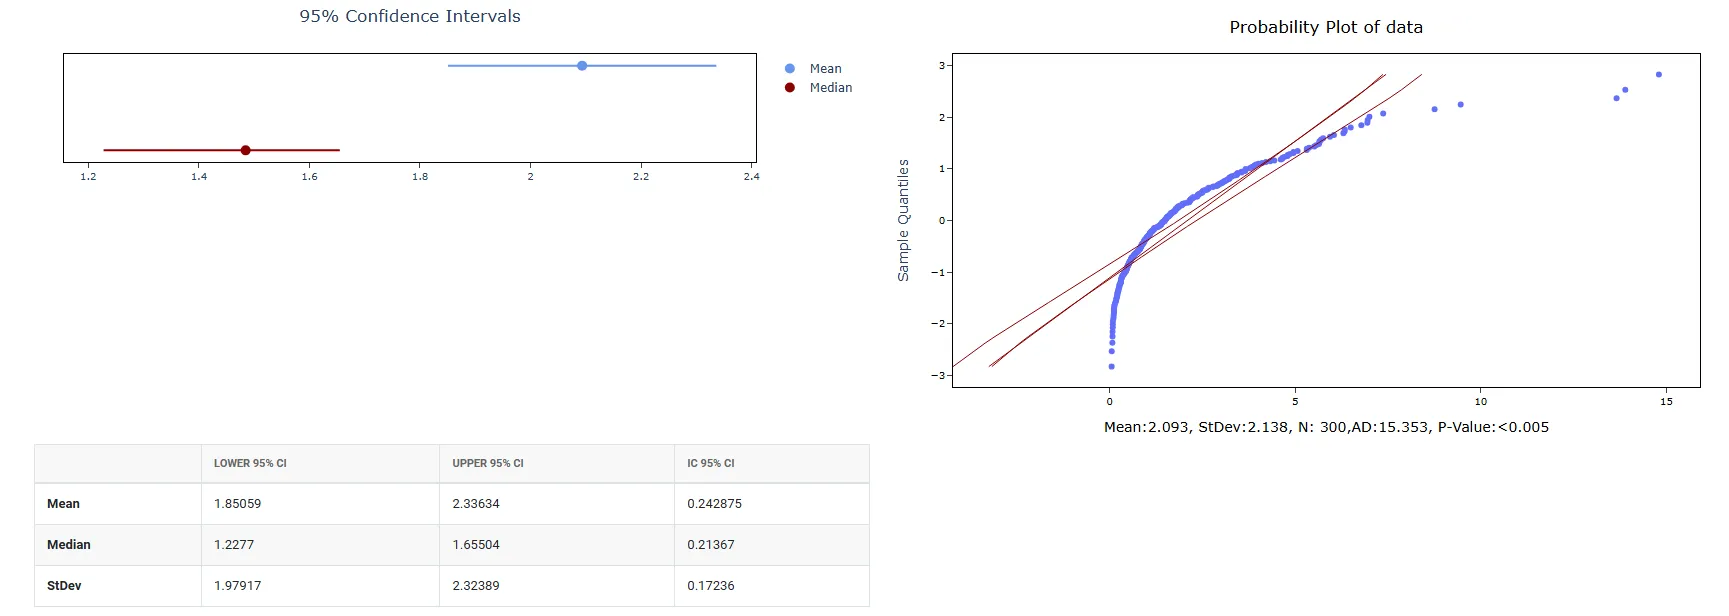
4. 使用上述工具後,得到的輸出如下:
如何產生隨機指數資料
操作步驟如下:
- 登入 Zometric Statistical Software,網址為 https://statsai.zometric.com/
- 在首頁選擇 Statistical Tool> Random Data>Random Exponential Data。
- 接下來,填寫所需選項。
- 最後,點選頁面底部的 calculate,即可得到所需結果。
在隨機指數資料的工具介面中,視窗分為兩個部分。
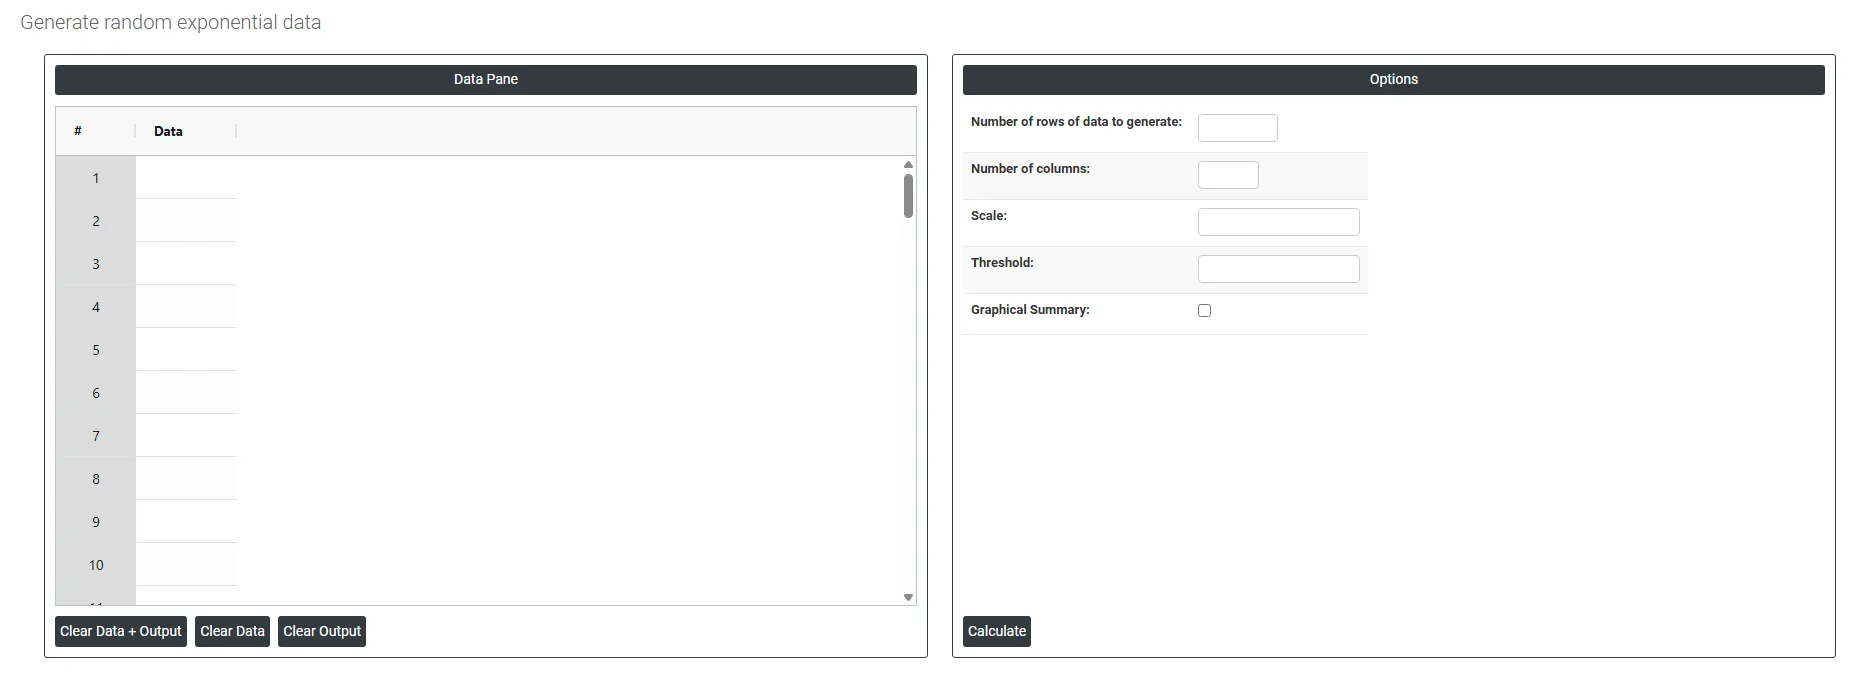
左側為資料窗格(Data Pane)。在 Data Pane 中,每一列即產生的一列隨機資料。填寫所需選項後將產生資料。
右側提供以下選項:
- Number of rows of data to generate: 指定產生多少個隨機資料點。例如,輸入 10 將產生恰好 10 列隨機值,全部顯示在資料窗格中。
- Number of columns: 指定每列有多少個變數(欄)。例如,輸入 3 將在資料窗格中並排產生 3 欄隨機資料。
- Scale: 指數分配的平均值,即事件之間的平均時間(等於 1/速率)。尺度值越大,產生的數字越大、越分散;尺度值越小,產生的值越集中在零附近。資料窗格中所有產生的資料點都會體現這種離散程度。
- Threshold: 為產生的資料設定最小起點。產生的數字不是從零開始,而是整體上移該數值。例如,將門檻值設為 10,意味著所有產生的值都從 10 開始向上,而不是從 0 開始。
- Graphical summary: 選中時,所有產生的值會被合併並彙總:帶配適常態曲線的直方圖和盒鬚圖、彙總統計量、Anderson-Darling 常態性檢定、機率圖,以及平均值、中位數和標準差的 95% 信賴區間。這是基於剛剛建立的資料的視覺化結果。
常見問題
隨機指數資料模擬什麼?
隨機指數資料模擬連續獨立事件之間的時間,例如機器故障間隔時間、顧客到達間隔時間或服務完成時間。它廣泛用於可靠度工程和排隊分析,用來模擬距離下一次故障或到達還有多久,並測試假定失效率恆定的可靠度分析。
什麼情況下應使用韋伯分配而不是指數分配?
指數分配假定失效率恆定,即無記憶性。如果失效率隨時間變化(上升或下降),請改用隨機韋伯資料。對於與時間無關的偏斜正量測值,隨機對數常態資料是更好的選擇。
尺度和門檻值設定對隨機指數資料有什麼作用?
尺度是指數分配的平均值,即事件之間的平均時間,等於 1/速率。尺度越大,數字越大、越分散;尺度越小,值越集中在零附近;請根據歷史資料中已知的事件間平均時間來設定。門檻值使所有值整體上移,因此門檻值為 10 意味著值從 10 而不是 0 開始。