
隨機對數常態資料
隨機對數常態資料模擬恆為正的右偏連續量測值。您設定列數和欄數、資料本身(而非其對數)的平均值和標準差,以及可選的、使數值向上平移的閾值。工具把平均值和標準差換算為對數尺度參數。不使用固定種子,因此如需重複使用,請複製資料。可選的圖形彙總顯示分配。
最後審閱
核心要點
隨機對數常態資料產生嚴格為正的右偏數值,其自然對數服從常態分配,用於模擬顆粒尺寸、反應時間或濃度等量測值。
什麼是隨機對數常態資料?
隨機對數常態資料從對數常態分配中產生數值,這是一種右偏分配,其資料的自然對數服從常態分配。結果是一組恆為正且向右偏斜的數值,常見於顆粒尺寸、收入分配和生物濃度等量測值。
簡要定義:產生具有右偏分配的隨機正值,適用於顆粒尺寸、反應時間和物料濃度等不能為零或負數的量測值。
何時使用隨機對數常態資料?
- 用於模擬 恆為正的右偏連續量測值。
- 當 對數轉換使資料近似常態,且您希望產生逼真的原始值用於模擬時使用。
- 用於 環境、製藥和金融模擬。
正確使用隨機對數常態資料的指南
- 參數按資料尺度輸入:平均值和標準差是 x 本身的,而不是 log(x) 的;工具會把它們換算為對數尺度參數。
- 所有產生的值都 嚴格為正。
- 不使用固定種子,因此每次 Calculate 都會給出新的值;如需重複使用同一資料集,請複製產生的資料。
替代方法:何時不宜使用隨機對數常態資料
- 如果資料 對稱且呈鐘形,請使用 隨機常態資料
- 對於 失效率變化的失效時間,請使用 隨機韋伯資料
隨機對數常態資料範例
產生隨機對數常態資料的步驟如下:
- 要產生隨機對數常態資料,需要填寫必需的選項。
- 現在,在 Zometric Statistical Software 中分析資料,網址為 https://statsai.zometric.com/。
- 要找到隨機對數常態資料,請選擇 Statistical module> Random Data > Random Lognormal Data
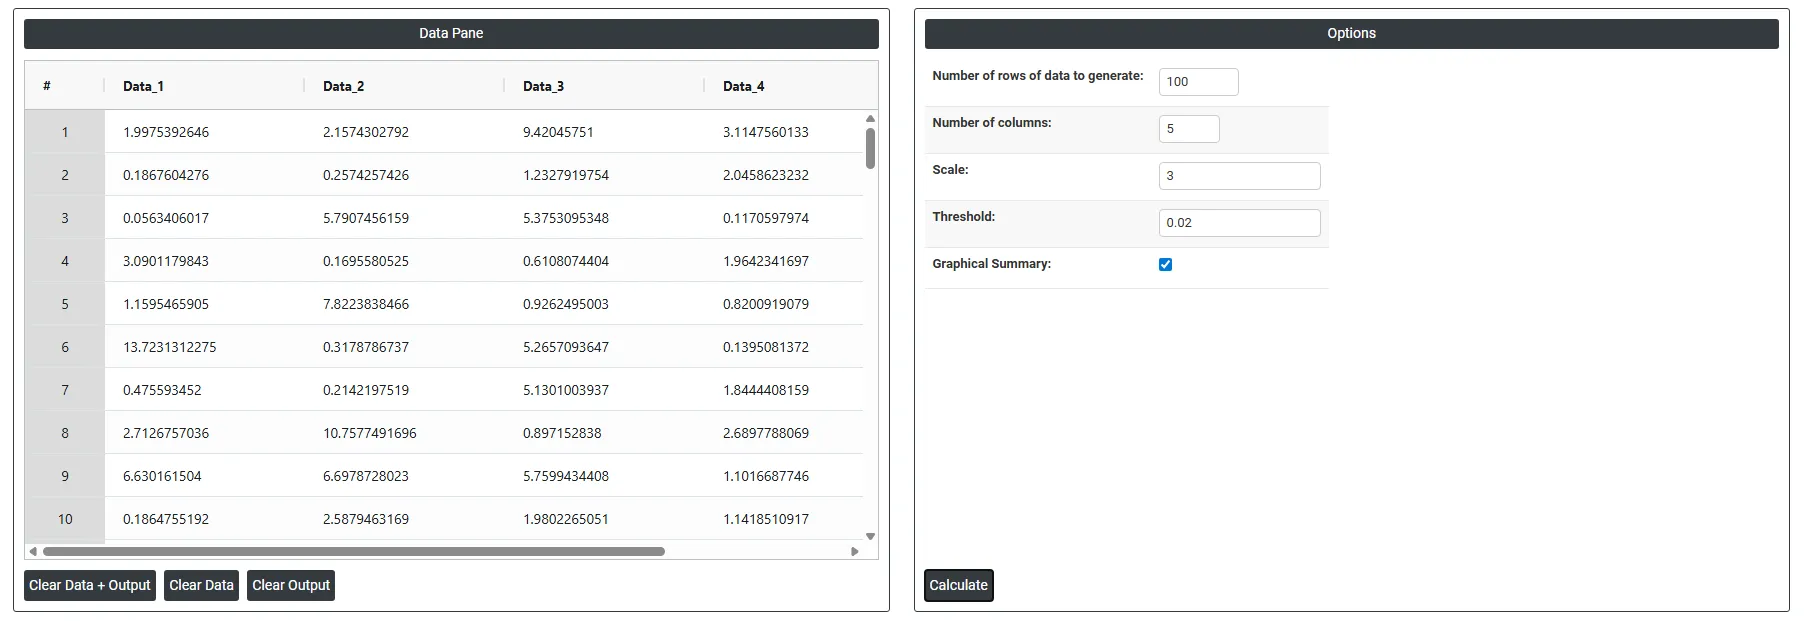
4. 使用上述工具後,得到的輸出如下:
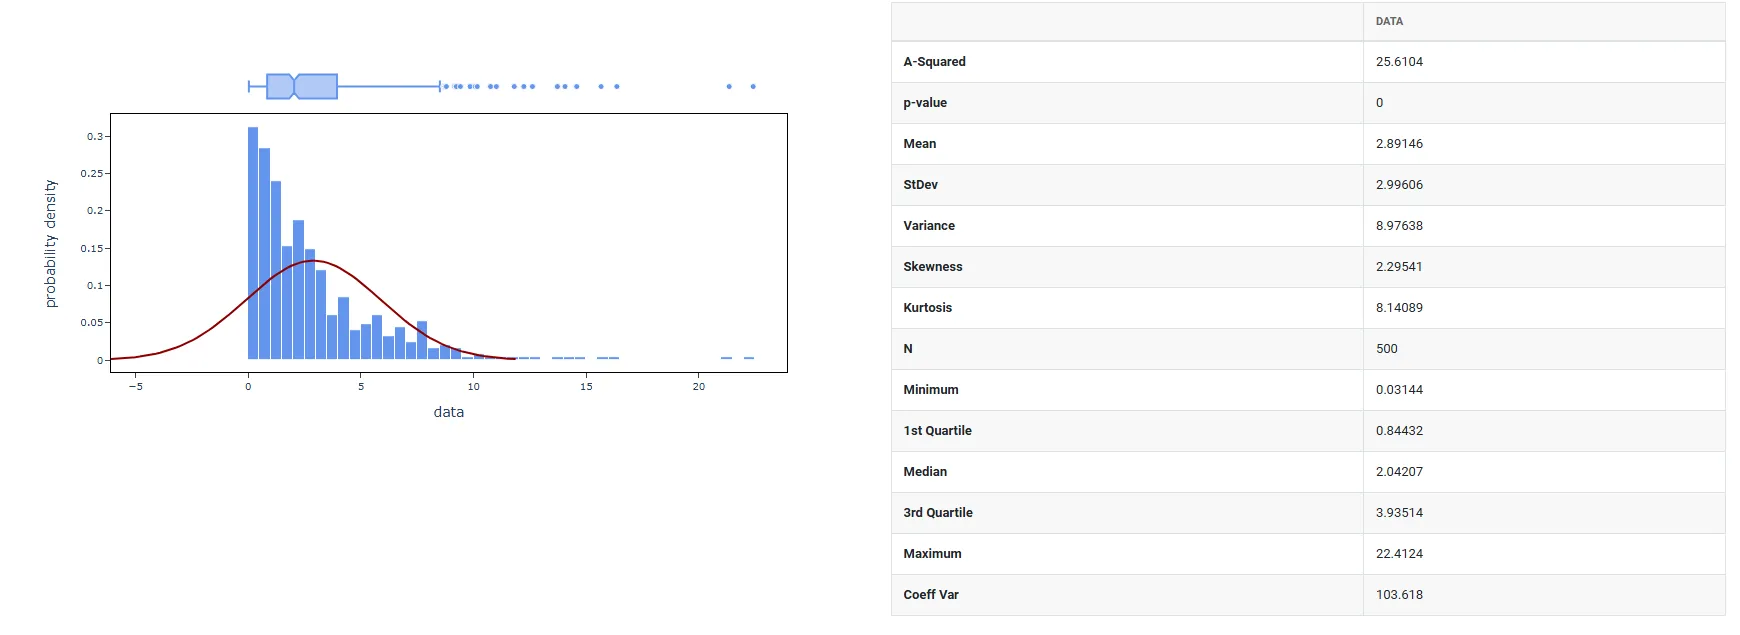
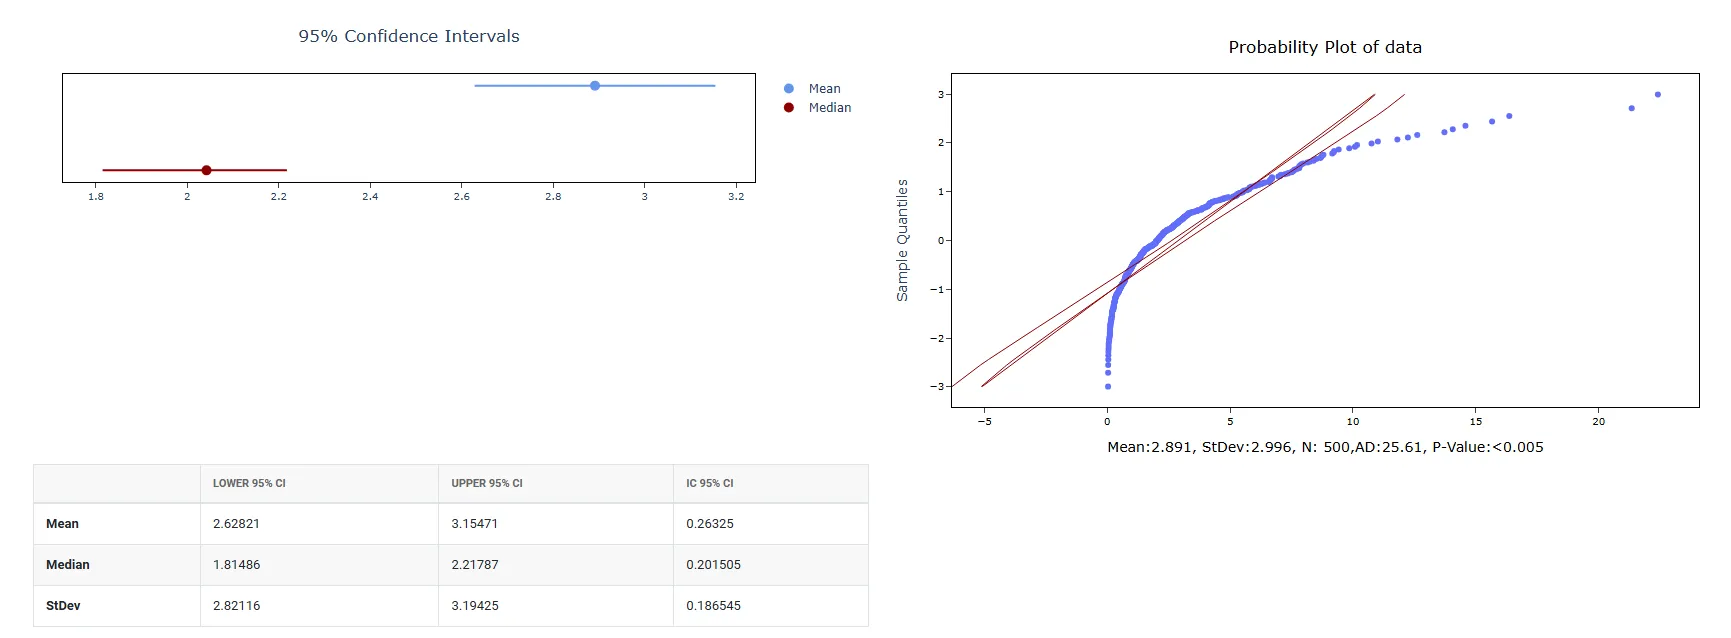
如何產生隨機對數常態資料
操作步驟如下:
- 登入 Zometric Statistical Software,網址為 https://statsai.zometric.com/
- 在首頁選擇 Statistical Tool> Random Data>Random Lognormal Data。
- 接下來,填寫必需的選項。
- 最後,點選頁面底部的 calculate,即可得到所需結果。
在隨機對數常態資料的工具介面中,視窗分為兩部分。
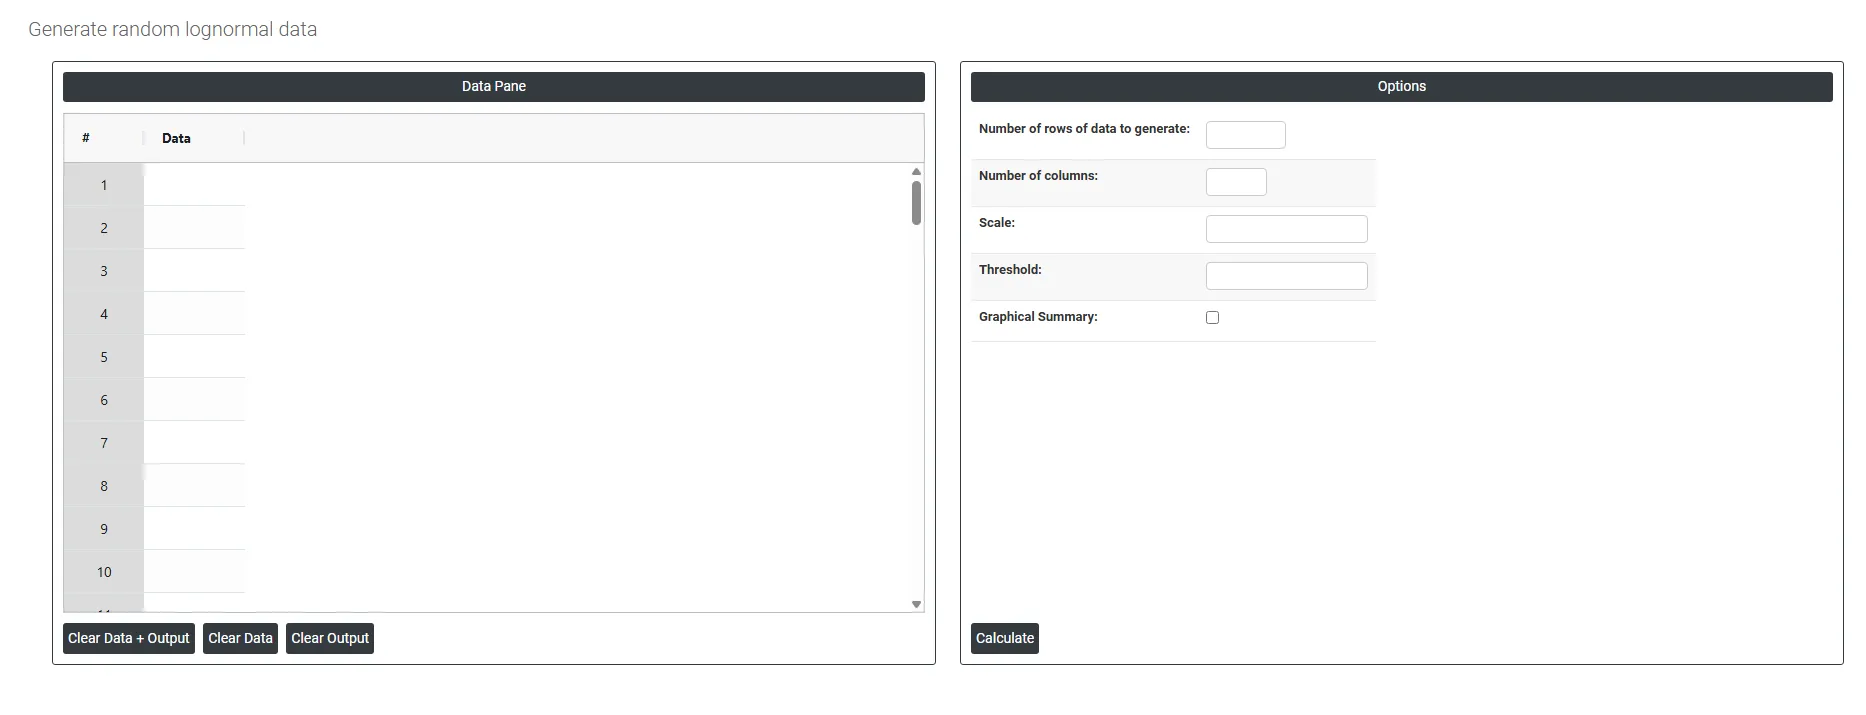
左側是資料窗格(Data Pane)。在 Data Pane 中,每一列是產生的隨機資料。填寫必需的選項後將產生資料。
右側提供以下選項:
- Number of rows of data to generate: 指定要產生多少個隨機資料點。例如,輸入 100 將產生恰好 100 列隨機值,全部顯示在資料窗格中。
- Number of columns: 指定每一列有多少個變數(欄)。例如,輸入 5 將在資料窗格中並排產生 5 欄隨機產生的資料。
- Mean and Standard Deviation: 所產生資料本身(而非其對數)的平均值和標準差。工具把它們換算為對數尺度參數 σ = √ln(1 + (s/m)²) 和 μ = ln(m) − σ²/2。標準差相對於平均值越大,產生的數值右偏越強。
- Threshold: 設定產生資料的最小起點。產生的數值不再從零開始,而是向上平移該數值。例如,將閾值設為 10,表示所有產生的值都從 10 開始向上,而不是從 0 開始。
- Graphical summary: 在使用您指定的平均值和標準差產生隨機資料之後,該選項會對這些資料產生圖形分析,例如顯示產生值如何分配的直方圖。這是基於剛剛建立的資料得到的視覺化結果。
常見問題
什麼是對數常態分配?
對數常態分配是一種右偏分配,其資料的自然對數服從常態分配。它的值恆為正,適用於顆粒尺寸、反應時間、收入以及不能為零或負數的生物或物料濃度等量測值。
什麼情況下應產生隨機對數常態資料?
用於模擬恆為正的右偏連續量測值,或當對數轉換使資料近似常態,且您希望得到逼真的原始值用於模擬時。它常見於環境、製藥和金融模擬。如果資料對稱且呈鐘形,請使用隨機常態資料;對於失效率變化的失效時間,請使用隨機韋伯資料。
對數常態的平均值和標準差是按對數尺度輸入的嗎?
不是。在該工具中,平均值和標準差是所產生資料本身的,而不是其對數的。工具把它們換算為對數尺度參數 σ = √ln(1 + (s/m)²) 和 μ = ln(m) − σ²/2。標準差相對於平均值越大,產生的數值右偏越強,而可選的閾值會使所有值向上平移。
能重新產生相同的隨機對數常態資料集嗎?
不使用固定種子,因此每次 Calculate 都會產生新的隨機值。如果需要重複使用同一資料集,例如重複分析或與同事共享,請在再次計算之前從資料窗格中複製所產生的資料。所有產生的值都嚴格為正。