
T² – 廣義變異數管制圖
T² - 廣義變異數管制圖監控每個零件上一起量測的兩個或更多相關特性,子群組大小相等且大於變數個數。T² 管制圖示示在考慮相關性的前提下偏離製程中心較遠的子群組平均值;|S| 管制圖示示聯合離散程度的增大。它假定資料服從多元常態分配且各子群組相互獨立,支援 Phase 1 或 Phase 2 管制界限,並給出彙總表和特殊原因表。
最後審閱
核心要點
T² - 廣義變異數管制圖以子群組方式監控兩個或更多相關特性:T² 管制圖檢測平均值向量的偏移,廣義變異數管制圖檢測聯合離散程度的增大。
用途
T² – 廣義變異數管制圖在一頁上以子群組方式監控每個零件上一起量測的兩個或更多相關特性。Hotelling T² 管制圖考察在考慮變數間相關性的情況下,子群組的平均值向量是否已偏離製程中心。廣義變異數管制圖考察這些變數的聯合離散程度是否增大。當各特性相互關聯地變化時(例如車削零件的直徑和長度),請使用它,而不是為每個特性分別繪製 Xbar 和 R 管制圖。
主要功能
- 針對同一份子群組資料,上下排列 T² 管制圖和廣義變異數 (|S|) 管制圖。
- 變數數不限(兩個或更多),子群組大小相等,且大於變數個數。
- 按所選誤報率設定 T² 管制界限(預設 0.0027,相當於 3σ)。
- Phase 1(管制界限取自資料)或 Phase 2(管制界限取自歷史平均值向量和協變異數矩陣)。
- 僅根據所選子群組估計參數,並支援列子集和 x 軸標籤欄。
- 每張管制圖均有彙總表和特殊原因表。
統計方法
資料包含 p 個變數,在 m 個子群組中各量測 n 個零件。對每個子群組,工具計算平均值向量 x̄ⱼ 和樣本協變異數矩陣 Sⱼ。在 Phase 1 中,製程協變異數為合併矩陣 S̄(即各 Sⱼ 的平均值),製程中心為各子群組平均值的總平均值 x̿。每個子群組的統計量為 T²ⱼ = n·(x̄ⱼ − x̿)′ S̄⁻¹ (x̄ⱼ − x̿),即其平均值到中心的馬氏距離的平方,再乘以 n。管制上限為 UCL = p(m − 1)(n − 1) / (mn − m − p + 1) × F(1 − α; p, mn − m − p + 1),下限為 0,中心線為同一分配的中位數 p(m − 1)(n − 1) / (mn − m − p + 1) × F(0.5; p, mn − m − p + 1),與 Minitab 相同。使用歷史平均值向量和協變異數矩陣(Phase 2)時,它們取代 x̿ 和 S̄,UCL 和中心線則為 χ² 分位數 χ²(1 − α; p) 和 χ²(0.5; p)。
廣義變異數管制圖繪製每個子群組協變異數矩陣的行列式 |Sⱼ|,它是所有變數聯合離散程度的單一數值。取 Σ̂ = |S̄|(或歷史協變異數矩陣的行列式),以及常數 b₁ = Π(n − i) / (n − 1)ᵖ 和 b₂ = Π(n − i) × [Π(n − i + 2) − Π(n − i)] / (n − 1)²ᵖ(i 取 1 到 p),則管制界限為 CL = b₁Σ̂,UCL = Σ̂(b₁ + K√b₂),LCL = max(0, Σ̂(b₁ − K√b₂)),K 預設為 3(Montgomery 的 3σ 管制界限)。
在兩張管制圖上,只有超出管制界限的點才是訊號;判異規則不適用於這些偏態統計量。T² 訊號表明子群組平均值已偏離,但不會指出是哪個變數發生了變動:請將該子群組的各平均值與其他子群組比較。該方法假定各變數服從多元常態分配,且各子群組相互獨立。Phase 1 管制界限包含任何失控的子群組,因此在消除可查明原因之後,應剔除這些子群組重新計算。
輸入欄位和選項
欄位 | 說明 |
Variables | 必填。兩個或更多數值型欄,即每個零件上量測的相關特性。 |
Subgroup indicator | 必填。給出每一列所屬子群組的欄。所有子群組的大小必須相同,均為 n,且 n 必須大於變數個數。 |
Alpha (T² false alarm rate) | 預設為 0.0027;範圍 0.0001 至 0.5。僅設定 T² 的 UCL。 |
Check Rule 1 (Generalized Variance) / K for Rule 1 (Generalized Variance) | 預設勾選,K = 3。取消勾選後,超出廣義變異數管制界限的點不會被標記。K 設定廣義變異數管制界限的寬度,以 |S| 的標準差個數計。T² 管制界限由 Alpha 設定。 |
X scale | 可選欄,用於標註橫軸。 |
Historical mean vector (T²) | 可選,每個變數一個值。僅用於 T² 管制圖,且只能與歷史協變異數矩陣一起使用(Phase 2)。 |
Historical covariance matrix | 可選的 p × p 矩陣,列之間以「;」分隔,值之間以「,」或空格分隔,例如 4.0,1.2;1.2,3.0。廣義變異數管制圖單獨使用它,T² 管制圖則將其與平均值向量一起使用。 |
Include or Exclude / Specify which rows | 預設為所有列,也可包含或排除給定的列號(例如 4 7 11:14)。 |
Specify subgroups to estimate parameters (mean vector & covariance matrix) / Subgroups | 估計中心和合併協變異數時,選擇 Omit(預設)或 Use 所列子群組(例如 14:15);所有子群組仍會繪製在圖上。 |
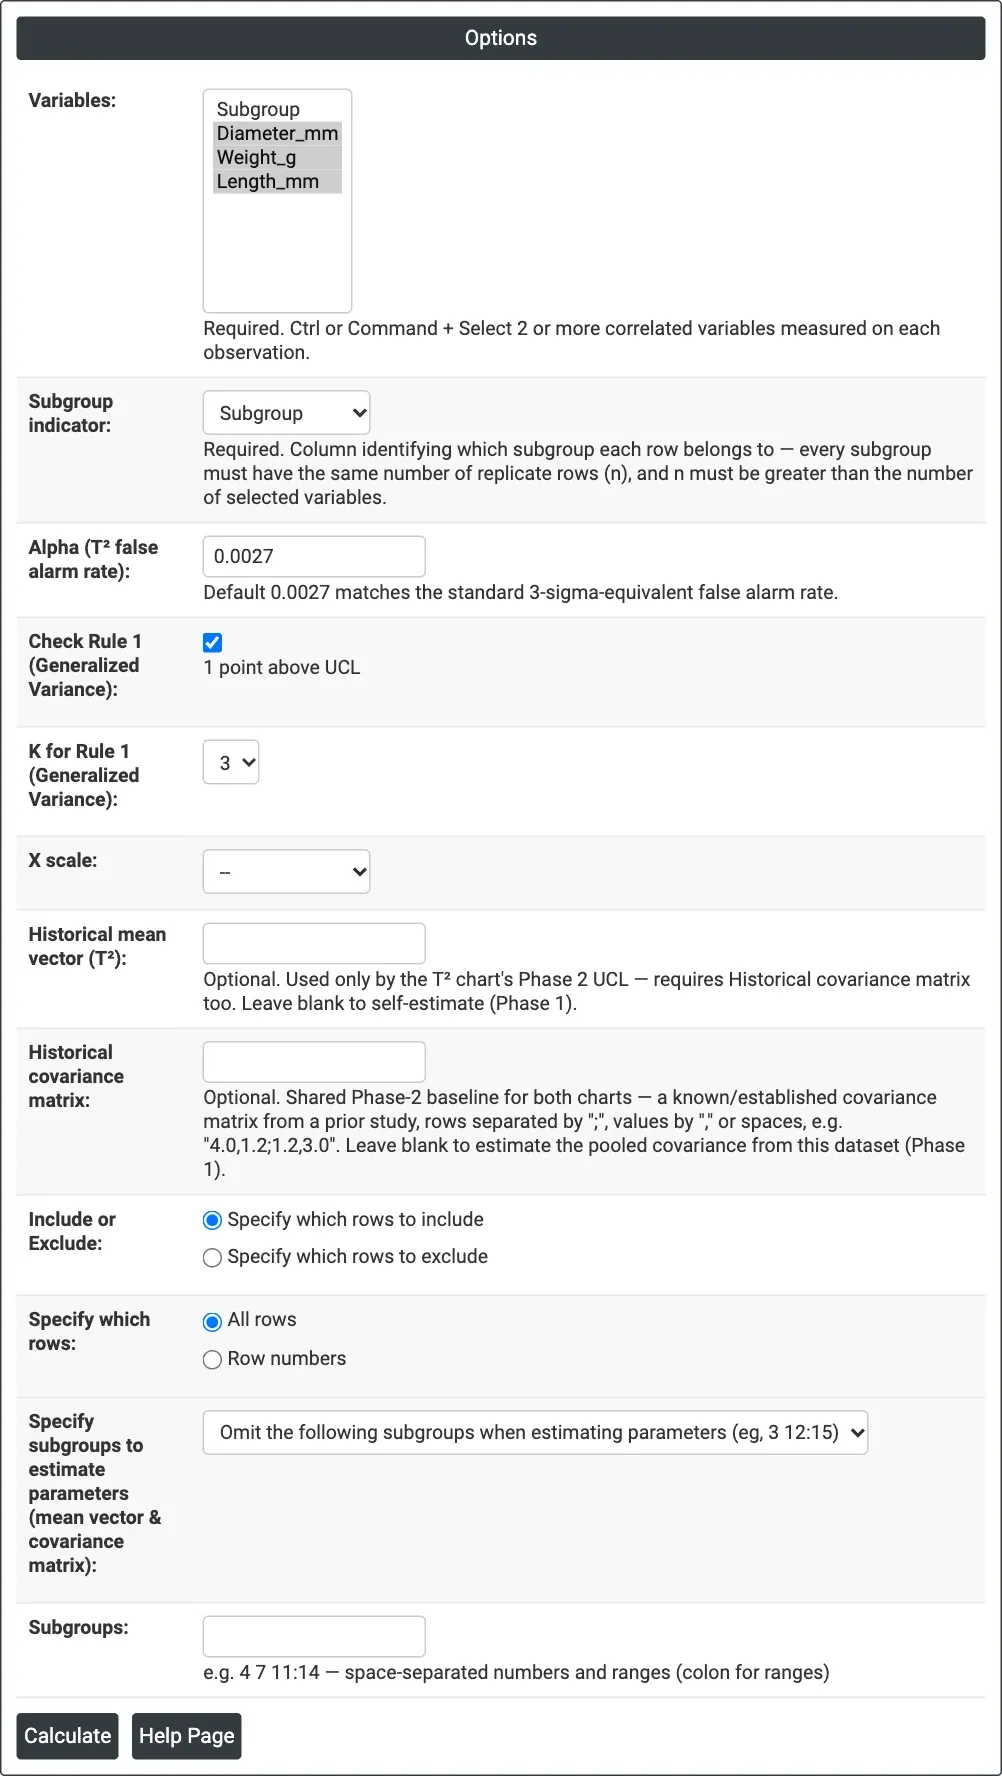
圖 1 — 範例的選項:Diameter_mm、Weight_g 和 Length_mm,每個子群組四個零件,alpha 0.0027,Phase 1。
輸出說明
- T² Chart — 每個子群組的 T² 及中心線(T² 的中位數)、UCL 和 LCL = 0;高於 UCL 的點為紅色。
- T² summary table — Variables、p(變數數)、m(所用子群組數)、n(子群組大小)、Alpha、Center Line(T² 的中位數)、UCL 和 Phase(1 為自行估計,2 為已知基線)。
- Generalized Variance Chart — 每個子群組的 |S| 及 CL、UCL 和 LCL。
- Generalized variance summary table — Variables、p、m、n、常數 b1 和 b2、CL、LCL、UCL 和 Phase。
- 每張管制圖的 Nelson's Rules 表 — 高於 UCL 的子群組,或 No special causes found。
- 透過 Download 匯出 PDF。
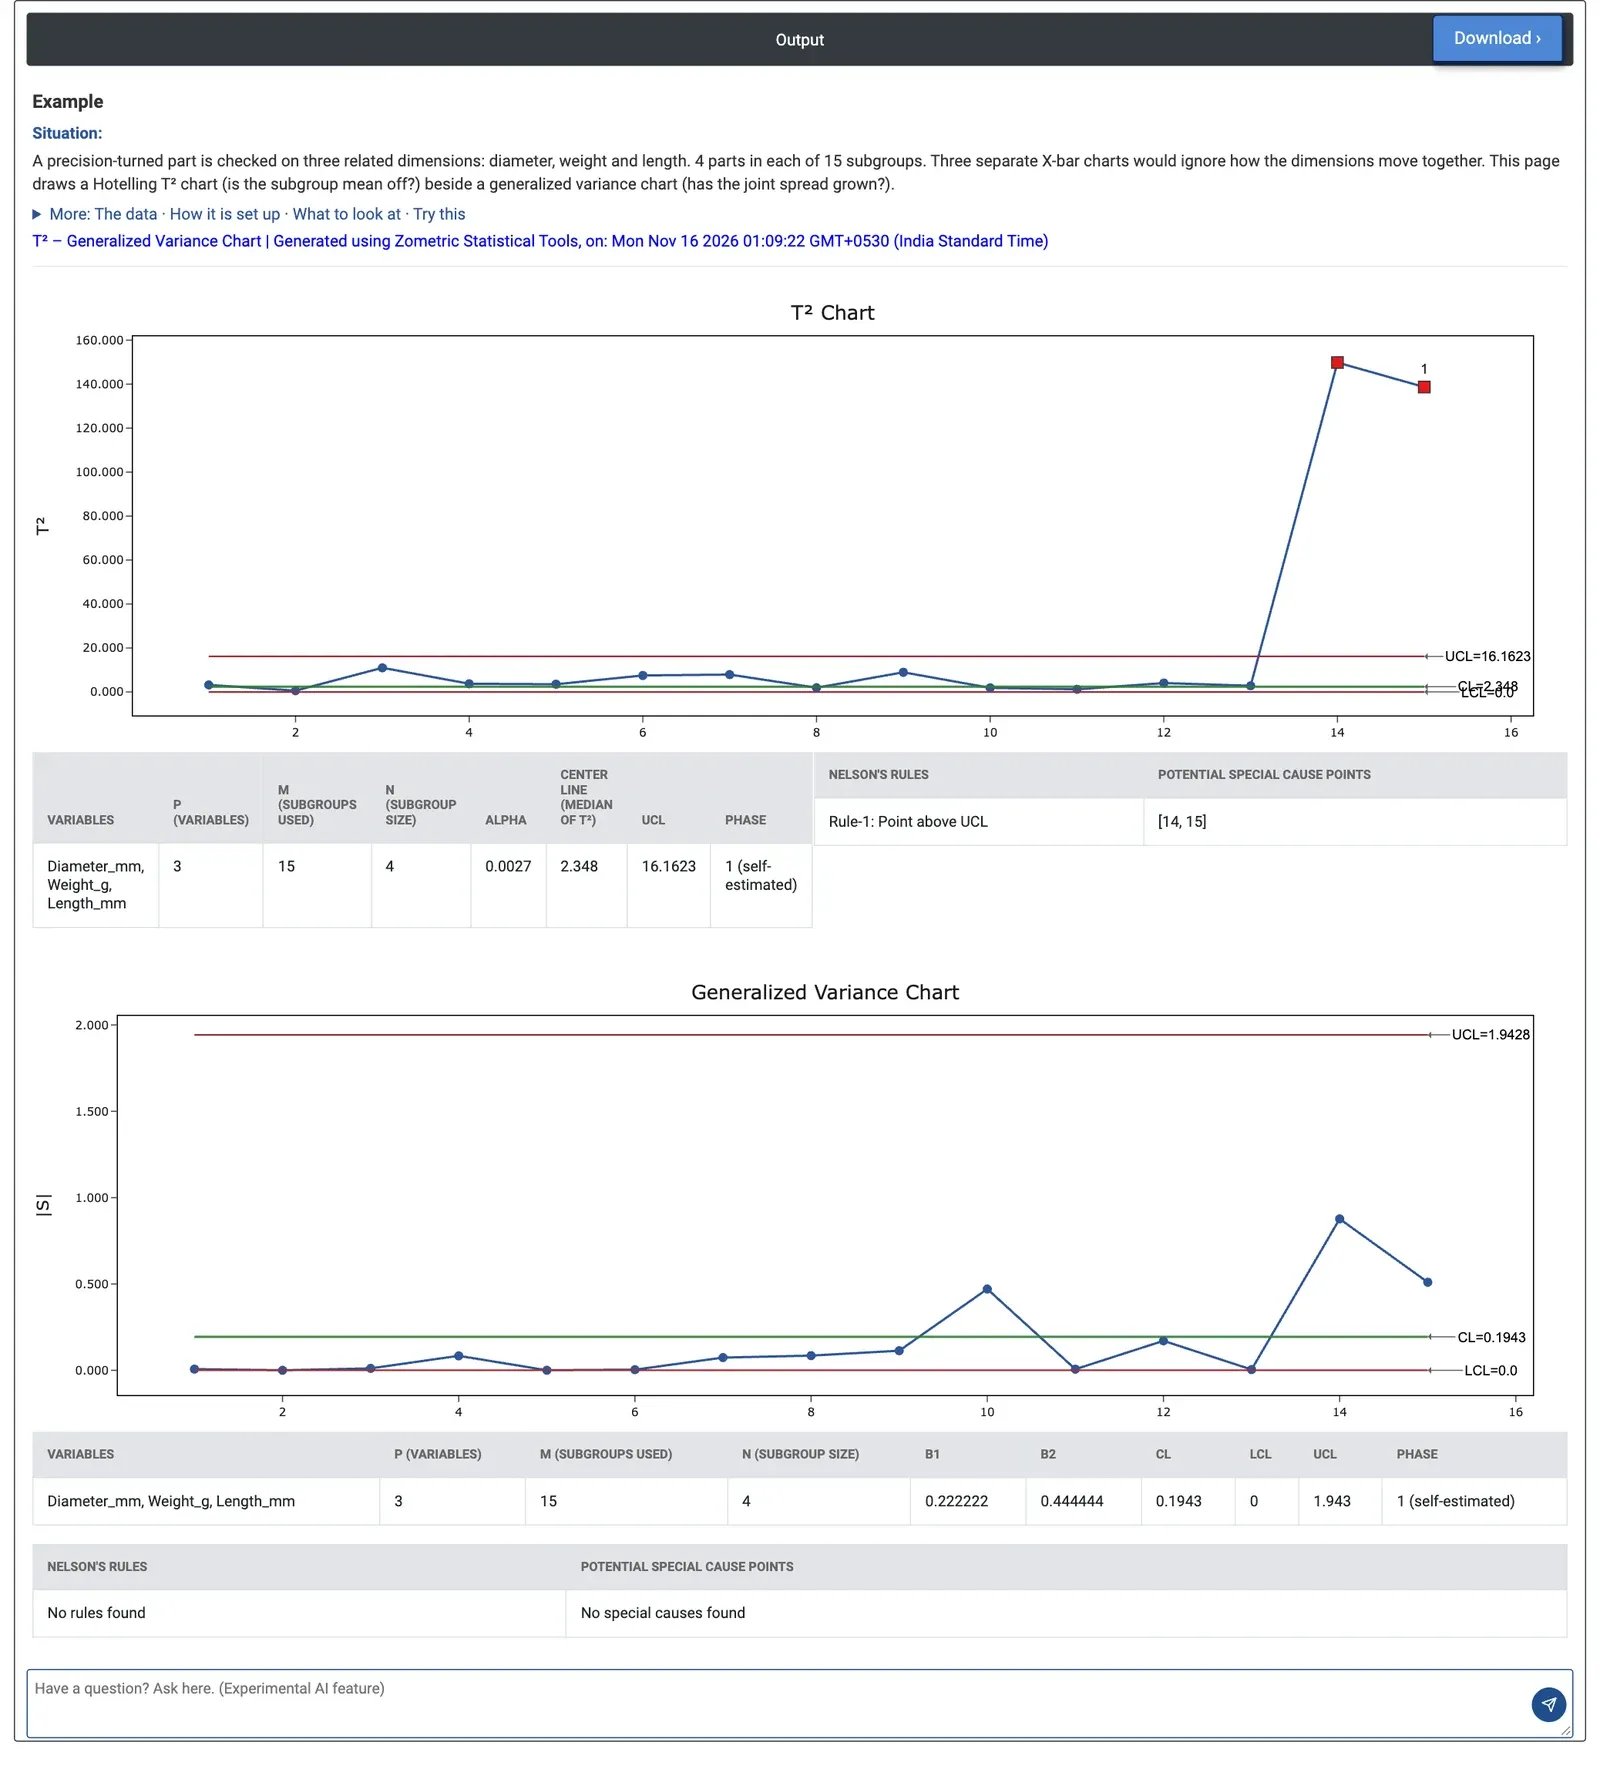
圖 2 — 子群組 14 和 15 遠高於 T² 的 UCL 16.1623,而所有 |S| 均低於廣義變異數的 UCL 1.943。
計算範例
對一個精密車削零件檢查三個相關尺寸:直徑、重量和長度。15 個子群組中每組取四個零件。直徑與長度強相關(r = 0.83),因此三張單獨的 Xbar 管制圖無法公平地評判各子群組。Variables = Diameter_mm、Weight_g 和 Length_mm,Subgroup indicator = Subgroup,Alpha = 0.0027,不使用歷史值。
T² 管制圖的 UCL 為 16.1623,中心線為 2.348。子群組 1 至 13 的 T² 在 0.58 至 10.99 之間,但子群組 14 和 15 分別達到 149.8 和 138.7,被標記。其平均值說明了原因:直徑為 29.07 和 29.89 mm,而此前約為 24.4 至 25.3 mm;長度為 13.73 和 14.35 mm,而此前約為 11.3 至 12.2 mm;子群組 14 的重量也偏輕,為 55.9 g。廣義變異數管制圖的 CL 為 0.1943,UCL 為 1.943;最大的 |S| 為子群組 14 的 0.877,因此聯合離散程度的增大尚不足以發出訊號。
這是製程中心的偏移,而不是製程變得更不穩定:團隊應查詢子群組 14 之前的設定或刀具變更,而不是查詢額外變異的來源。為了從穩定期獲得管制界限,分析人員在 Subgroups 中輸入 14:15 並選擇 Omit。T² 的 UCL 變為 16.5221(m = 13),子群組 14 和 15 仍發出訊號。廣義變異數管制界限收緊為 CL 0.09013 和 UCL 0.9013,子群組 14 的 0.877 現在剛好低於 UCL:值得關注,但仍不是訊號。
常見問題
何時應使用 T² 管制圖而不是單獨的 Xbar 管制圖?
當同一零件上量測的兩個或更多特性一起變化時(例如車削零件的直徑和長度),使用 T² 管制圖。單獨的 Xbar 和 R 管制圖忽略了相關性,無法公平地評判各子群組;T² 管制圖在考慮相關性的前提下,度量每個子群組平均值到製程中心的距離。
廣義變異數管制圖顯示什麼?
廣義變異數管制圖繪製每個子群組協變異數矩陣的行列式 |S|,它是所有變數聯合離散程度的單一數值。高於其管制上限的點表明聯合離散程度已增大。相比之下,T² 訊號表明子群組的平均值向量已偏離製程中心。
T² 廣義變異數管制圖有哪些要求?
需要兩個或更多數值型變數和一個子群組指示欄。所有子群組的大小必須相同,且該大小必須大於變數個數。該方法假定各變數服從多元常態分配,且各子群組相互獨立。只有超出管制界限的點才是訊號;判異規則不適用。
出現 T² 訊號後應怎麼做?
T² 訊號表明子群組平均值已偏離,但不會指出是哪個變數發生了變動,因此應將該子群組的各平均值與其他子群組比較。Phase 1 管制界限包含任何失控的子群組,因此在消除可查明原因之後,應在參數估計中剔除這些子群組重新計算。