
容忍區間(常態分配,彙總資料)
容忍區間(常態分配,彙總資料)執行與標準常態分配容忍區間相同的計算——得出在給定信賴水準下覆蓋總體指定比例的範圍——但接受手動輸入的彙總統計量(平均值、標準差和樣本數),而不是原始資料。
最後審閱
核心要點
容忍區間(常態分配,彙總資料)利用輸入的彙總統計量而非原始資料,計算在給定信賴度下覆蓋總體指定比例的範圍。
本頁內容
什麼是容忍區間(常態分配,彙總資料)?
容忍區間(常態分配,彙總資料)執行與標準常態分配容忍區間相同的計算——得出在給定信賴水準下覆蓋總體指定比例的範圍——但接受手動輸入的彙總統計量(平均值、標準差和樣本數),而不是原始資料。
當沒有原始觀測值,但您擁有來自某項研究、稽核報告、經驗證的資料集或已發表參考文獻的可靠彙總統計量時,這很有用——使您無需重構或重新收集原始資料,就能計算容忍區間。
簡單定義:與常態分配容忍區間相同,但專為只有彙總統計量(平均值、標準差、n)而沒有完整原始資料集的情形而設計。
何時使用容忍區間(常態分配,彙總資料)?
- 當 沒有原始資料,但擁有來自經驗證的研究或歷史記錄的準確彙總統計量時使用。
- 當依據 供應商資質報告、已發表的研究或稽核摘要 工作,而其中未保留單一量測值時使用。
- 當希望根據現有彙總資料 快速評估容差界限,而無需重新進行完整的資料收集時使用。
- 僅當基礎資料 已確認或強烈預期服從常態分配 時使用——該方法對非常態總體無效。
正確使用容忍區間(常態分配,彙總資料)的指南
- 核實彙總統計量 準確、完整且來源可靠 ——輸入有誤會直接導致容忍區間輸出不正確。
- 確保產生彙總統計量的原始資料 服從常態分配 ——僅憑彙總統計量無法驗證這一點,因此應依賴先前的知識或檢測文件。
- 在執行分析之前,先指定 信賴水準和覆蓋比例 ——它們必須反映實際要求,而不是事後選擇。
- 請注意,基於彙總資料的區間 無法檢測離群值或分配不規則性,而這些在原始資料中是可見的——使用時應適當謹慎。
替代方法:何時不宜使用容忍區間(常態分配,彙總資料)
- 如果 有原始資料,請始終改用 容忍區間(常態分配)——它提供更好的診斷和假設驗證。
- 如果目標是估計 總體平均值 而不是涵蓋單一值,請使用 基於彙總資料的信賴區間。
容忍區間(常態分配,彙總資料)範例
檢定步驟如下:
- 填寫必要的輸入項。
- 現在,在 Zometric Statistical Software 中分析資料,網址為 https://statsai.zometric.com/。
- 要找到容忍區間(常態分配,彙總資料),請選擇 Statistical module> Hypothesis Test> Tolerance(Normal Distribution Summarized).
- 在工具中,輸入資料如下:
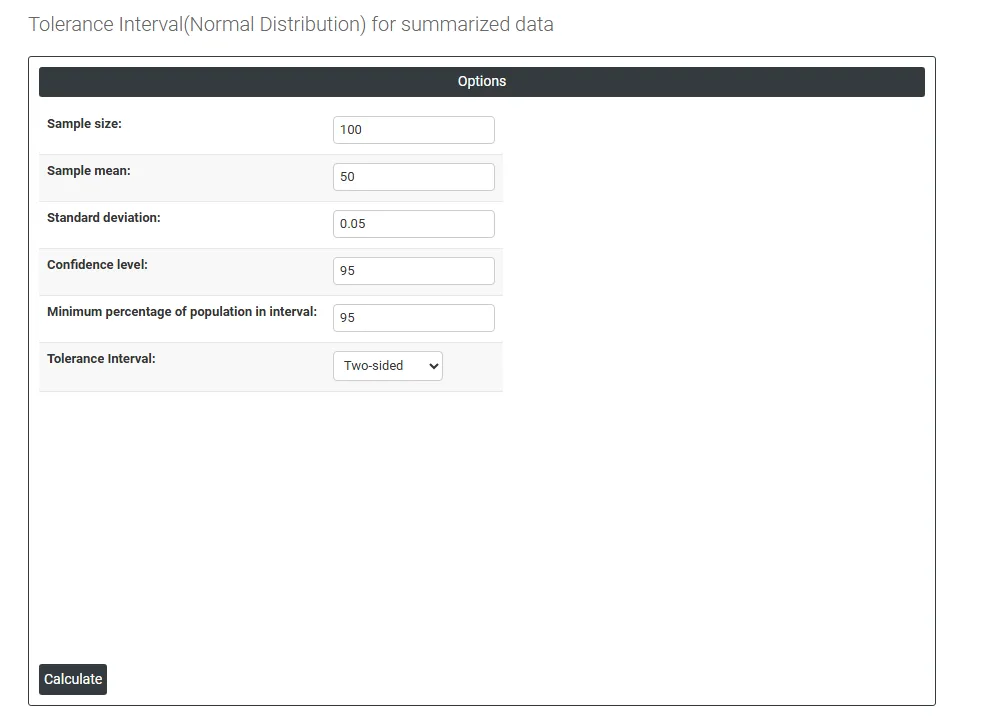
5. 使用上述工具後,得到的輸出如下:
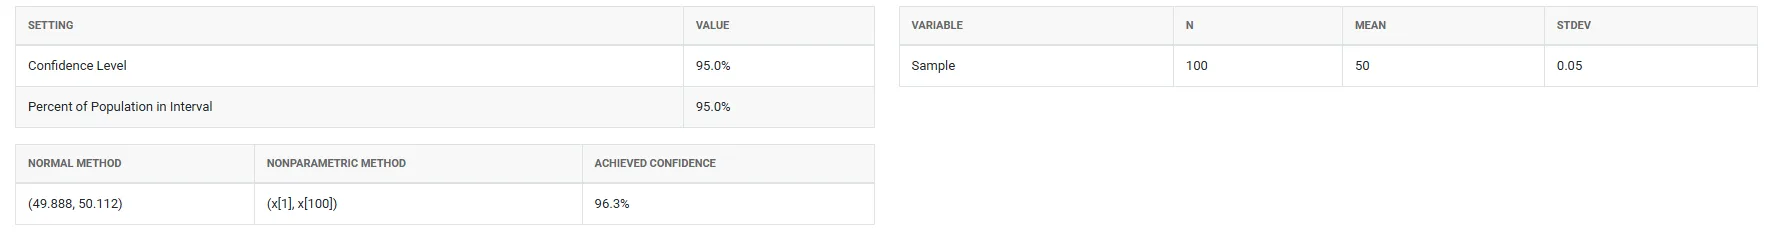
如何使用容忍區間(常態分配,彙總資料)
操作步驟如下:
- 登入 Zometric Statistical Software,網址為 https://statsai.zometric.com/
- 在首頁選擇 Statistical Tool> Hypothesis Test >Tolerance(Normal Distribution Summarized)。
- 接下來,手動更新資料,或從 Excel 表格中完整複製(Ctrl+C)資料並貼上(Ctrl+V)到此處。
- 填寫所需選項。
- 最後,點選頁面底部的 calculate,即可得到所需結果。
在容忍區間(常態分配,彙總資料)的工具介面中,視窗分為兩個部分。
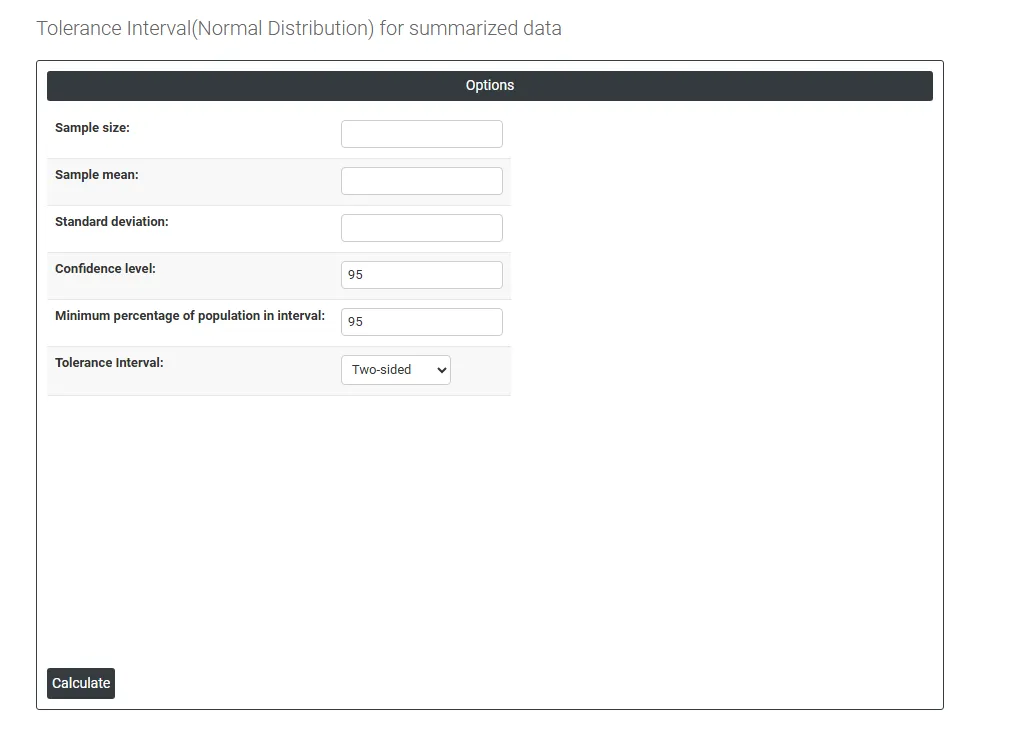
左側為資料窗格(Data Pane)。在 Data Pane 中,每一列構成一個子群組。資料可以手動輸入,也可以從 Excel 表格中完整複製(Ctrl+C)資料並貼上(Ctrl+V)到此處。
Load example: 將載入範例資料。
Load File: 用於直接載入 Excel 資料。
右側提供以下選項:
- Sample Size: 輸入原始資料集中收集的 觀測總數 ——例如,如果量測了 50 個能源成本資料,則輸入 50。該值至關重要,因為容忍區間的寬度直接受所用觀測數量的影響——樣本數越大,區間越窄、越精確;樣本數越小,區間越寬,反映出對總體真實界限的不確定性越大。
- Sample Mean: 輸入原始資料集的 平均值。這是構建容忍區間所圍繞的中心估計值。平均值決定區間在量測尺度上的位置——平均值越高,區間上移;平均值越低,區間下移。請確保該值來自可靠且經驗證的來源,因為不準確的平均值會使整個區間直接偏移到錯誤的位置。
- Standard Deviation: 輸入原始資料集的 標準差 ——表示單一量測值圍繞平均值的離散程度。這是決定容忍區間寬度的最具影響力的輸入。標準差越大,區間越寬,反映製程變異越大;標準差越小,區間越窄,反映製程更緊湊、更一致。請確保該值準確反映原始研究中製程的真實離散程度。
- Confidence Level: 設定所計算的區間確實包含總體至少指定比例的確定程度。標準預設值為 95%,意味著您有 95% 的把握認為該容忍區間至少覆蓋您所指定的總體最低百分比。較高的信賴水準(如 99%)產生更寬的界限和更高的確定性;較低的水準(如 90%)產生更窄的界限,但對覆蓋要求確實得到滿足的保證程度較低。
- Minimum Percentage of Population in Interval: 輸入容忍區間必須包含的 總體最小比例。例如,輸入 99 表示該區間旨在捕捉製程總體中至少 99% 的單一值。該值必須根據品質要求、產品規格或法規標準選擇——常見選擇為 90%、95%、99% 或 99.9%,取決於應用的關鍵程度。
- 與信賴水準一起,這構成完整的容差表述——例如,有 95% 的把握認為總體至少 99% 落在該區間內,是製程驗證和產品放行文件中被廣泛接受的標準。
- Tolerance Interval: 定義容忍區間的形狀和方向。有三個選項:
- Two-Sided ——同時產生下界和上界,構成從兩端捕捉總體指定比例的完整範圍。當最小和最大單一值都很重要時使用——例如,產品必須同時保持在規格下限和上限之內。
- Lower Bound ——僅產生下邊界,表示總體中只有一小部分預期低於的最小值。當只有最小可接受值重要時使用——例如,確認至少 99% 的產品滿足最低強度或純度要求。
- Upper Bound ——僅產生上邊界,表示總體中只有一小部分預期高於的最大值。當只有最大可接受值重要時使用——例如,確認至少 99% 的產品保持在最大汙染、重量或溫度限值之下。
常見問題
什麼是基於彙總資料的容忍區間?
它執行與常態分配容忍區間相同的計算,即在給定信賴度下覆蓋總體指定比例的範圍,但使用手動輸入的彙總統計量(平均值、標準差和樣本數),而不是原始資料。
什麼情況下應使用匯總資料的容忍區間?
當沒有原始資料,但擁有可靠的彙總統計量時使用,例如來自供應商資質報告、已發表的研究、稽核摘要或歷史記錄。如果有原始資料,請改用標準的常態容忍區間,因為它提供更好的診斷和假設檢查。
基於彙總統計量的容忍區間有哪些侷限?
僅憑彙總統計量無法驗證常態性,因此必須依賴先前的知識或檢測文件。基於彙總資料的區間也無法檢測原始資料中可見的離群值或分配不規則性,且所輸入的平均值、標準差或樣本數中的任何錯誤都會直接導致不正確的區間。
樣本數和標準差如何影響區間?
樣本數越大,區間越窄、越精確;樣本數越小,區間越寬,反映出更大的不確定性。標準差是對寬度影響最大的輸入:值越大,區間越寬。平均值決定區間在量測尺度上的位置。