
雙樣本卜瓦松率檢定
雙樣本卜瓦松率檢定利用已知暴露量下獨立事件的計數,比較兩組之間的事件率。它用信賴區間估計比率差,用常態近似進行檢定;當假設差值為 0 時,還可進行精確二項檢定。它假定事件以恆定速率獨立發生。資料可以是彙總資料、兩欄或堆疊在一欄。
最後審閱
核心要點
雙樣本卜瓦松率檢定比較兩個組中事件發生的頻率,如每單元的缺陷數或每班次的停機次數,用信賴區間估計比率差,並進行精確檢定或常態檢定。
用途
雙樣本卜瓦松率檢定比較兩個組中事件發生的比率,例如白班和夜班每班次的停機次數、兩條生產線每單元的缺陷數,或變更前後每月的投訴數。它用信賴區間估計兩個比率之間的差,並檢定該差是否不同於零或另一個假設差值。適用於已知暴露量下獨立事件的計數;對於合格/不合格結果,請使用 2 Proportions 檢定。
主要功能
- 資料可以是彙總計數、兩欄計數,或一欄計數加一欄樣本標示。
- 當假設差值為 0 時,並列給出精確檢定(條件二項)和常態近似。
- 差值的變異數可基於各自的比率或合併比率。
- 雙側或單側對立假設,並給出差值的信賴區間或單側界限。
- 兩個樣本可設定不同的觀測長度,例如 8 小時和 12 小時的班次。
統計方法
對於有 Nᵢ 個單元的樣本 i,每個單元的觀測長度為 tᵢ(Observation length),暴露量為 Tᵢ = Nᵢ·tᵢ,共有 Xᵢ 個事件,則比率為 λ̂ᵢ = Xᵢ / Tᵢ。估計的差值為 D = λ̂₁ − λ̂₂,即樣本 1 減樣本 2。對於兩欄或堆疊資料,Nᵢ 為樣本中非空白計數的個數,Xᵢ 為其總和。
常態近似:z = (D − D₀) / SE,其中 D₀ 為假設差值。選擇 Estimate the rates separately 時,SE = √(λ̂₁ / T₁ + λ̂₂ / T₂);選擇 Use the pooled estimate of the rates 時,SE = √[λ̂ₚ(1 / T₁ + 1 / T₂)],其中 λ̂ₚ = (X₁ + X₂) / (T₁ + T₂)。當兩個暴露量相等時,兩種方法得到的 SE 相同。p 值取自標準常態分配,差值的信賴區間為 D ± z·SE(或單側界限)。
精確檢定,僅在 D₀ = 0 時給出:如果兩個比率相等,則總數 X₁ + X₂ 中的計數 X₁ 服從機率為 T₁ / (T₁ + T₂) 的二項分配。單側 p 值為二項分配的尾部機率,雙側 p 值為較小尾部機率的兩倍。當計數較小時,優先使用精確檢定。兩種方法都假定每組內事件以恆定速率獨立發生。
輸入欄位和選項
欄位 | 說明 |
Data | Summarized data(預設)、Each sample is in its own column 或 Both samples are in one column。 |
Sample 1 / Sample 2 | 選擇 Each sample is in its own column 時:兩欄計數。 |
Samples / Sample IDs | 選擇 Both samples are in one column 時:計數所在的欄,以及標明每列所屬樣本的欄(恰好有兩個不同的值;先出現的為樣本 1)。 |
Sample 1 sample size / Sample 1 total occurrences / Sample 2 sample size / Sample 2 total occurrences | 選擇 Summarized data 時:每個樣本的單元數和事件總數。 |
Hypothesized difference | 預設 0。虛無假設下 λ₁ − λ₂ 的值;精確檢定僅在值為 0 時給出。 |
Confidence level | 預設 95;範圍 75 至 100。 |
Alternative hypothesis | Difference ≠ hypothesized difference(預設)、Difference < hypothesized difference 或 Difference > hypothesized difference。 |
Test method | Estimate the rates separately(預設)或 Use the pooled estimate of the rates,用於常態近似。 |
Observation length (Sample 1) / Observation length (Sample 2) | 預設 1。每個單元的暴露量;留空時樣本 2 使用樣本 1 的長度。 |
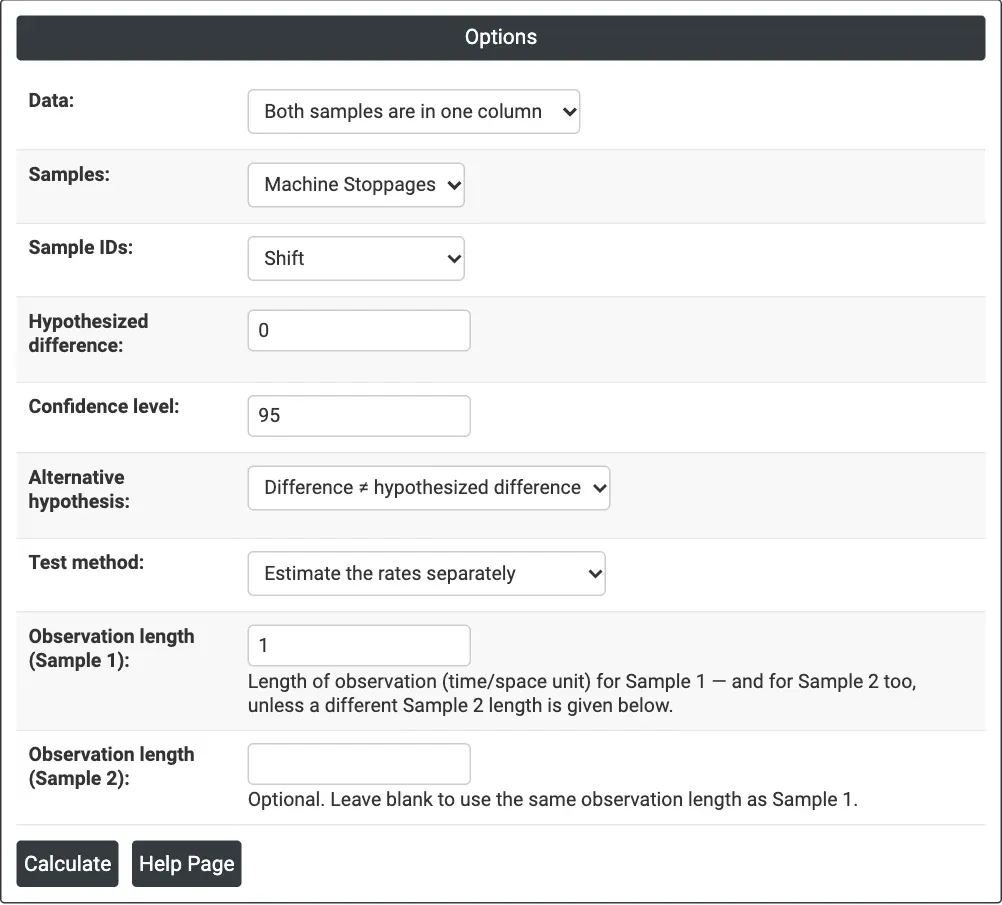
圖 1 — 範例所用選項:Machine Stoppages 堆疊在一欄,以 Shift 作為樣本標示,雙側,分別估計比率。
輸出說明
- Method — 哪個樣本為 λ₁、哪個為 λ₂,以及差值 λ₁ − λ₂。
- Descriptive Statistics — 每個樣本的 Sample、N、Total Occurrences 和 Sample Rate。
- Estimation for Difference — Estimated Difference 及其信賴區間(或上界、下界)。
- Test — 虛無假設和對立假設,以及一張表,給出 Exact 和 Normal approximation 方法的 Z-Value 和 P-Value;使用合併估計時附有註釋。
- 透過 Download 匯出 PDF。
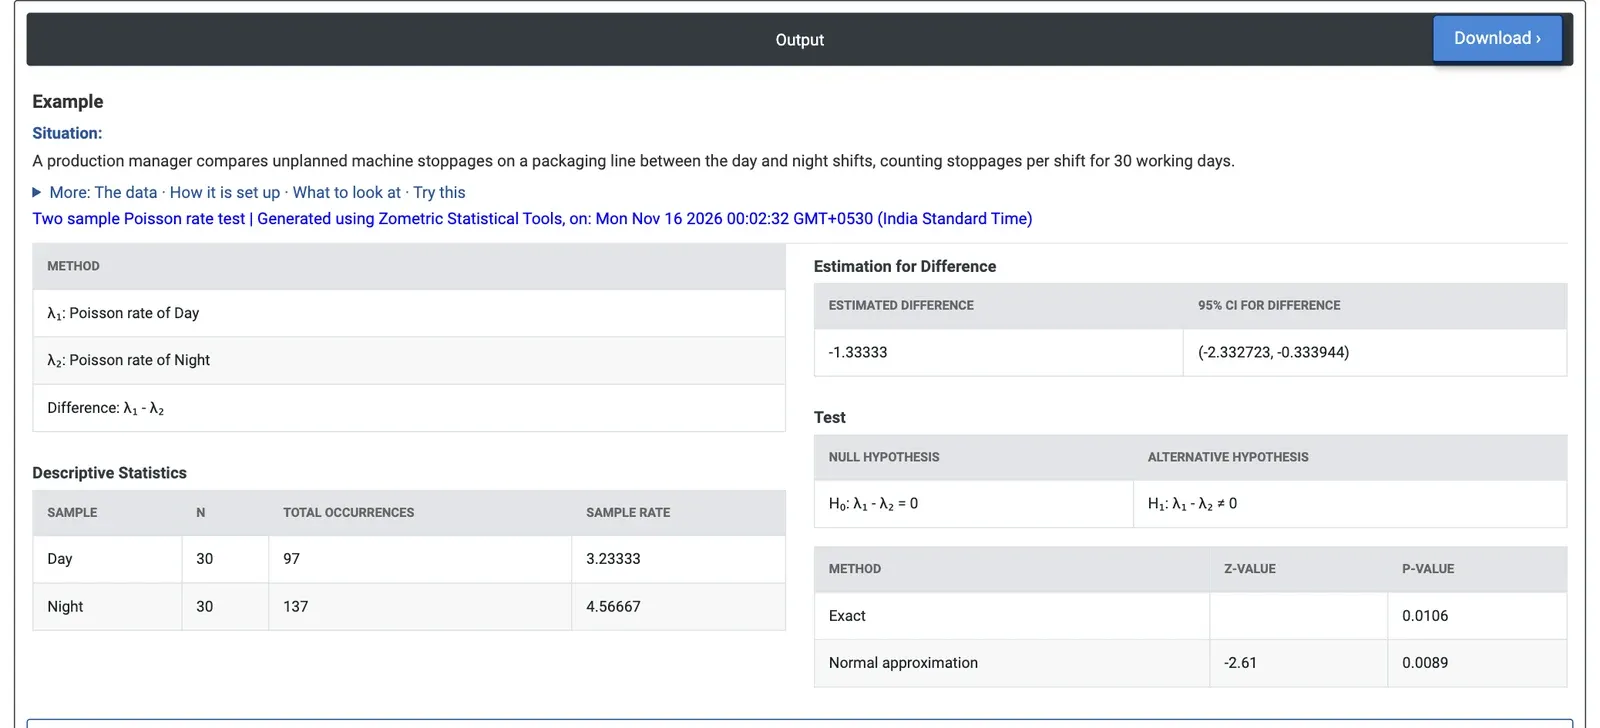
圖 2 — 白班平均 3.233 次停機,夜班平均 4.567 次;差值的 95% 信賴區間 −2.333 至 −0.334,不包含 0(精確 p = 0.0106)。
計算範例
一名生產經理比較包裝線白班和夜班的計畫外設備停機次數,統計了 30 個工作日內每個班次的停機次數。Data = Both samples are in one column,Samples = Machine Stoppages,Sample IDs = Shift,Hypothesized difference = 0,Confidence level = 95,雙側,Test method = Estimate the rates separately,Observation length = 1(一個班次)。
白班在 30 個班次中有 97 次停機,比率為每班次 3.233 次;夜班在 30 個班次中有 137 次,為每班次 4.567 次。估計的差值(白班減夜班)為每班次 −1.333 次停機,95% 信賴區間為 −2.333 至 −0.334:該區間不包含 0。精確檢定得到 p = 0.0106,常態近似得到 z = −2.61,p = 0.0089。夜班的停機次數更多,約比白班多 40%。
由於兩個樣本都涵蓋 30 個班次,Use the pooled estimate of the rates 在此得到相同的 z 和 p 值。如果經理在收集資料之前就預期夜班更差,則 Difference < hypothesized difference 得到 p = 0.0053(精確),差值的 95% 上界為 −0.495。下一步是找出夜班有何不同,例如人員配置、換型或物料,以免額外的停機造成更多的產出損失。
常見問題
何時應使用雙樣本卜瓦松率檢定?
用於比較兩個組中事件發生的比率,適用於已知暴露量下獨立事件的計數,例如白班和夜班每班次的停機次數、兩條生產線每單元的缺陷數,或變更前後每月的投訴數。對於合格/不合格結果,請改用 2 Proportions 檢定。
精確檢定與常態近似有什麼區別?
精確檢定以總計數為條件:如果兩個比率相等,則樣本 1 中的計數服從二項分配,其機率等於其佔總暴露量的份額。它僅在假設差值為 0 時給出,並在計數較小時優先使用。常態近似使用 z 統計量,標準誤可為各自的或合併的。
雙樣本卜瓦松率檢定有哪些假設?
精確法和常態法都假定每組內事件以恆定速率獨立發生。每個樣本的比率為其事件總數除以其暴露量(單元數乘以觀測長度),因此兩個樣本可以有不同的觀測長度,例如 8 小時和 12 小時的班次。
如何解讀雙樣本卜瓦松率檢定的結果?
輸出給出每個樣本的比率、估計的差值(樣本 1 減樣本 2)及其信賴區間,以及精確法和常態法的 p 值。如果差值的信賴區間不包含 0 且 p 值較小,則兩個事件率存在差異。