
雙樣本 t 檢定(彙總資料)
這一版本的雙樣本 t 檢定基於彙總統計量:輸入兩個獨立組各自的樣本數、平均值和標準差。當沒有原始資料時使用,例如來自已發表的報告或供應商提供的彙總資料。沒有原始資料就無法檢查常態性。選項包括信賴水準、假設差值、對立假設和等變異數;輸出包括 p 值和信賴區間。
最後審閱
核心要點
雙樣本 t 檢定(彙總資料)僅使用每組的樣本數、平均值和標準差而非原始資料,檢定兩個獨立組的平均值是否存在顯著差異。
什麼是雙樣本 t 檢定(彙總資料)?
雙樣本 t 檢定(彙總資料)執行與標準雙樣本 t 檢定相同的比較——判斷兩個獨立組的平均值是否存在顯著差異——但不需要原始資料,而是直接根據您手動輸入的彙總統計量進行計算:每組的樣本數(n)、平均值和標準差。
當沒有原始資料時,這一方法尤其有價值——例如依據已發表的研究、稽核報告、供應商提供的彙總資料,或只保留了彙總統計量的歷史記錄開展工作時。
簡單定義:與雙樣本 t 檢定相同,但適用於只有彙總數字(平均值、標準差、樣本數)而沒有完整原始資料集的情形。
何時使用雙樣本 t 檢定(彙總資料)?
- 當 沒有原始資料 但有每組的平均值、標準差和樣本數時使用。
- 當依據 已發表的報告、外部供應商資料或歷史彙總資料 開展工作且未記錄單一觀測值時使用。
- 當基於所報告的統計量而非收集到的量測值,比較 兩個獨立組 時使用。
- 當希望對彙總資料 快速驗證或交叉核對結論 而無需重建完整資料集時使用。
正確使用雙樣本 t 檢定(彙總資料)的指南
- 核實所輸入的彙總統計量 準確且來源可靠 ——輸入有誤會直接導致錯誤的檢定結論。
- 確保彙總統計量代表 獨立、不相關的組 ——該檢定假定兩個樣本之間沒有關係。
- 確認 樣本數足夠 ——即使彙總輸入正確,非常態分配的小樣本也可能產生不可靠的結果。
- 在執行檢定之前設定 alpha ——標準預設值為 0.05。
- 當彙總統計量來自 嚴重偏態或非常態的總體 時要謹慎——t 檢定假定常態性,而沒有原始資料就無法驗證這一點。
替代方法:何時不宜使用雙樣本 t 檢定(彙總資料)
- 如果有 原始資料,請始終改用標準的 雙樣本 t 檢定 ——它提供更多診斷和假設檢查。
- 如果兩個樣本是 配對或匹配的,請使用 配對 t 檢定
- 如果比較 兩個以上的組,請使用 單因素變異數分析
- 如果目標是確認 等價而非差異,請使用 雙樣本等價檢定
如何進行雙樣本 t 檢定
操作步驟如下:
- 登入 Zometric Statistical Software,網址為 https://statsai.zometric.com/
- 在首頁選擇 Statistical Tool> Hypothesis Test >Two sample t test(Summarized)。
- 接下來,手動更新資料,或從 Excel 表格中完整複製(Ctrl+C)資料並貼上(Ctrl+V)到此處。
- 填寫必填選項。
- 最後,點選頁面底部的 calculate,即可得到所需結果。
雙樣本 t 檢定的工具介面分為兩部分。
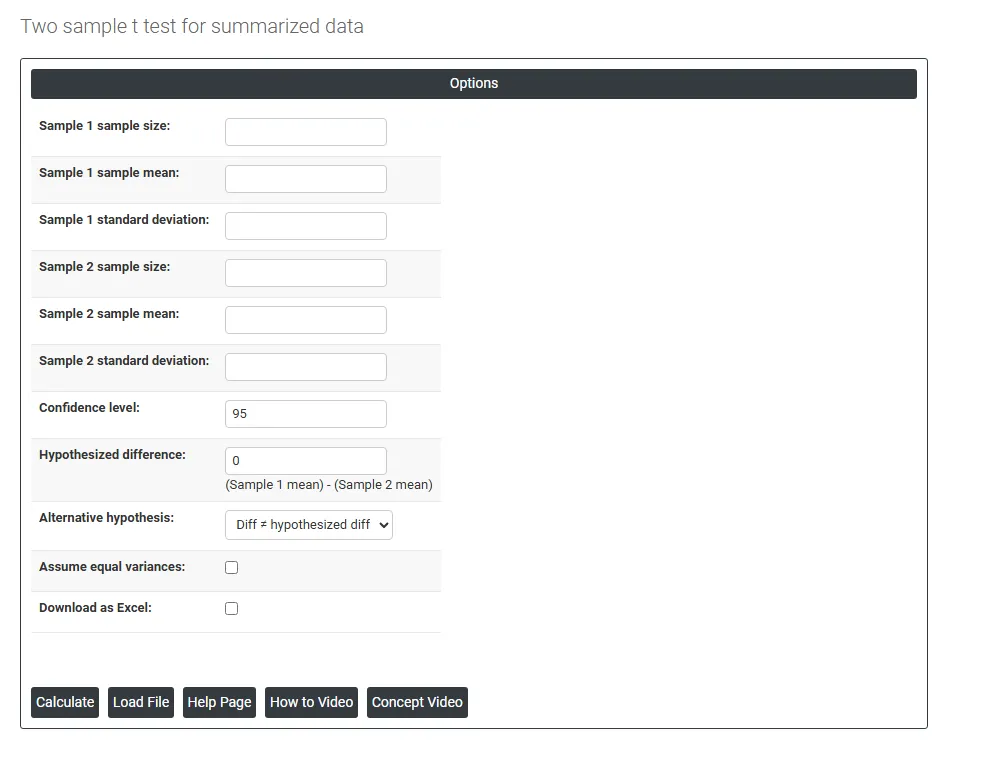
左側為資料窗格(Data Pane)。在 Data Pane 中,每一列構成一個子群組。可以手動輸入資料,也可以從 Excel 表格中完整複製(Ctrl+C)資料並貼上(Ctrl+V)到此處。
Load example: 將載入範例資料。
Load File: 用於直接載入 Excel 資料。
右側提供以下選項:
- Sample 1 Sample Size: 輸入第一組中的 觀測總數 ——例如,如果從配方 A 中測得 40 個量測值,則輸入 40。該值用於計算檢定的標準誤和自由度。樣本數越大,結果越可靠、越精確。
- Sample 1 Sample Mean: 輸入第一組量測值的 平均值。這是第一組資料分配的中心值,直接用於計算兩組之間的差值。
- Sample 1 Standard Deviation: 輸入第一組的 標準差 ——表示單一量測值圍繞平均值的離散程度。標準差越大,組內變異越大,會使信賴區間變寬,並降低檢定檢出差異的靈敏度。
- Sample 2 Sample Size: 輸入第二組中的 觀測總數。與 Sample 1 一樣,該值參與標準誤的計算,並影響檢定檢出兩組之間真實差異的精確程度。
- Sample 2 Sample Mean: 輸入第二組量測值的 平均值。檢定將其與 Sample 1 的平均值直接比較,以計算觀測到的差值並判斷其在統計上是否顯著。
- Sample 2 Standard Deviation: 輸入第二組的 標準差。該值反映第二組資料的離散程度,並與 Sample 1 的標準差一起用於估計比較的合併變異。
- Confidence Level: 設定兩個平均值之差的信賴區間的信賴水準。標準預設值為 95%,表示您有 95% 的把握認為兩個總體平均值之間的真實差值落在所顯示的範圍內。將其提高到 99% 會使區間變寬;降低到 90% 則使區間變窄。
- Hypothesized Difference: 您所檢定的兩個組平均值之間的假定或預期差值(Sample 1 平均值減去 Sample 2 平均值)。將其設為 0 即檢定兩個平均值是否相等。設為任何其他值,則檢定實際差值是否等於該特定數值——例如,輸入 10 即檢定第 1 組的平均值是否恰好比第 2 組多 10 個單位。
- Alternative Hypothesis: 定義檢定的方向,以及您想對差值證明什麼。有三個選項:
- Diff ≠ Hypothesized Diff —— 雙尾檢定,檢查差值是否在任一方向上不等於假設值。當您事先不預期哪一組更大時使用。
- Diff < Hypothesized Diff —— 單尾檢定,檢查實際差值是否小於假設值。當您明確預期 Sample 1 低於 Sample 2 時使用。
- Diff > Hypothesized Diff —— 單尾檢定,檢查實際差值是否大於假設值。當您明確預期 Sample 1 高於 Sample 2 時使用。
- Assume Equal Variances: 勾選時,檢定假定兩組具有相同的總體變異數,並使用單一的合併標準差進行計算——在該假定成立時檢定力略高。不勾選時,每組使用各自的變異數估計(Welch t 檢定),當所輸入的兩個標準差明顯不同時更可靠。如果不確定,請保持不勾選,因為這是更安全、更保守的選擇。
- Download as Excel: 將檢定結果、彙總統計量、信賴區間和 p 值匯出為 Excel 文件,用於報告、分享或記錄留存。
常見問題
什麼是彙總資料的雙樣本 t 檢定?
它執行與標準雙樣本 t 檢定相同的比較,即檢定兩個獨立組的平均值是否存在顯著差異,但它基於您輸入的彙總統計量,即每組的樣本數、平均值和標準差,而不是原始資料。
何時應使用匯總資料的雙樣本 t 檢定?
當沒有原始資料,但有每組的平均值、標準差和樣本數時使用,例如來自已發表的報告、外部供應商資料或歷史彙總資料。它也可用於對彙總資料的結論進行快速交叉核對。如果有原始資料,請使用標準雙樣本 t 檢定。
基於彙總統計量的 t 檢定有哪些侷限?
t 檢定假定常態性,而沒有原始資料就無法驗證,因此當彙總資料來自嚴重偏態或非常態的總體時要謹慎。非常態分配的小樣本可能給出不可靠的結果,而所輸入統計量中的任何錯誤都會直接導致錯誤的結論。
標準差如何影響彙總資料的 t 檢定?
標準差越大,組內變異越大,會使信賴區間變寬,並降低檢定對差異的靈敏度。如果兩個標準差明顯不同,請保持 Assume Equal Variances 不勾選,這樣將使用各自的變異數估計(Welch t 檢定)。