
Aanvullende mogelijkheden voor bioassay met vierparameter-logistisch model
Deze uitbreiding op de Four-Parameter Logistic Method voegt de instelling ANOVA / CI error term toe. Sequential (standaard) geeft elke F-toets zijn eigen residu van het geneste model; Pure Error gebruikt het residu van het verzadigde model voor alle drie de F-toetsen voor validiteit (Regression, Non-parallelism, Lack of Fit) en voor het betrouwbaarheidsinterval van de potentie, zoals EP 5.3-software dat doet. Pure Error vereist enige replicatie. De curveparameters en de potentieschatting blijven ongewijzigd.
Laatst beoordeeld
Belangrijkste conclusie
Met de foutterm-optie voor de 4PL-bioassay kiest u of de F-toetsen voor validiteit en het betrouwbaarheidsinterval van de potentie sequentiële geneste residuen of één zuivere-foutterm gebruiken, zoals in EP 5.3.
Op deze pagina
- Bioassay — Four-Parameter Logistic Method
- Wat is er toegevoegd?
- Regelgevende en statistische achtergrond
- De wiskunde
- Onderbouwing: waarom twee conventies en wanneer gebruikt u welke?
- Wat verandert er in de uitvoer, en wat niet?
- Waar vindt u deze mogelijkheid?
- Verificatie aan de hand van gepubliceerde referentiegegevens
- Referenties
Bioassay — Four-Parameter Logistic Method
Toegevoegde mogelijkheid: optionele foutterm voor ANOVA / betrouwbaarheidsinterval (“Sequential” versus “Pure Error”)
Wat is er toegevoegd?
De Four-Parameter Logistic Method krijgt dezelfde soort optionele foutterm-conventie die al aan de methoden Parallel Line en Slope Ratio is toegevoegd, aangepast aan de modelstructuur van deze methode. De optie bepaalt welke variantieschatting alle drie de F-toetsen voor validiteit en het betrouwbaarheidsinterval van de potentie gezamenlijk voedt (en dus niet alleen het betrouwbaarheidsinterval, zoals bij de twee lineaire methoden). Dat weerspiegelt hoe de ANOVA van deze methode is opgebouwd. De gefitte curveparameters en de puntschatting van de potentie veranderen in beide gevallen niet.
Regelgevende en statistische achtergrond
Een vierparameter-logistische (4PL) assay fit een sigmoïdale curve — bepaald door een bovenste asymptoot, een onderste asymptoot, een hellingsfactor en een buigpunt — aan de respons van elk preparaat tegen de log-dosis. Voor de toetsen op validiteit worden drie geneste modellen vergeleken: een nulmodel (vlakke lijn), een model waarin alle preparaten één gemeenschappelijke curvevorm delen (alleen het buigpunt mag verschillen, en dat levert de potentieschatting op) en een volledig afzonderlijke curve die voor elk preparaat apart wordt gefit.
Net als bij de andere bioassaymethoden bouwt commerciële software die voldoet aan de European Pharmacopoeia (Ph. Eur.), hoofdstuk 5.3 — “Statistical Analysis of Results of Biological Assays and Tests” — conventioneel alle drie de F-toetsen voor validiteit en het betrouwbaarheidsinterval van de potentie op met één gedeelde foutvariantieterm: de “Pure-error ANOVA”-conventie. De bestaande standaardinstelling van deze tool geeft daarentegen elke F-toets zijn eigen, plaatselijk geschiktere foutterm.
De wiskunde
Conventie A — “Sequential” (de bestaande standaardinstelling van deze tool). Elk van de drie F-toetsen wordt opgebouwd uit het specifieke paar geneste modellen waartussen wordt getoetst, met de residuele variantie van die vergelijking als noemer:
F(Regression) = MS(verklaard door gedeelde curve t.o.v. vlak) / MS(residu van de fit met gedeelde curve)
F(Non-parallelism) = MS(verklaard door afzonderlijke curven t.o.v. gedeelde curve) / MS(residu van de fit met afzonderlijke curven)
F(Lack of Fit) = MS(verklaard door verzadigde fit t.o.v. afzonderlijke curven) / MS(residu van de verzadigde fit, d.w.z. pure fout)
en het betrouwbaarheidsinterval van de potentie gebruikt eveneens het eigen residu van het model met gedeelde curve — waarin ook een kleine, niet-significante mate van non-parallellisme is meegenomen.
Conventie B — “Pure Error” (de nieuwe optie; de “Pure-error ANOVA” van EP 5.3). Alle drie de F-toetsen en het betrouwbaarheidsinterval van de potentie delen hier één enkele noemer: het residu van de volledig verzadigde fit met één curve per preparaat/dosisgroep:
F(elke toets) = MS(verklaard door de vergelijking van die toets) / MS(pure fout, uit de verzadigde fit) — elke keer dezelfde noemer
Onderbouwing: waarom twee conventies en wanneer gebruikt u welke?
De twee conventies beantwoorden licht verschillende vragen, precies zoals bij de twee lineaire methoden: de sequentiële conventie laat de significantie van elke toets beoordelen tegen de variabiliteit die voor die vergelijking relevant is, terwijl de pure-foutconventie bij elke toets dezelfde onderliggende vraag stelt — “hoe verhoudt deze afwijking zich tot pure replicaatruis, zonder dat er iets anders in is meegenomen?” — en bovendien het betrouwbaarheidsinterval van de potentie koppelt aan diezelfde, kleinst mogelijke foutschatting.
Bij een goed passende, geldige assay is het verschil tussen beide meestal klein. Het wordt duidelijker wanneer er een bescheiden, niet-significante mate van non-parallellisme of lack-of-fit is, omdat de sequentiële conventie die extra variabiliteit opneemt in de foutterm van de bijbehorende toets (en van het interval van de potentie), terwijl de pure-foutconventie die overal bewust uitsluit.
Net als bij de andere methoden is het kiezen van “Pure Error” vooral bedoeld om resultaten af te stemmen op commerciële software die voldoet aan EP 5.3, of op een gevalideerde oudere methode die op de Pure-error ANOVA-conventie is gebaseerd. De bestaande sequentiële standaardinstelling van de tool blijft een volledig geldige keuze wanneer geen externe vergelijking nodig is.
Wat verandert er in de uitvoer, en wat niet?
Beïnvloed:
- F-waarde en P-waarde voor alle drie de toetsen voor validiteit (Regression, Non-parallelism, Lack of Fit)
- Een nieuwe kolom “Error Term” in de ANOVA-tabel die aangeeft welke conventie en welke vrijheidsgraden zijn gebruikt
- Lower CL en Upper CL van het betrouwbaarheidsinterval van de potentie, en een nieuwe kolom “CI Error Term”
Niet beïnvloed:
- De gefitte curveparameters (bovenste/onderste asymptoot, hellingsfactor, buigpunt) voor elk preparaat
- De geschatte relatieve potentieverhouding
- De gefitte modelvergelijking die voor elk preparaat wordt getoond
Waar vindt u deze mogelijkheid?
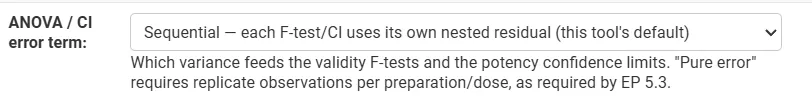
Op het invoerformulier van de tool Four-Parameter Logistic Method biedt een veld met het label “ANOVA / CI error term” de keuze tussen “Sequential — each F-test/CI uses its own nested residual (this tool's default)” en “Pure error — single saturated-model residual for all F-tests and the CI (EP 5.3 default)”. De pure-foutoptie vereist dat het verzadigde model (één fit per preparaat/dosisgroep) minstens één residuele vrijheidsgraad heeft, d.w.z. dat er enige replicatie in de gegevens zit.
Verificatie aan de hand van gepubliceerde referentiegegevens
Deze optie is gecontroleerd aan de hand van een gepubliceerde serologische assay van tetanusantitoxine, waarin een standaardpreparaat en één testserumpreparaat zijn vergeleken over tien tweevoudige verdunningsstappen, met twee replicaten per dosis.
Bron: European Pharmacopoeia, 5th Edition (2005), Chapter 5.3, worked example 5.4.1.a — as reproduced in Stegmann Systems' PLA 3.0 published example report (Document-3567, "PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf")
Maatstaf | Gepubliceerd (PLA/EP 5.3) | Berekend (optie Pure Error) |
Regressie-F (df=3) | 9785.4821 | 9788.5262 |
Non-parallellisme-F (df=3) | 0.48912 | 0.4884 |
Lack-of-fit-F (df=12) | 0.62266 | 0.6216 |
Potentieverhouding | 1.45886 | 1.45880 (afgerond: 1.4588) |
Geschatte potentie van het monster (IU/ml) | 0.58354 | 0.5835 |
95%-BI (potentie van het monster, IU/ml) | 0.55511 – 0.61343 | 0.5544 – 0.6127 |
De curvevormparameters (bovenste/onderste asymptoot, hellingsfactor, buigpunten) en de puntschatting van de potentie kwamen onder beide conventies vrijwel exact overeen met het gepubliceerde rapport, wat bevestigt dat de fit zelf door deze optie niet wordt beïnvloed, zoals bedoeld. De F-waarden en het betrouwbaarheidsinterval die met de pure-foutoptie zijn berekend, liggen dicht bij de gepubliceerde waarden; het kleine resterende verschil (vooral zichtbaar in het betrouwbaarheidsinterval) is toe te schrijven aan het feit dat het gepubliceerde rapport zijn tussenwaarden vóór de eindberekening op drie decimalen afrondt. De bestaande sequentiële standaardinstelling van de tool was, zoals verwacht, niet bedoeld om met dit “Pure-error ANOVA”-rapport overeen te komen en is apart gecontroleerd op interne consistentie.
Referenties
- European Pharmacopoeia (Ph. Eur.), hoofdstuk 5.3 — “Statistical Analysis of Results of Biological Assays and Tests” (5e editie, 2005, en latere edities).
- United States Pharmacopeia, General Chapter <111> — “Design and Analysis of Biological Assays”.
- Stegmann Systems GmbH, PLA 3.0 published worked example: "PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf" — https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel_logistic_potency_assays__3PL__4PL__5PL_/PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf
Veelgestelde vragen
Wat is een vierparameter-logistische (4PL) bioassay?
Een 4PL-assay fit een sigmoïdale curve, gedefinieerd door een bovenste asymptoot, een onderste asymptoot, een hellingsfactor en een buigpunt, aan de respons van elk preparaat tegen de log-dosis. Voor de validiteitstoetsen worden een vlakkelijnmodel, een model met gedeelde vorm waarin alleen het buigpunt verschilt (dat de potentieschatting oplevert) en volledig afzonderlijke curven voor elk preparaat met elkaar vergeleken.
Wat is het verschil tussen sequentiële en pure-fout ANOVA in een 4PL-assay?
In de sequentiële conventie gebruikt elke F-toets het residu van de specifieke geneste modellen die hij vergelijkt, en gebruikt het potentie-interval het residu van de gedeelde curve. In de pure-foutconventie delen alle drie de F-toetsen en het potentie-interval één noemer: het residu van de volledig verzadigde fit. De gefitte curve en de potentieschatting zijn onder beide gelijk.
Wanneer gebruikt u de pure-foutoptie voor een 4PL-assay?
Gebruik pure error vooral om resultaten af te stemmen op EP 5.3-conforme software of een gevalideerde oudere methode die op de pure-error ANOVA-conventie is gebaseerd. Bij een goed passende, geldige assay verschillen de twee conventies meestal weinig. Het verschil groeit bij een bescheiden, niet-significante mate van non-parallellisme of lack of fit. In andere gevallen blijft de sequentiële standaardinstelling geldig.
Hoe selecteert u de foutterm in Zometric Statistical Software?
Gebruik op het invoerformulier van de Four-Parameter Logistic Method het veld ANOVA / CI error term om Sequential (de standaardinstelling) of Pure error te kiezen. De pure-foutoptie vereist dat het verzadigde model minstens één residuele vrijheidsgraad heeft, wat betekent dat er enige replicatie in de gegevens moet zijn.