
ARIMA (Box-Jenkins-voorspelling)
ARIMA modelleert een reeks die met gelijke tussenpozen is gemeten met autoregressieve (p), differentiatie- (d) en voortschrijdend-gemiddelde-termen (q), plus optionele seizoenstermen (P, D, Q, s) en een constante. Gebruik het wanneer waarden afhangen van eerdere waarden of de reeks een trend of seizoen heeft. ACF- en PACF-plots helpen bij de keuze van de ordes. De uitvoer bevat parameterschattingen, Ljung-Box-toetsen, residu-ACF/PACF, MAPE, MAD, MSD en voorspellingen met voorspellingsgrenzen.
Laatst beoordeeld
Belangrijkste conclusie
ARIMA past een autoregressief geïntegreerd voortschrijdend-gemiddeldemodel van Box-Jenkins toe op een tijdreeks met gelijke tussenpozen en voorspelt toekomstige waarden met voorspellingsintervallen, inclusief doorwerking, trend en seizoen.
Op deze pagina
Doel
ARIMA past een autoregressief geïntegreerd voortschrijdend-gemiddeldemodel van Box-Jenkins toe op een reeks die met gelijke tijdsintervallen is gemeten (dagelijks, wekelijks, maandelijks) en voorspelt de volgende waarden met voorspellingsintervallen. Gebruik het wanneer elke waarde afhangt van de voorgaande waarden, of wanneer de reeks een trend of een terugkerend seizoen heeft dat eenvoudiger methoden, zoals voortschrijdende gemiddelden of exponentiële afvlakking, niet goed vastleggen. De autocorrelatieplot (ACF) en de partiële autocorrelatieplot (PACF) van de reeks helpen om de modelordes te kiezen voordat u het model uitvoert.
Belangrijkste mogelijkheden
- Niet-seizoensgebonden autoregressieve (p), differentiatie- (d) en voortschrijdend-gemiddelde-termen (q), plus seizoenstermen (P, D, Q) voor elke seizoensperiode, bijvoorbeeld 12 voor maandgegevens met een jaarpatroon of 7 voor dagelijkse gegevens met een weekpatroon.
- Optionele constante term: het gemiddelde niveau van een niet-gedifferentieerde reeks, of de gemiddelde drift (trend) van een gedifferentieerde reeks.
- Parameterschattingen met standaardfouten, T-waarden en p-waarden, zodat u overbodige termen kunt weglaten.
- Residucontroles: residuele kwadratensom en gemiddelde kwadratensom, gewijzigde Box-Pierce-chikwadraattoetsen (Ljung-Box) bij lags 12, 24, 36 en 48, en ACF- en PACF-plots van de residuen.
- Voorspellingen met onderste en bovenste voorspellingsgrenzen bij het betrouwbaarheidsniveau dat u kiest; met een voorspellingsoorsprong kunt u vanaf een eerdere rij voorspellen en de voorspellingen vergelijken met wat er werkelijk gebeurde.
- De nauwkeurigheidsmaten voor de fit MAPE, MAD en MSD, vergelijkbaar met de andere tijdreeksentools.
- Optionele extra uitvoer: schattingen bij elke iteratie, de correlatiematrix van de geschatte parameters, de terugwaartse voorspellingen en een residuplot vier-in-één.
Statistische methoden
Het model is φ(B)Φ(Bˢ)(1−B)ᵈ(1−Bˢ)ᴰ yₜ = C + θ(B)Θ(Bˢ) aₜ, waarbij B de backshift-operator is, φ en θ de niet-seizoensgebonden AR- en MA-polynomen van orde p en q zijn, Φ en Θ de seizoensgebonden AR- en MA-polynomen van orde P en Q in Bˢ zijn, s de seizoensperiode is, C de constante is en aₜ de residuen (toevallige schokken) zijn. De differentiatie (1−B)ᵈ(1−Bˢ)ᴰ verwijdert trend en seizoen voordat de AR- en MA-termen worden gefit, zodat aan het begin van de reeks d + D·s waarnemingen verloren gaan.
De parameters worden geschat met de kleinste-kwadratenmethode van Box-Jenkins met terugwaartse voorspellingen: startwaarden worden iteratief verfijnd om de som van de gekwadrateerde residuen te minimaliseren, waarbij de reeks achterwaarts wordt voorspeld om de waarden vóór de steekproef te leveren. De gemiddelde kwadratensom van de residuen is MS = SS / DF, met DF = aantal gedifferentieerde waarnemingen − aantal geschatte parameters. De T-waarde van elke coëfficiënt is de coëfficiënt gedeeld door zijn standaardfout, met de p-waarde uit de t-verdeling met de residuele DF. Voor een niet-gedifferentieerd model met een constante wordt ook het procesgemiddelde C / (φ(1)Φ(1)) gerapporteerd.
De Ljung-Box-toetsingsgrootheid Q = n(n+2) Σ rₖ² / (n−k) wordt berekend uit de residuautocorrelaties rₖ tot en met elke lag en vergeleken met een chikwadraatverdeling waarvan de DF gelijk is aan de lag min het aantal geschatte parameters; een p-waarde boven 0.05 betekent dat er geen aanwijzing is dat er autocorrelatie in de residuen overblijft. Voorspellingen worden recursief uit de gefitte vergelijking gemaakt; het voorspellingsinterval voor h perioden vooruit is de voorspelling ± z·√(MS·Σψⱼ²), waarbij de eerste h ψ-gewichten van het model worden opgeteld, zodat de intervallen breder worden naarmate de voorspellingshorizon groter is.
Invoervelden en opties
Veld | Beschrijving |
Variable (Y) | Vereist. De kolom met de reeks, in tijdsvolgorde, met gelijke tussenpozen. |
Autoregressive order (p) | Aantal niet-seizoensgebonden AR-termen (0 tot 10, standaard 1): hoeveel eerdere waarden doorwerken in de huidige waarde. |
Difference order (d) | Aantal niet-seizoensgebonden differentiaties (0 tot 3, standaard 0). Gebruik 1 voor een reeks met een trend die zwerft of groeit. |
Moving average order (q) | Aantal niet-seizoensgebonden MA-termen (0 tot 10, standaard 0): hoeveel eerdere toevallige schokken doorwerken. |
Include seasonal terms | Vink aan om de onderstaande seizoensordes toe te voegen. Het model heeft in totaal ten minste één AR- of MA-term nodig. |
Seasonal AR order (P) / Seasonal difference order (D) / Seasonal MA order (Q) | Seizoensordes (P en Q 0 tot 5, D 0 tot 2). D = 1 modelleert de verandering ten opzichte van het voorgaande jaar bij maandgegevens met s = 12. |
Seasonal period (s) | Vereist bij seizoenstermen: het aantal waarnemingen in één seizoen (12 voor maandgegevens met een jaarcyclus, 4 voor kwartaalgegevens, 7 voor dagelijkse gegevens met een weekcyclus). |
Include constant term | Standaard aangevinkt. Vink uit voor een gedifferentieerde reeks zonder drift. |
Number of forecasts | Hoeveel perioden er na de voorspellingsoorsprong worden voorspeld (0 tot 1000; 0 = geen voorspellingen). |
Confidence level (%) for forecast interval | Standaard 95. |
Forecast origin (row) | Optioneel. Voorspellingen beginnen na deze rij, op basis van de gegevens tot en met die rij; leeg = einde van de reeks. Gebruik dit om het model te toetsen aan gegevens die u al hebt. |
Results to display | Definitieve schattingen, differentiatie-informatie, residuele kwadratensommen, aantal waarnemingen; of daarnaast de schattingen bij elke iteratie, de correlatiematrix van de geschatte parameters of de terugwaartse voorspellingen. |
Residual plots (four in one) | Voegt een normale-waarschijnlijkheidsplot, residuen versus gefitte waarden, een histogram en residuen versus volgorde toe. |
Title | Titel die in de uitvoer wordt getoond. |
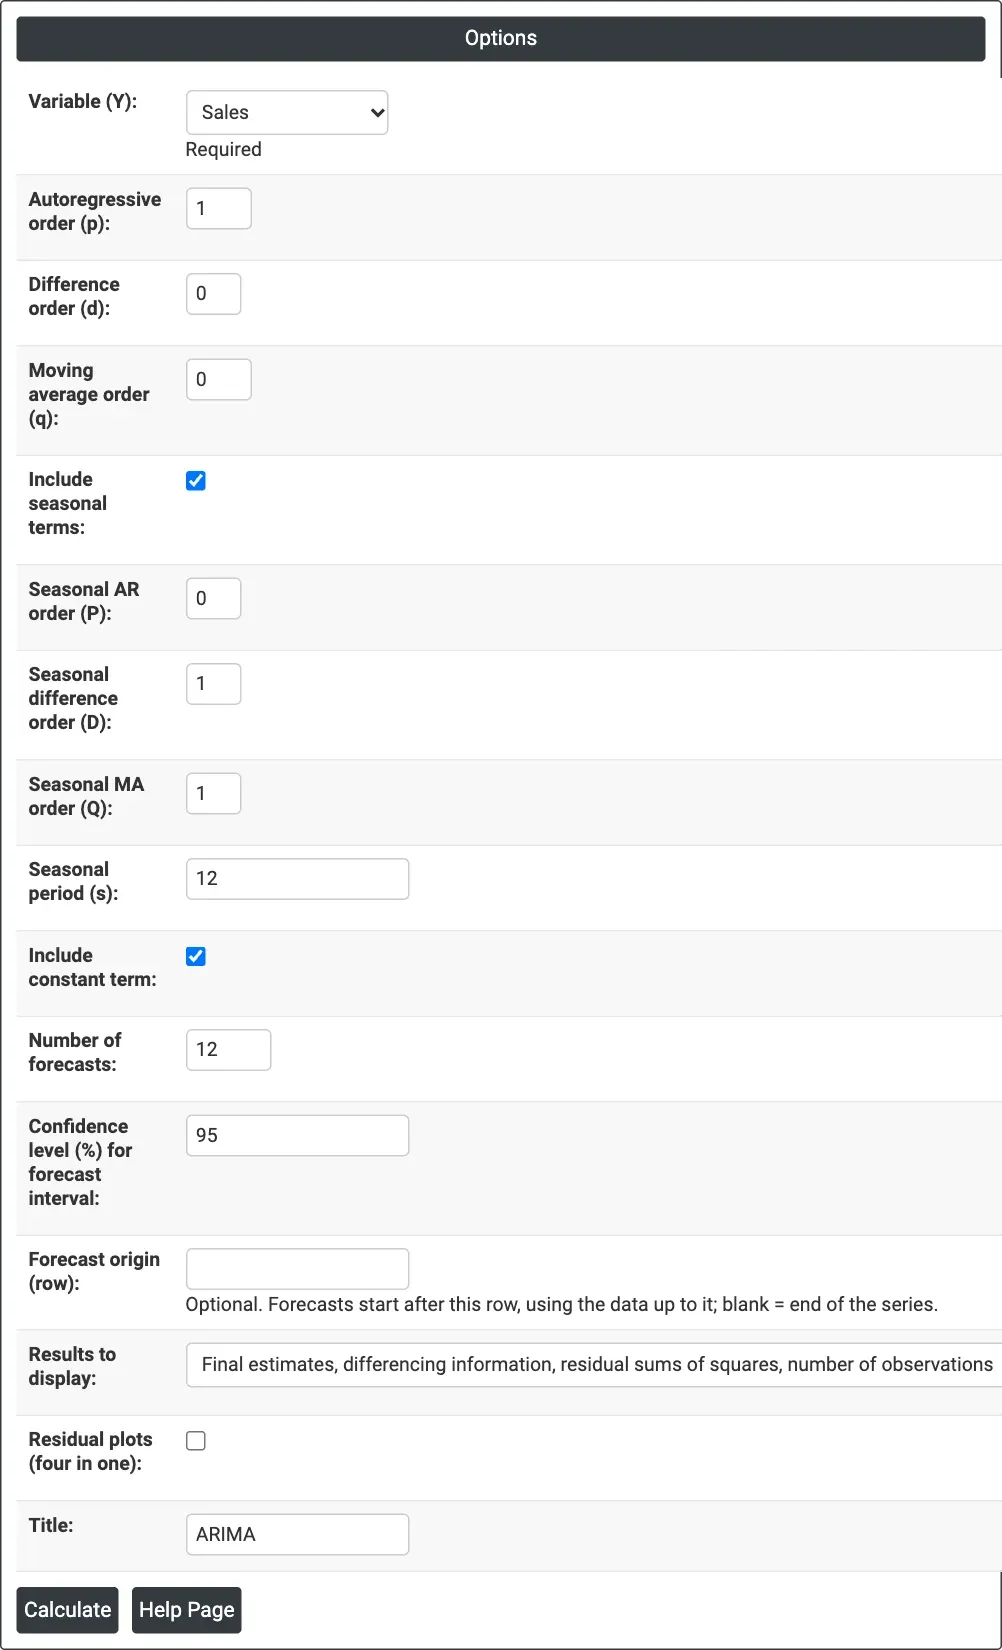
Figuur 1 — Het voorbeeld met maandelijkse verkopen: Variable (Y) = Sales, een seizoensgebonden ARIMA(1, 0, 0)(0, 1, 1)12-model met een constante en 12 voorspellingen.
Beschrijving van de uitvoer
- ARIMA plot — de reeks met de gefitte waarden, de voorspellingen en hun band van het voorspellingsinterval; MAPE, MAD en MSD staan onder de titel.
- Final Estimates of Parameters — elke AR-, SAR-, MA- en SMA-term en de constante, met coefficient, SE Coef, T-Value en P-Value (en de Mean voor een niet-gedifferentieerd model met een constante).
- Residual Sums of Squares — DF, SS en MS van de residuen.
- Modified Box-Pierce (Ljung-Box) Chi-Square statistic — Chi-Square, DF en P-Value bij lags 12, 24, 36 en 48 (lags die langer zijn dan de reeks worden weggelaten).
- Forecasts — periode, voorspelling, en onderste en bovenste voorspellingsgrenzen.
- ACF and PACF of Residuals — staven binnen de gestreepte grenzen betekenen dat er geen autocorrelatie overblijft.
- Optionele tabellen en plots die in Results to display en Residual plots zijn gekozen, en pdf-export via Download.
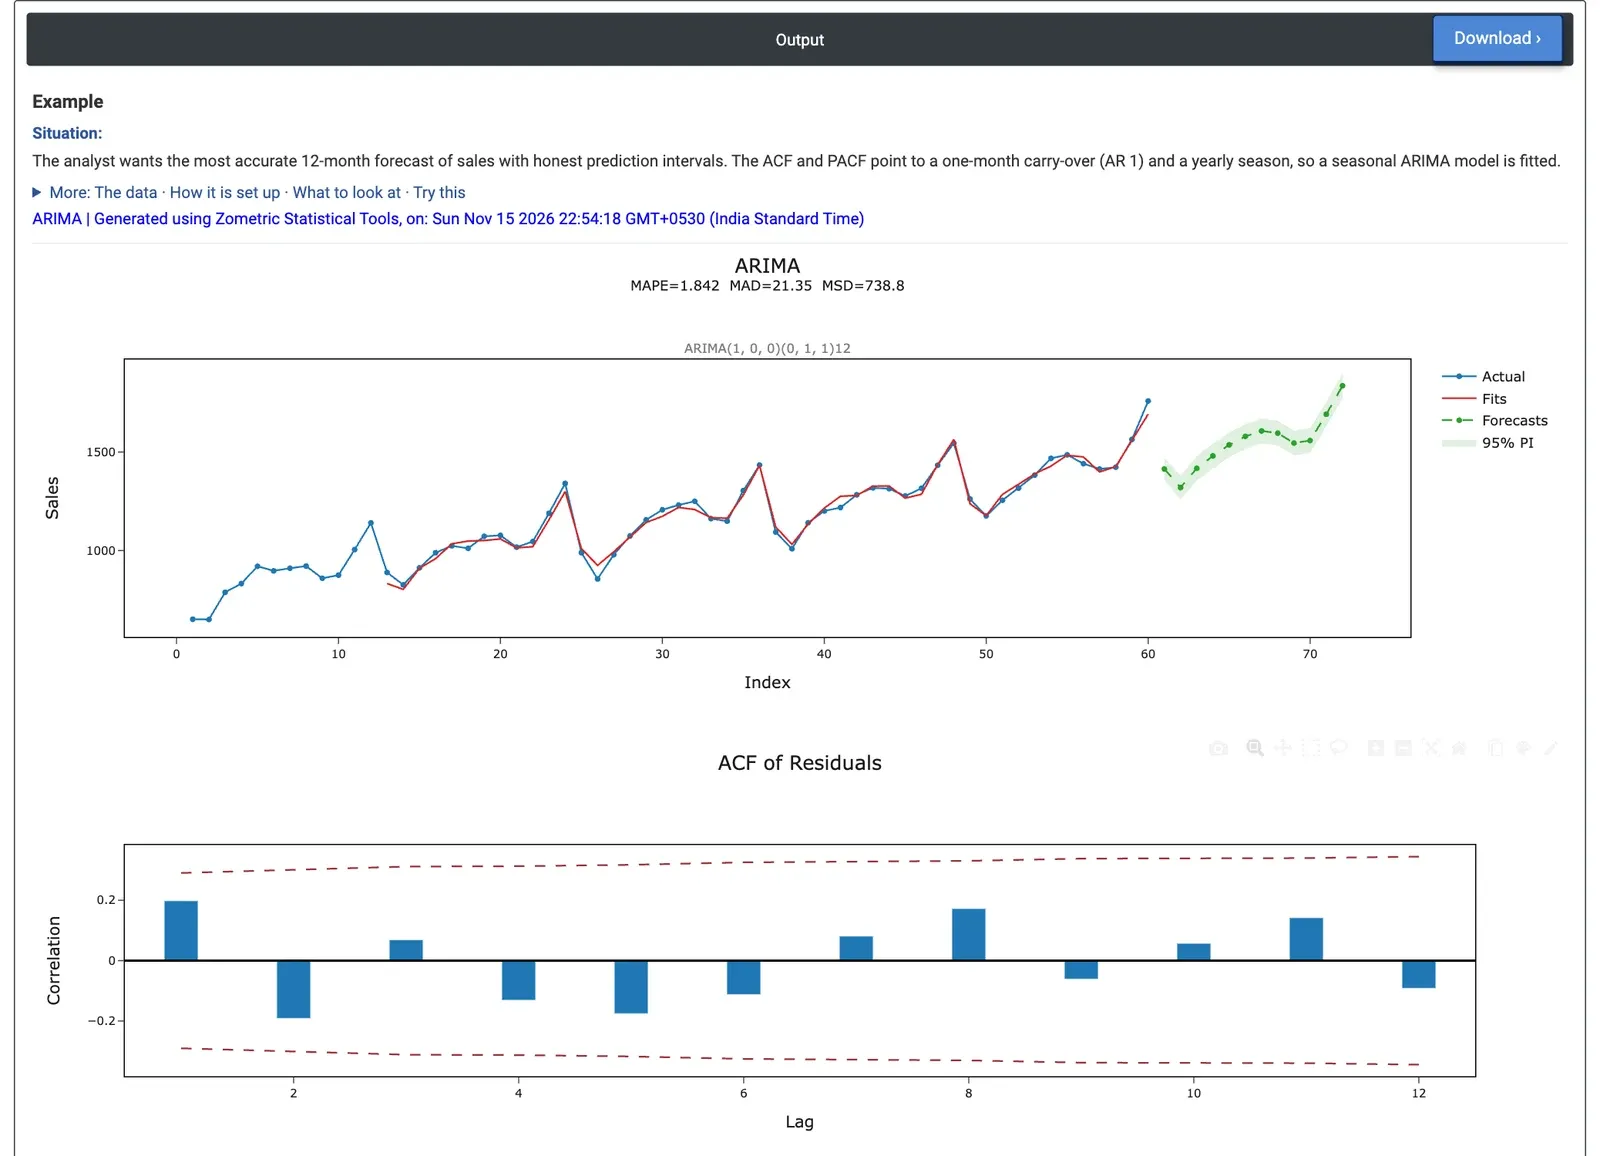
Figuur 2 — ARIMA-uitvoer voor het voorbeeld met maandelijkse verkopen: de fit en de voorspelling voor 12 maanden met de 95%-voorspellingsband, en de ACF van de residuen.
Uitgewerkt voorbeeld
Een analist heeft 60 maanden verkoopgegevens (januari 2020 tot en met december 2024) en wil een voorspelling voor 12 maanden met realistische voorspellingsintervallen. De ACF en PACF wijzen op een doorwerking van één maand en een jaarlijks seizoen, dus het model is ARIMA(1, 0, 0)(0, 1, 1)12 met een constante: Autoregressive order (p) = 1, Seasonal difference order (D) = 1, Seasonal MA order (Q) = 1, Seasonal period (s) = 12 en Number of forecasts = 12.
Beide termen zijn duidelijk nodig: AR 1 = 0.481 (SE 0.104, T = 4.63, p < 0.001) en SMA 12 = 0.805 (SE 0.144, T = 5.59, p < 0.001), met een constante van 69.34 (de gemiddelde groei ten opzichte van het voorgaande jaar). De residuele MS is 788.1 bij 45 DF (60 maanden − 12 verloren door de seizoensdifferentiatie − 3 parameters). De Ljung-Box-p-waarden zijn 0.214, 0.319 en 0.254 bij lags 12, 24 en 36, allemaal boven 0.05, dus de residuen lijken op willekeurige ruis en het model heeft het patroon vastgelegd. De fit is nauw: MAPE 1.84%, MAD 21.35, MSD 738.8.
De voorspelling voor januari 2025 (periode 61) is 1,414 stuks met een 95%-voorspellingsinterval van 1,359 tot 1,469, oplopend tot 1,837 voor december 2025 (periode 72), interval 1,774 tot 1,899. Om het model te toetsen voordat u het vertrouwt, stelt u Forecast origin (row) = 48 in om 2024 te voorspellen uit de gegevens tot en met december 2023 en vergelijkt u de voorspellingen met de werkelijke verkopen van 2024.
Veelgestelde vragen
Wat is een ARIMA-model?
ARIMA is een autoregressief geïntegreerd voortschrijdend-gemiddeldemodel van Box-Jenkins voor een reeks die met gelijke tijdsintervallen is gemeten. Autoregressieve termen laten eerdere waarden doorwerken, differentiatie verwijdert trend en voortschrijdend-gemiddelde-termen laten eerdere toevallige schokken doorwerken. Voor een terugkerend seizoen kunnen seizoenstermen worden toegevoegd, zoals periode 12 voor maandgegevens met een jaarpatroon.
Wanneer gebruikt u ARIMA in plaats van exponentiële afvlakking?
Gebruik ARIMA wanneer elke waarde afhangt van de voorgaande waarden, of wanneer de reeks een trend of terugkerend seizoen heeft dat eenvoudiger methoden, zoals voortschrijdende gemiddelden of exponentiële afvlakking, niet goed vastleggen. De autocorrelatieplot (ACF) en de partiële autocorrelatieplot (PACF) van de reeks helpen om de modelordes te kiezen voordat u het model fit.
Hoe controleert u of een ARIMA-model goed past?
Controleer of de p-waarde van elke term aantoont dat die nodig is, en bekijk de Ljung-Box-chikwadraattoetsen bij lags 12, 24, 36 en 48: een p-waarde boven 0.05 betekent dat er geen aanwijzing is voor resterende autocorrelatie in de residuen. De staven van de residu-ACF en -PACF moeten binnen de gestreepte grenzen blijven. MAPE, MAD en MSD vatten de nauwkeurigheid van de fit samen.
Hoe toetst u een ARIMA-voorspelling voordat u hem vertrouwt?
Stel een voorspellingsoorsprong in bij een eerdere rij, zodat het model voorspelt op basis van de gegevens tot dat punt, en vergelijk die voorspellingen vervolgens met wat er werkelijk gebeurde. In het uitgewerkte voorbeeld voorspelt een oorsprong bij rij 48 het jaar 2024 uit gegevens tot en met december 2023, ter vergelijking met de werkelijke verkopen van 2024. Voorspellingsintervallen worden breder naarmate de voorspellingshorizon groter is.