
Geautomatiseerde procescapabiliteit
Geautomatiseerde procescapabiliteit neemt de handmatige normaliteitscontrole weg. De tool voert een Anderson-Darling-toets uit: bij een p-waarde op of boven de drempel (standaard 0.1) berekent hij de normale Pp, Ppl, Ppu en Ppk; eronder past hij kandidaat-niet-normale verdelingen met maximum likelihood en gebruikt hij de z-scoremethode. De uitvoer toont de gevolgde route, een histogram met gefitte verdeling, de indices en de verwachte en waargenomen PPM.
Laatst beoordeeld
Belangrijkste conclusie
Geautomatiseerde procescapabiliteit toetst normaliteit met Anderson-Darling en berekent Pp en Ppk automatisch met het normale model of de best passende niet-normale verdeling, en legt vast welke route is gevolgd.
Op deze pagina
Doel
Geautomatiseerde procescapabiliteit neemt de handmatige stap weg om eerst de normaliteit te toetsen en daarna apart te kiezen tussen een normaal of een niet-normaal capabiliteitsmodel. De tool voert zelf de Anderson-Darling-normaliteitstoets uit en leidt de berekening automatisch naar de standaard normale capabiliteitsindices als de gegevens de toets doorstaan, of naar een best passende niet-normale verdeling (gekozen uit de bibliotheek met kandidaatverdelingen van de app) als dat niet zo is. Het resultaat is één rapport waarin de gemaakte keuze bovenaan is vastgelegd.
Belangrijkste mogelijkheden
- Voert de Anderson-Darling-normaliteitstoets automatisch uit; een aparte normaliteitscontrole is niet nodig.
- Kiest automatisch de best passende niet-normale kandidaatverdeling wanneer de aanname van normaliteit wordt verworpen, met dezelfde bibliotheek voor het fitten van verdelingen als de andere niet-normale capabiliteitstools van de app.
- Instelbare drempel voor de p-waarde van de normaliteitstoets, zodat gebruikers kunnen bepalen hoe conservatief de tool standaard voor de normale route kiest.
- Meldt rechtstreeks in de uitvoer welke route is gevolgd (normaal of niet-normaal, en met welke verdeling), zodat de keuze transparant en controleerbaar is.
- Ondersteunt een optionele Factor-kolom en een modus “Compare selected columns as separate groups”, in lijn met de andere capabiliteitstools van de app.
Statistische methoden
Normaliteit wordt beoordeeld met de Anderson-Darling-toets (anderson() van scipy tegen een normale referentie), met de gangbare correctie voor kleine steekproeven AD = A²·(1 + 0.75/n + 2.25/n²). De p-waarde volgt uit de stuksgewijze empirische benaderingen van D'Agostino–Stephens voor de gecorrigeerde AD-statistiek.
Routeringsregel: als de p-waarde van Anderson-Darling groter is dan of gelijk aan de drempel voor de p-waarde van de normaliteitstoets (standaard 0.1), behandelt de tool de gegevens als normaal. Hij schat σ_overall met de methode van de voortschrijdende spreidingsbreedte (MRbar/d2, of een variant met de mediaan van de voortschrijdende spreidingsbreedte) en berekent daaruit de standaard op z gebaseerde prestatie-indices Pp, Ppl, Ppu en Ppk. Valt de p-waarde onder de drempel, dan past de tool elke door de app ondersteunde niet-normale kandidaatverdeling (Weibull, 3-Parameter Weibull, Exponential, 2-Parameter Exponential, Gamma, Logistic, Loglogistic, Lognormal en de Smallest/Largest Extreme Value-verdelingen) met maximum likelihood, rangschikt ze op aanpassingskwaliteit en kiest automatisch de best passende.
Voor de niet-normale route wordt de CDF van de gekozen verdeling geëvalueerd bij LSL en USL om de staartkansen p_lsl en p_usl te krijgen. Die worden met de inverse normale CDF (norm.ppf) omgezet in equivalente standaardnormale z-scores: de “z-scoremethode”. De capabiliteit wordt vervolgens op de vertrouwde Cpk-schaal gerapporteerd met die z-scores: Pp = (z_usl − z_lsl) / 6, PPL = −norm.ppf(p_lsl) / 3, PPU = norm.ppf(p_usl) / 3, Ppk = min(PPL, PPU). Zo wordt het werkelijke staartrisico van een scheve verdeling vastgelegd voordat het wordt uitgedrukt in dezelfde Cpk-achtige eenheden die overal in de app worden gebruikt, in plaats van een ruwe normale Z-score ten onrechte op niet-normale gegevens toe te passen.
PPM-cijfers (parts per million) worden op twee manieren gerapporteerd: de “verwachte” PPM uit de staartkansen van de gefitte verdeling voorbij elke specificatiegrens, en de “waargenomen” PPM, die eenvoudig het deel van de ruwe steekproef telt dat daadwerkelijk buiten de specificatiegrenzen valt.
Invoervelden en opties
Veld | Beschrijving |
Choose columns | De responskolom(men) die moeten worden geanalyseerd. |
Factor | Optioneel. Vergelijk de capabiliteit tussen groepen wanneer de gegevens uit één Response-kolom plus een Factor-kolom bestaan. |
Compare selected columns as separate groups | Wanneer 2 of meer kolommen zijn geselecteerd, wordt de capabiliteit voor elke kolom afzonderlijk uitgevoerd en naast elkaar vergeleken. |
LSL / USL | Onderste en bovenste specificatiegrens, toegepast op elke geselecteerde kolom. |
Normality p-value threshold | Standaard 0.1. Als de p-waarde van Anderson-Darling op of boven deze waarde ligt, wordt de capabiliteit berekend onder de aanname van normaliteit; eronder wordt de best passende niet-normale verdeling automatisch gekozen en gebruikt. |
Download as Excel | Optioneel. Exporteert het rapport naar een Excel-werkmap. |
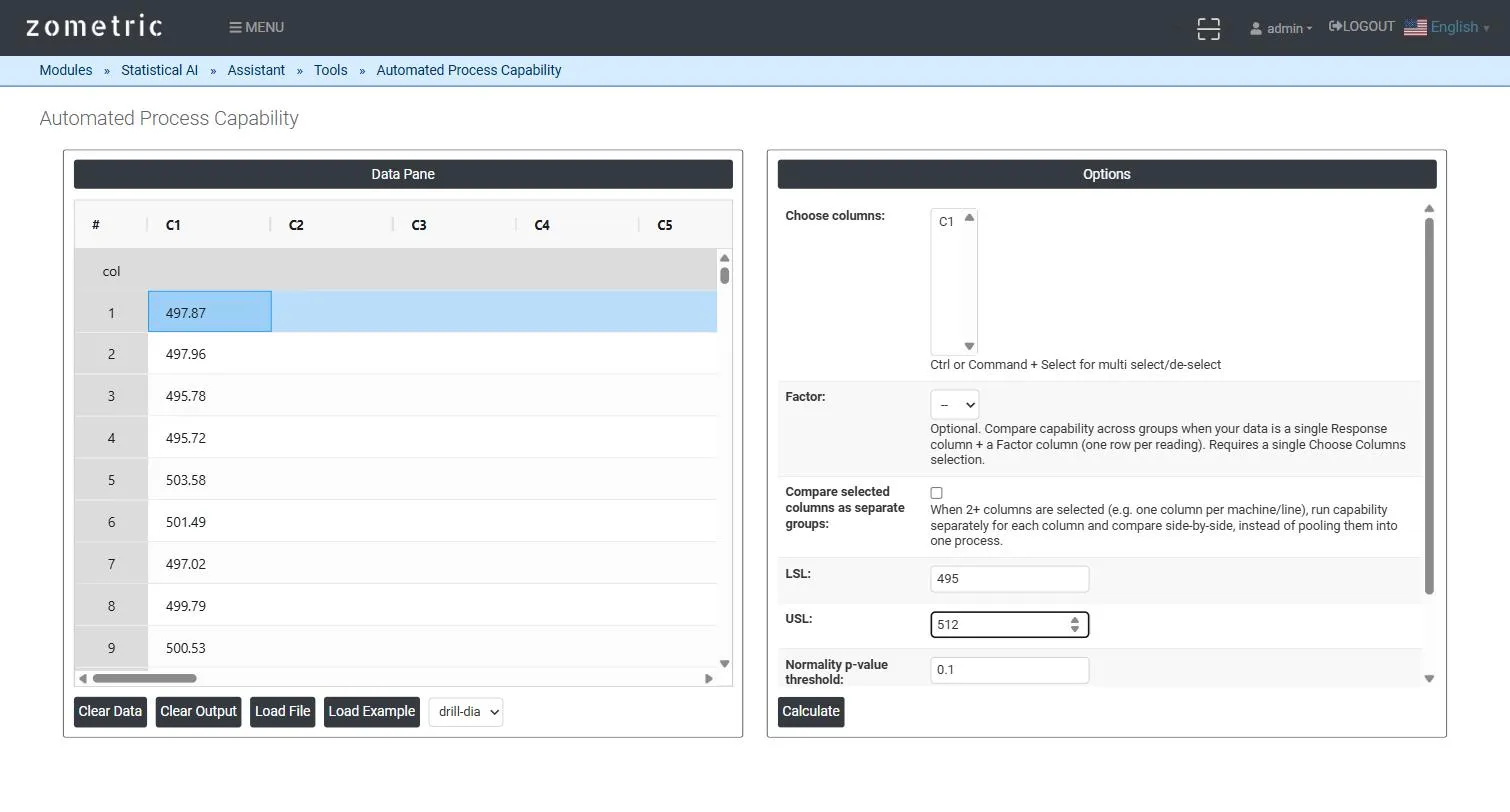
Figuur 1 — Data pane met 60 metingen van vulgewicht geplakt in C1, met LSL/USL en Normality p-value threshold ingevuld in het paneel Options.
Beschrijving van de uitvoer
- Resultaat van de normaliteitstoets: de Anderson-Darling-statistiek en p-waarde, en de gevolgde route (normaal, of de specifieke automatisch gekozen niet-normale verdeling).
- Histogram van de gefitte verdeling: steekproefhistogram met de gefitte dichtheidscurve en referentielijnen voor LSL/USL erover heen.
- Parametertabel van de verdeling: LSL, USL, steekproefgemiddelde, steekproefomvang en de vorm-/schaalparameters (of equivalente parameters) van de gefitte verdeling.
- Capabiliteitsindices: Pp, Ppl, Ppu en Ppk, berekend met de gekozen verdeling.
- PPM-tabellen: verwachte PPM (uit de staarten van de gefitte verdeling) en waargenomen PPM (uit de ruwe steekproef), elk uitgesplitst in PPM < LSL, PPM > USL en PPM Total.
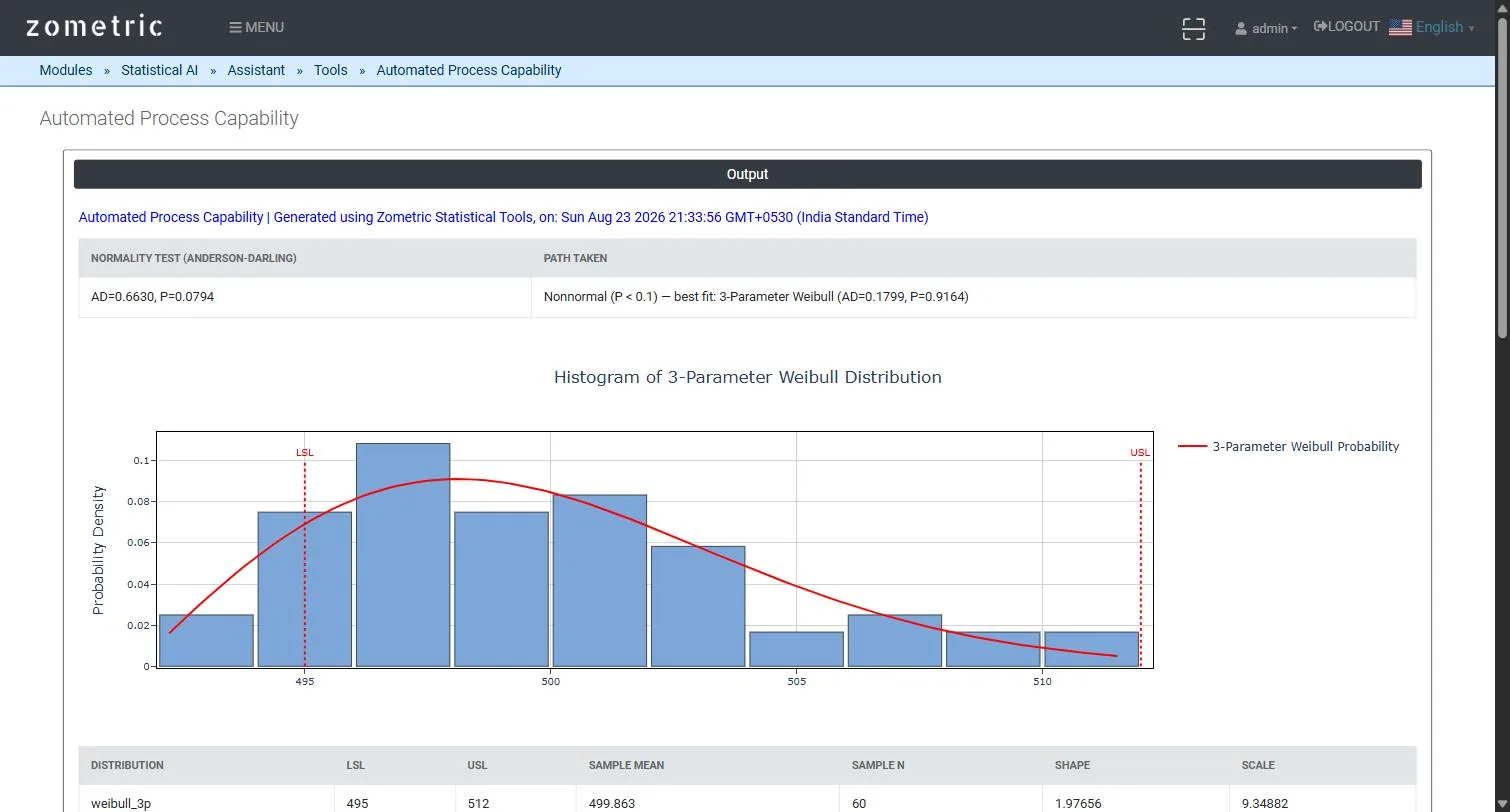
Figuur 2 — Verdelingsparameters en de resulterende indices Pp/Ppl/Ppu/Ppk met tabellen voor verwachte en waargenomen PPM.
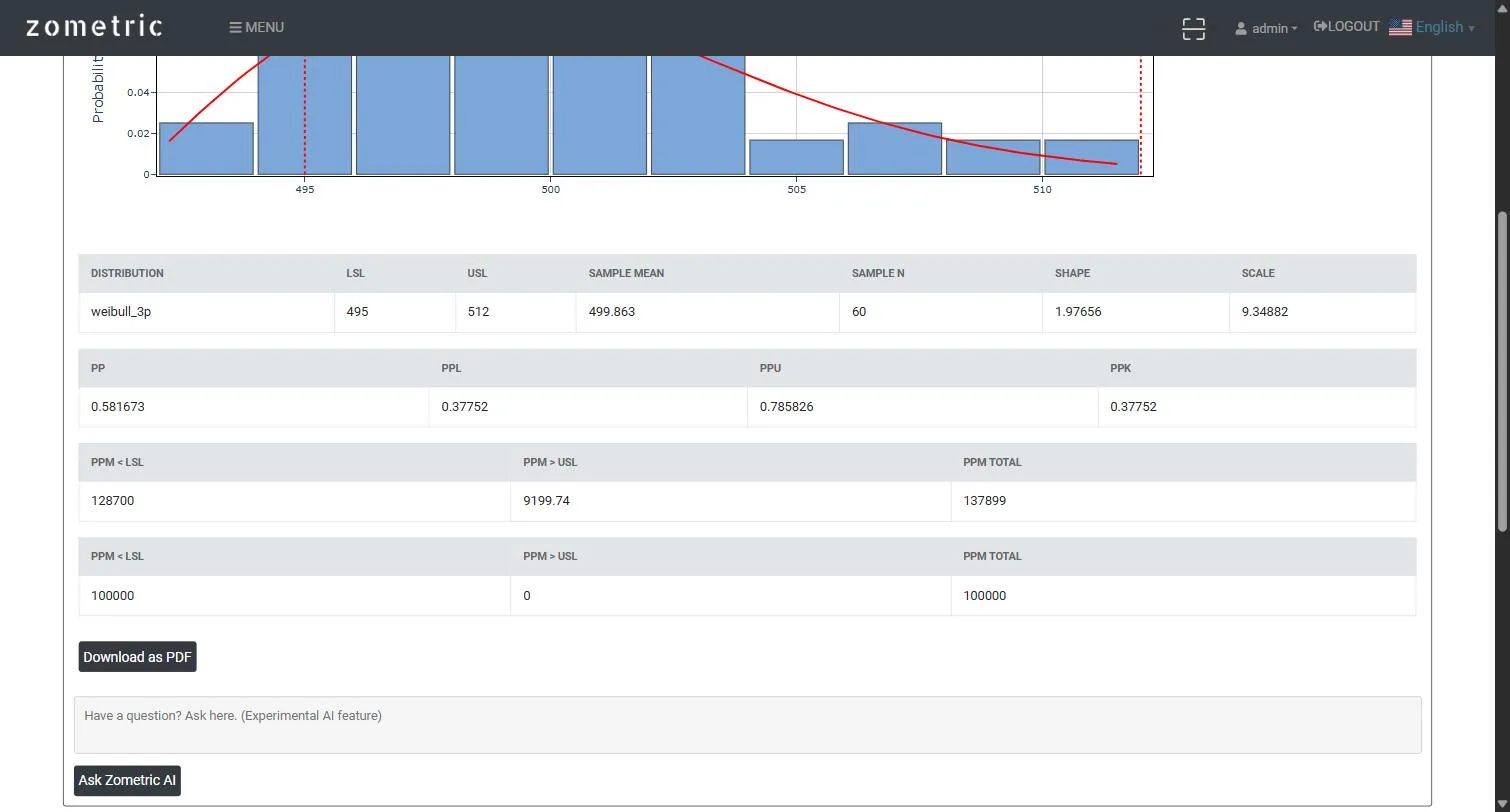
Figuur 3 — Automatische routeringsbeslissing (Anderson-Darling-resultaat en gevolgde route) met het histogram van de gefitte verdeling.
Uitgewerkt voorbeeld
Een vullijn vult flessen met een stroperige reinigingsvloeistof; het vulgewicht (g) wordt gemeten aan 60 flessen die gedurende een dienst zijn genomen (kolom C1), met LSL = 495 g en USL = 512 g. Bij de standaarddrempel van 0.1 geeft de Anderson-Darling-toets AD = 0.6630 en P = 0.0794, onder de drempel. De tool leidt de berekening daarom automatisch naar de niet-normale route en kiest een 3-Parameter Weibull-fit (AD = 0.1799, P = 0.9164) als best passende verdeling. Hij rapporteert Ppk = 0.378 op basis van de staartkansen van de gefitte Weibull-verdeling, en niet op basis van een (misleidende) aanname van een normale verdeling.
Veelgestelde vragen
Wat doet geautomatiseerde procescapabiliteit?
De tool voert de Anderson-Darling-normaliteitstoets uit op de gegevens en leidt de capabiliteitsberekening daarna automatisch: naar de standaard normale capabiliteitsindices als de gegevens de toets doorstaan, of naar de best passende niet-normale verdeling als dat niet zo is. Eén rapport toont het resultaat van de normaliteitstoets, de gevolgde route en de gebruikte verdeling, zodat de keuze transparant en controleerbaar is.
Hoe beslist de tool tussen normale en niet-normale capabiliteit?
Als de p-waarde van Anderson-Darling groter is dan of gelijk aan de drempel voor de p-waarde van de normaliteitstoets (standaard 0.1), worden de gegevens als normaal behandeld. Valt hij eronder, dan past de tool kandidaatverdelingen zoals Weibull, 3-Parameter Weibull, Gamma, Lognormal en andere met maximum likelihood, rangschikt ze op aanpassingskwaliteit en kiest de beste.
Hoe wordt Ppk berekend voor niet-normale gegevens?
De CDF van de gekozen verdeling geeft de staartkansen voorbij LSL en USL, die worden omgezet in equivalente standaardnormale z-scores. Daarna geldt PPL = -z(p_lsl)/3, PPU = z(p_usl)/3 en Ppk = min(PPL, PPU). Zo wordt het werkelijke staartrisico van een scheve verdeling vastgelegd en blijven de resultaten op de vertrouwde Cpk-achtige schaal.
Hoe voert u geautomatiseerde capabiliteit uit in Zometric Statistical Software?
Plak de gegevens, kies de responskolom of -kolommen, eventueel een Factor of de optie om kolommen als afzonderlijke groepen te vergelijken, en voer LSL en USL in. Stel de Normality p-value threshold in (standaard 0.1). Het rapport toont de routeringsbeslissing, het histogram van de gefitte verdeling, de verdelingsparameters, de capabiliteitsindices en de PPM-tabellen, en kan naar Excel worden geëxporteerd.