
Regressie met beste deelverzamelingen (best subsets)
Best subsets-regressie fit modellen met gewone kleinste kwadraten voor elke deelverzameling van vrije voorspellers, desgewenst met enkele voorspellers die in alle modellen worden afgedwongen, en toont de beste één tot vijf modellen van elke omvang. Elke rij rapporteert R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp en S, met optioneel PRESS, AICc, BIC en VIF. Gebruik het vroeg om voorspellers te selecteren en fit daarna het gekozen model met Regressiemodel fitten.
Laatst beoordeeld
Belangrijkste conclusie
Best subsets-regressie fit een lineaire regressie voor elke combinatie van kandidaat-voorspellers en toont de beste modellen van elke omvang, zodat u de kleinste set vindt die het grootste deel van de variatie in de respons verklaart.
Op deze pagina
Doel
Best subsets-regressie fit een lineaire regressie voor elke combinatie van de kandidaat-voorspellers en toont de beste modellen van elke omvang naast elkaar. Gebruik het vroeg in een onderzoek, wanneer u meerdere mogelijke procesinstellingen hebt en de kleinste set wilt die het grootste deel van de variatie in de respons verklaart, voordat u het gekozen model in detail fit met Regressiemodel fitten.
Belangrijkste mogelijkheden
- Fit elke deelverzameling van de vrije voorspellers, van het minimum tot het maximum aantal dat u instelt.
- Toont de beste één tot vijf modellen van elke omvang, gerangschikt op R-Sq.
- Rapporteert R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp en S voor elk model, met op verzoek PRESS, AICc en BIC.
- Predictors in all models: dwing variabelen waarvan u weet dat ze ertoe doen af in elke deelverzameling.
- Enhanced tables voegen de variantie-inflatiefactor (VIF) van elke voorspeller in elk model toe, om gecorreleerde voorspellers op te sporen.
- Model met of zonder intercept.
Statistische methoden
Rijen met een ontbrekende of niet-numerieke waarde in de respons of een geselecteerde voorspeller worden weggelaten. Voor elke omvang van de deelverzameling, van het minimum tot het maximum, fit de tool een model met gewone kleinste kwadraten voor elke combinatie van zoveel vrije voorspellers (plus eventuele afgedwongen voorspellers), sorteert ze op R-Sq en bewaart de beste modellen van elke omvang. Met p vrije voorspellers zijn er 2ᵖ − 1 deelverzamelingen, dus elke extra kandidaat verdubbelt het aantal fits.
Voor een model met k coëfficiënten (inclusief de constante) gefit op n rijen: S = √MSE; R-Sq(adj) corrigeert R-Sq voor het aantal termen; PRESS = Σ (eᵢ / (1 − hᵢ))², de som van gekwadrateerde leave-one-out-voorspelfouten met de hefboomwaarden hᵢ; R-Sq(pred) = 1 − PRESS / SS Total. Mallows' Cp = SSE / MSE(full) − (n − 2k), waarbij MSE(full) het foutgemiddelde kwadraat is van het model met alle voorspellers; een model met weinig bias heeft een Cp dicht bij k, en het volledige model heeft altijd Cp = k. AICc = −2 log L + 2(k+1) + 2(k+1)(k+2)/(n − k − 2) en BIC = −2 log L + (k+1) ln n, waarbij σ als parameter wordt meegeteld; kleiner is beter voor PRESS, AICc en BIC.
Zoek het model waarbij R-Sq(adj) en R-Sq(pred) niet meer stijgen, Cp dicht bij het aantal coëfficiënten ligt en S klein is. Een groot verschil tussen R-Sq en R-Sq(pred) waarschuwt voor overfitting. Best subsets vergelijkt alleen fits: controleer de residuen en coëfficiënten van het gekozen model in Regressiemodel fitten.
Invoervelden en opties
Veld | Beschrijving |
Response (Y) | Numerieke kolom die moet worden verklaard. Verplicht. |
Free predictors | Numerieke kandidaat-voorspellers; elke combinatie wordt geprobeerd. Verplicht. Ctrl of Command + klik om er meerdere te selecteren. |
Predictors in all models (optional) | Numerieke voorspellers die in elk model zijn opgenomen. Ze mogen niet ook vrije voorspellers zijn. |
Models of each size to display | Hoeveel van de beste modellen van elke omvang worden getoond, 1 tot 5. Standaard 2. |
Display PRESS / Display AICc / Display BIC | Voeg deze kolommen aan de tabel toe. Standaard uit. |
Free Predictors: Minimum / Maximum | Kleinste en grootste aantal vrije voorspellers in een model. Standaard 1 tot alle. |
Fit intercept | Standaard aangevinkt. Vink uit om modellen door de oorsprong te fitten (R-Sq is dan niet gecentreerd). |
Display of results | Simple tables (standaard) of Enhanced tables, die een VIF-kolom voor elke voorspeller toevoegen. |
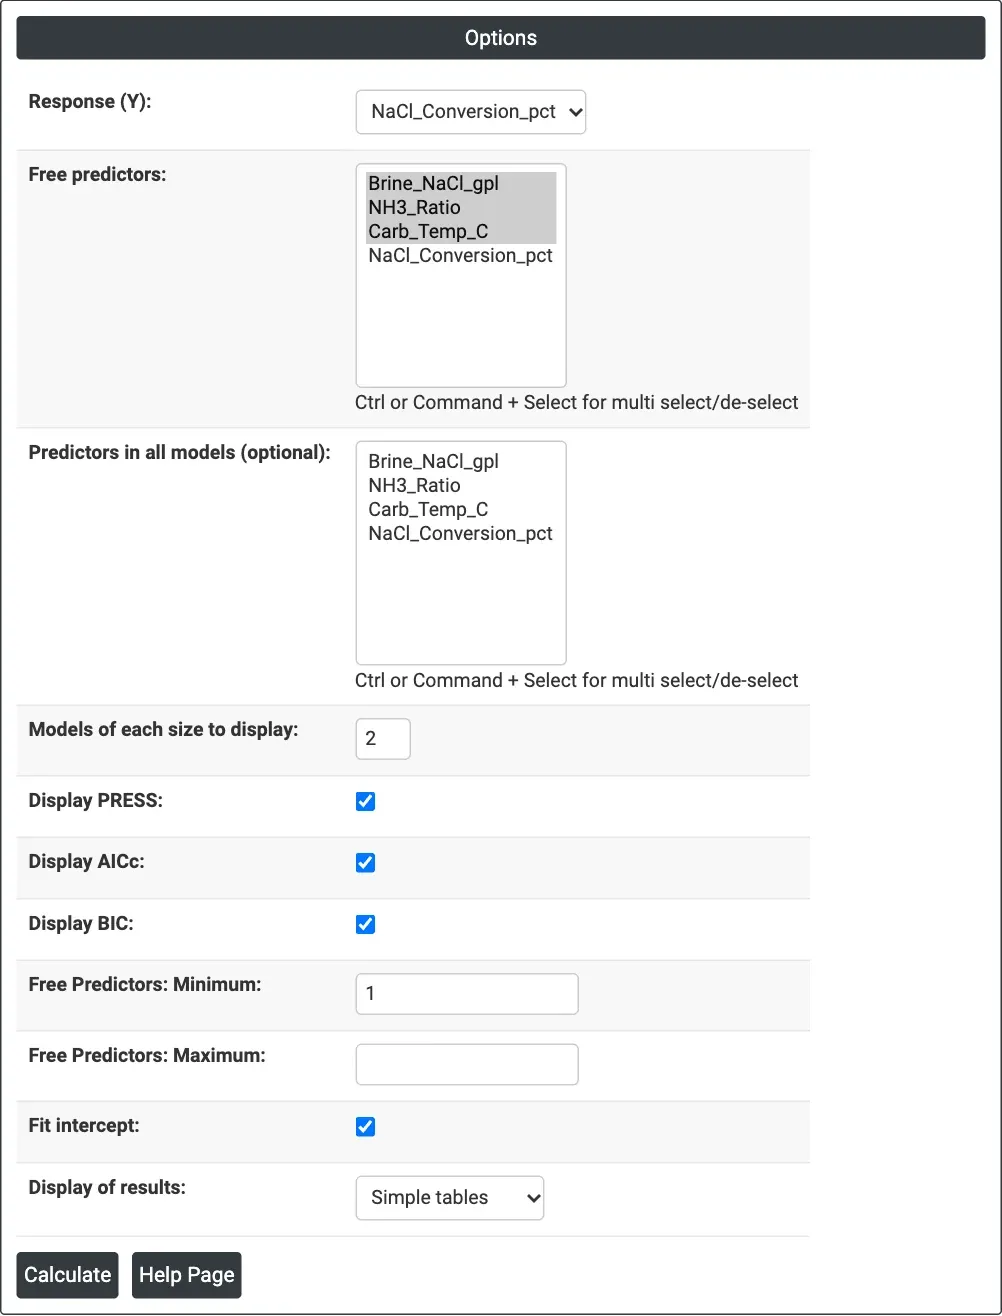
Figuur 1 — Opties voor het voorbeeld met soda-as: NaCl_Conversion_pct als respons, de drie procesinstellingen als vrije voorspellers, met PRESS, AICc en BIC getoond.
Beschrijving van de uitvoer
- Response line — noemt de respons en eventuele voorspellers die in alle modellen worden afgedwongen.
- Best Subsets Results table — één rij per model: Vars (aantal vrije voorspellers), R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp, S, optioneel PRESS, AICc en BIC, en een X onder elke voorspeller in het model; met Enhanced tables de VIF voor elke voorspeller in het model.
- PDF-export via Download.
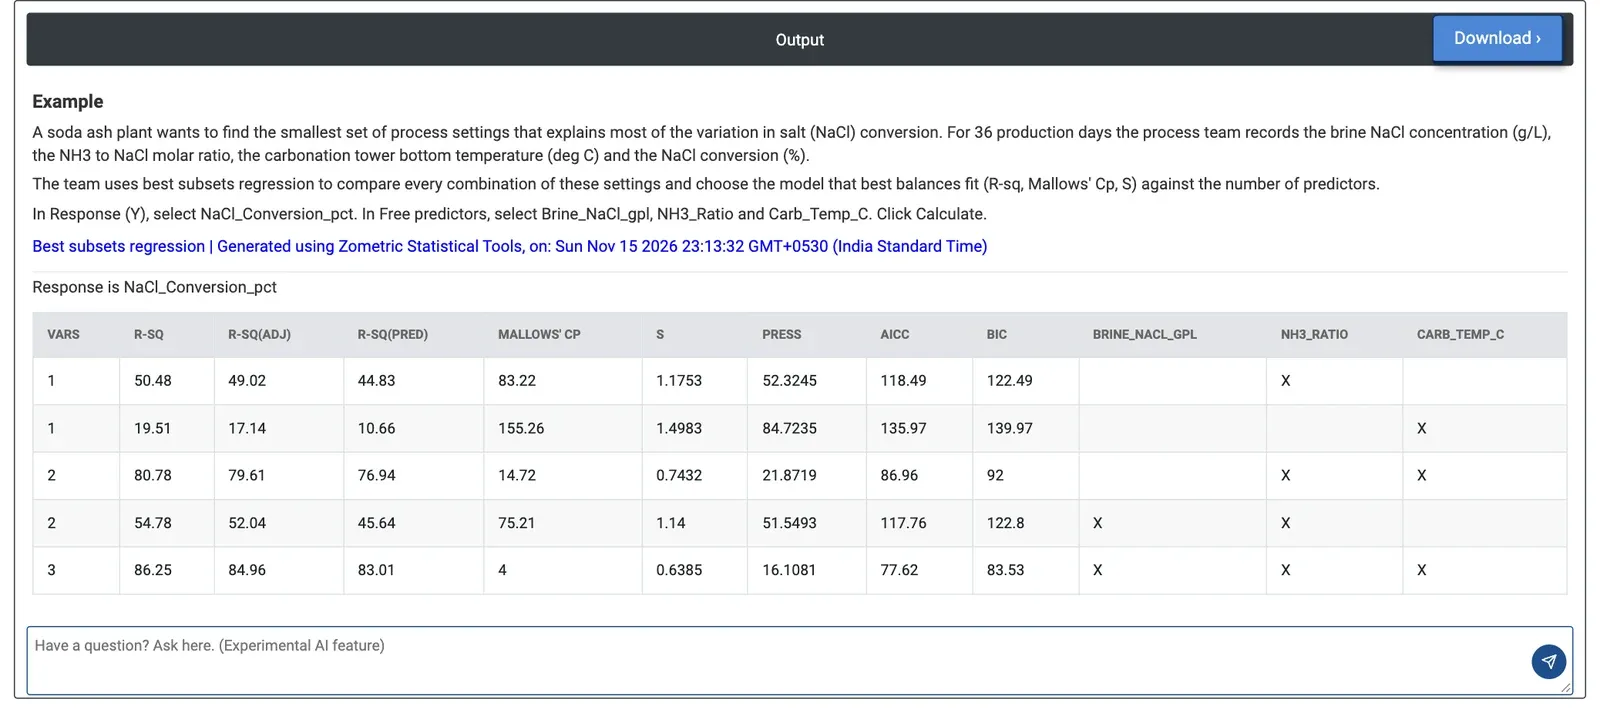
Figuur 2 — Best subsets-resultaten voor NaCl-conversie: het model met drie voorspellers heeft R-Sq 86.25%, R-Sq(pred) 83.01%, Cp 4 en S 0.6385.
Uitgewerkt voorbeeld
Een sodafabriek wil weten welke procesinstellingen de dagelijkse NaCl-conversie (%) verklaren. Over 36 productiedagen registreert het team de NaCl-concentratie van de pekel (Brine_NaCl_gpl), de molaire verhouding NH3 tot NaCl (NH3_Ratio) en de bodemtemperatuur van de carbonatatietoren (Carb_Temp_C). Ze selecteren NaCl_Conversion_pct als respons, de drie instellingen als vrije voorspellers, bewaren twee modellen van elke omvang en vinken Display PRESS, AICc en BIC aan.
Op zichzelf is de NH3-verhouding de beste enkele voorspeller, maar zij verklaart slechts 50.48% van de variatie (Cp 83.22). Door de carbonatatietemperatuur toe te voegen stijgt R-Sq naar 80.78% en daalt S van 1.1753 naar 0.7432 procentpunt, maar Cp is nog steeds 14.72, ruim boven de 3 coëfficiënten van dat model, dus er ontbreekt iets. Met alle drie de instellingen is R-Sq 86.25%, R-Sq(pred) 83.01%, S 0.6385 en zijn PRESS, AICc en BIC de laagste van de tabel (16.1081, 77.62 en 83.53). Het kleine verschil tussen R-Sq en R-Sq(pred) toont dat het model niet is overgefit.
Het team houdt alle drie de instellingen en fit ze met Regressiemodel fitten. Als u Enhanced tables aanvinkt, zijn de VIF's 1.01 tot 1.03, dus de drie instellingen zijn niet samen veranderd en elk effect kan afzonderlijk worden gelezen.
Veelgestelde vragen
Wat is best subsets-regressie?
Best subsets-regressie fit een lineaire regressie voor elke combinatie van de kandidaat-voorspellers en toont de beste modellen van elke omvang naast elkaar, gerangschikt op R-Sq. Zij wordt vroeg in een onderzoek gebruikt om de kleinste set voorspellers, zoals procesinstellingen, te vinden die het grootste deel van de variatie in de respons verklaart.
Hoe kiest u het beste model uit de best subsets-uitvoer?
Zoek het model waarbij R-Sq(adj) en R-Sq(pred) niet meer stijgen, Mallows' Cp dicht bij het aantal coëfficiënten ligt en S klein is. Kleinere PRESS, AICc en BIC zijn beter. Een groot verschil tussen R-Sq en R-Sq(pred) waarschuwt voor overfitting. Controleer daarna de residuen en coëfficiënten van het gekozen model in Regressiemodel fitten.
Wat betekent Mallows' Cp in best subsets-regressie?
Mallows' Cp vergelijkt de fout van een model met die van het volledige model met alle voorspellers. Een model met weinig bias heeft een Cp dicht bij k, het aantal coëfficiënten inclusief de constante, en het volledige model heeft altijd Cp gelijk aan k. Een Cp ruim boven k, zoals 14.72 voor een model met 3 coëfficiënten in het voorbeeld, wijst erop dat een belangrijke voorspeller ontbreekt.
Hoeveel modellen fit best subsets-regressie?
Met p vrije voorspellers zijn er 2 tot de macht p min 1 deelverzamelingen, dus elke extra kandidaat-voorspeller verdubbelt het aantal fits. U kunt het minimum en maximum aantal vrije voorspellers per model beperken, bekende voorspellers in elk model afdwingen en kiezen hoeveel van de beste modellen van elke omvang worden getoond, van 1 tot 5.