
Chi-kwadraat aanpassingstoets
Een chi-kwadraat aanpassingstoets bepaalt of de waargenomen frequentieverdeling van een categorische variabele overeenkomt met een bepaalde verwachte verdeling. De toets vergelijkt hoe vaak elke categorie daadwerkelijk in uw gegevens voorkomt met hoe vaak u elke categorie zou verwachten op basis van een theoretisch model of eerdere aanname.
Laatst beoordeeld
Belangrijkste conclusie
Een chi-kwadraat aanpassingstoets bepaalt of de waargenomen frequentieverdeling van een categorische variabele overeenkomt met een bepaalde verwachte verdeling.
Op deze pagina
- Wat is een chi-kwadraat aanpassingstoets?
- Wanneer gebruikt u een chi-kwadraat aanpassingstoets?
- Richtlijnen voor correct gebruik van de chi-kwadraat aanpassingstoets
- Alternatieven: wanneer u de chi-kwadraat aanpassingstoets niet gebruikt
- Voorbeeld van een chi-kwadraat aanpassingstoets
- Zo voert u een chi-kwadraat aanpassingstoets uit
Wat is een chi-kwadraat aanpassingstoets?
Een chi-kwadraat aanpassingstoets bepaalt of de waargenomen frequentieverdeling van een categorische variabele overeenkomt met een bepaalde verwachte verdeling. De toets vergelijkt hoe vaak elke categorie daadwerkelijk in uw gegevens voorkomt met hoe vaak u elke categorie zou verwachten op basis van een theoretisch model of eerdere aanname.
U kunt bijvoorbeeld toetsen of een productielijn in alle ploegen even vaak defecten oplevert, of of klachten van klanten over categorieën zijn verdeeld in de verhoudingen die uw model voorspelt.
Eenvoudige definitie: Een toets die controleert of de aantallen die u per categorie waarneemt overeenkomen met de aantallen die u verwachtte, en die zo aangeeft of uw gegevens passen bij het patroon dat u voorspelde.
Wanneer gebruikt u een chi-kwadraat aanpassingstoets?
- Gebruik de toets wanneer uw responsvariabele categorisch is en u wilt toetsen of de waargenomen verdeling overeenkomt met een verwachte of theoretische verdeling.
- Gebruik de toets om te controleren of een proces defecten of uitkomsten in de verwachte verhoudingen oplevert over categorieën zoals ploeg, machine of producttype.
- Gebruik de toets wanneer u een theoretisch model of eerdere verdeling hebt en wilt toetsen hoe goed uw werkelijke gegevens daarmee overeenkomen.
- Gebruik de toets bij steekproefaudits, nalevingscontroles en kwaliteitsreviews waarbij de verwachte frequenties bekend zijn uit specificaties of historische gegevens.
Richtlijnen voor correct gebruik van de chi-kwadraat aanpassingstoets
- Elke categorie moet een verwachte frequentie van minstens 5 hebben; categorieën met zeer kleine verwachte aantallen maken de toets onbetrouwbaar. Voeg zo nodig categorieën samen.
- Waarnemingen moeten onafhankelijk zijn: het aantal in de ene categorie mag het aantal in een andere niet beïnvloeden.
- De verwachte proporties of aantallen moeten worden vastgelegd voordat u de gegevens bekijkt ; het afleiden ervan uit dezelfde dataset die wordt getoetst is circulair en ongeldig.
- Een p-waarde onder 0.05 geeft aan dat de waargenomen verdeling significant afwijkt van de verwachte; onderzoek welke categorieën de grootste afwijkingen vertonen.
- Verzamel een voldoende grote totale steekproef zodat alle verwachte celfrequenties voldoen aan de ondergrens van 5.
Alternatieven: wanneer u de chi-kwadraat aanpassingstoets niet gebruikt
- Als u de relatie tussen twee categorische variabelentoetst, gebruik dan de Chi-kwadraattoets voor onafhankelijkheid
- Als de responsvariabele continuis, gebruik dan Normaliteitstoets of identificatie van individuele verdeling
- Als telgegevens een Poisson-proces volgen (zeldzame gebeurtenissen in de tijd of per oppervlak), gebruik dan Poisson-aanpassingstoets
Voorbeeld van een chi-kwadraat aanpassingstoets
Een inkoopmanager wil de verhouding van de verkochte t-shirts per maat vergelijken met de verhouding van de bestelde t-shirts. De manager telt het aantal t-shirts per maat dat in een week is verkocht. De inkoper voert een chi-kwadraat aanpassingstoets uit om te bepalen of de verhoudingen van de verkochte t-shirtmaten overeenkomen met de verhoudingen van de bestelde t-shirtmaten. De toets in de volgende stappen:
- De benodigde gegevens verzamelen.
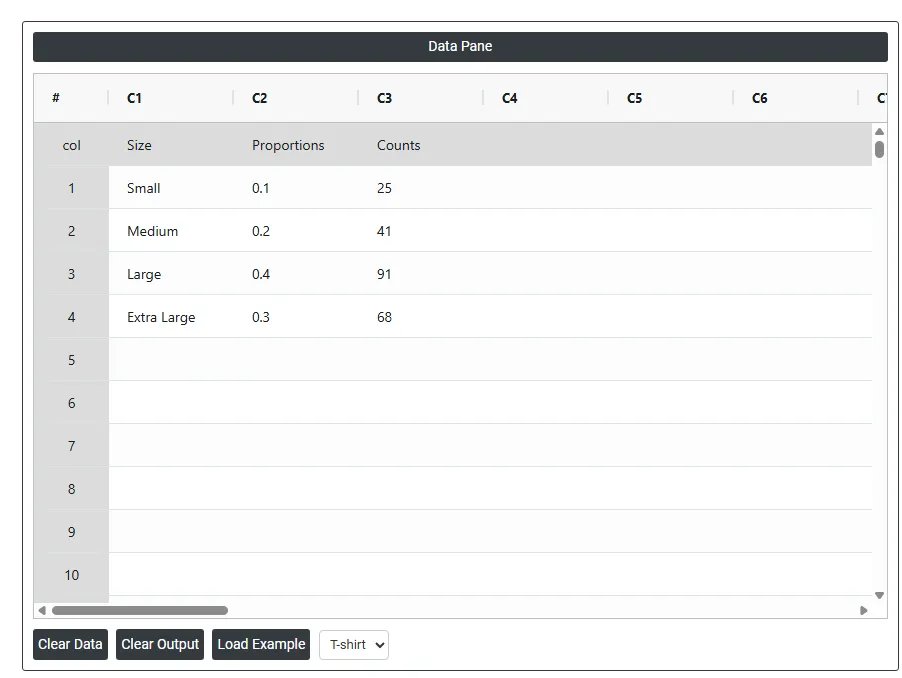
- Analyseer de gegevens nu in Zometric Statistical Software op https://statsai.zometric.com/.
- Om Chi Square Goodness Of Fit te vinden, kiest u Statistical module> Hypothesis Test> Chi Square Goodness Of Fit.
- Voer in de tool de gegevens samen met de overige invoer als volgt in:
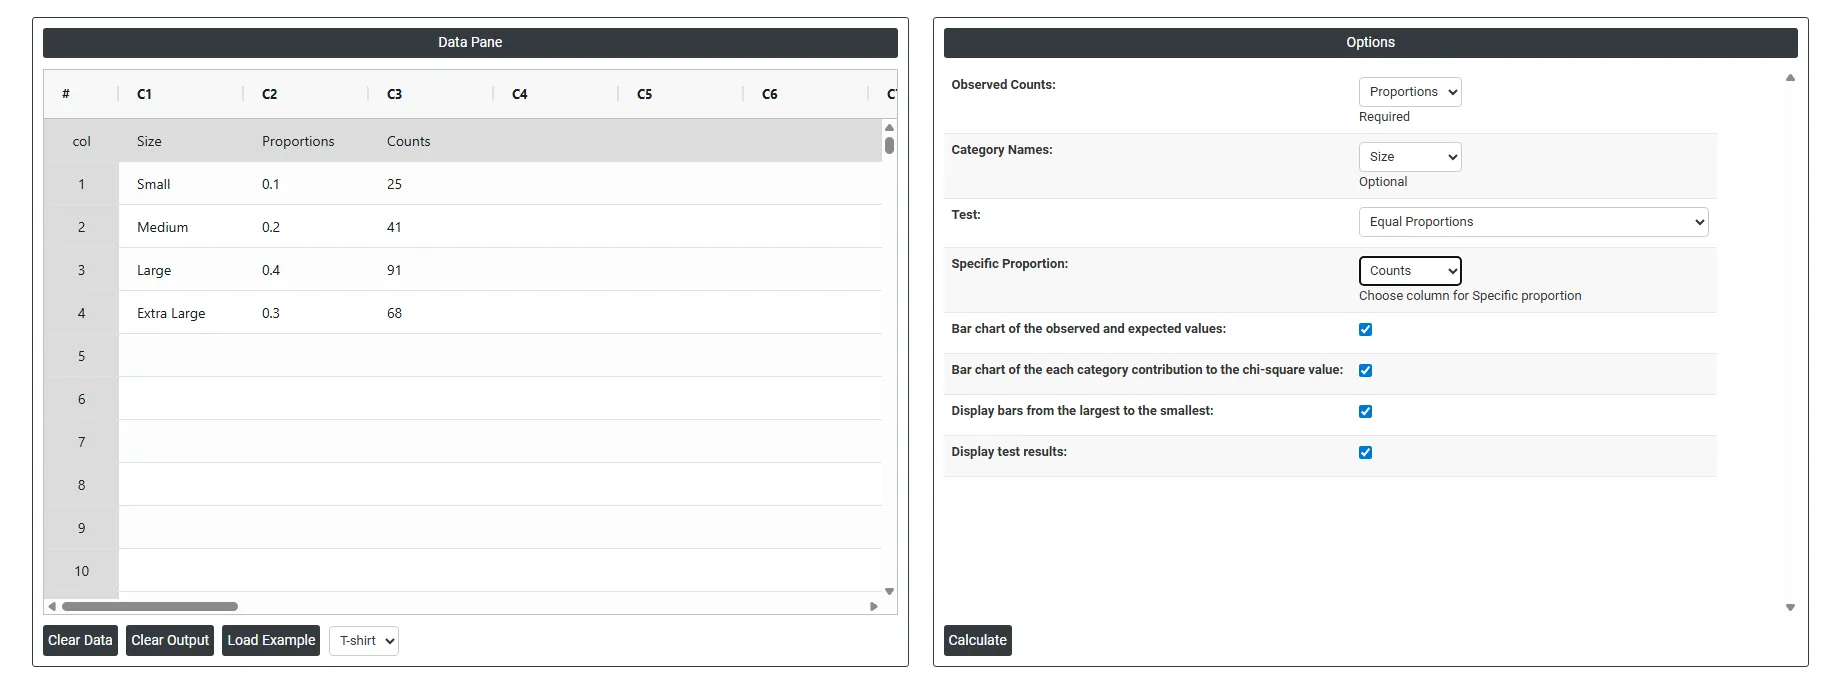
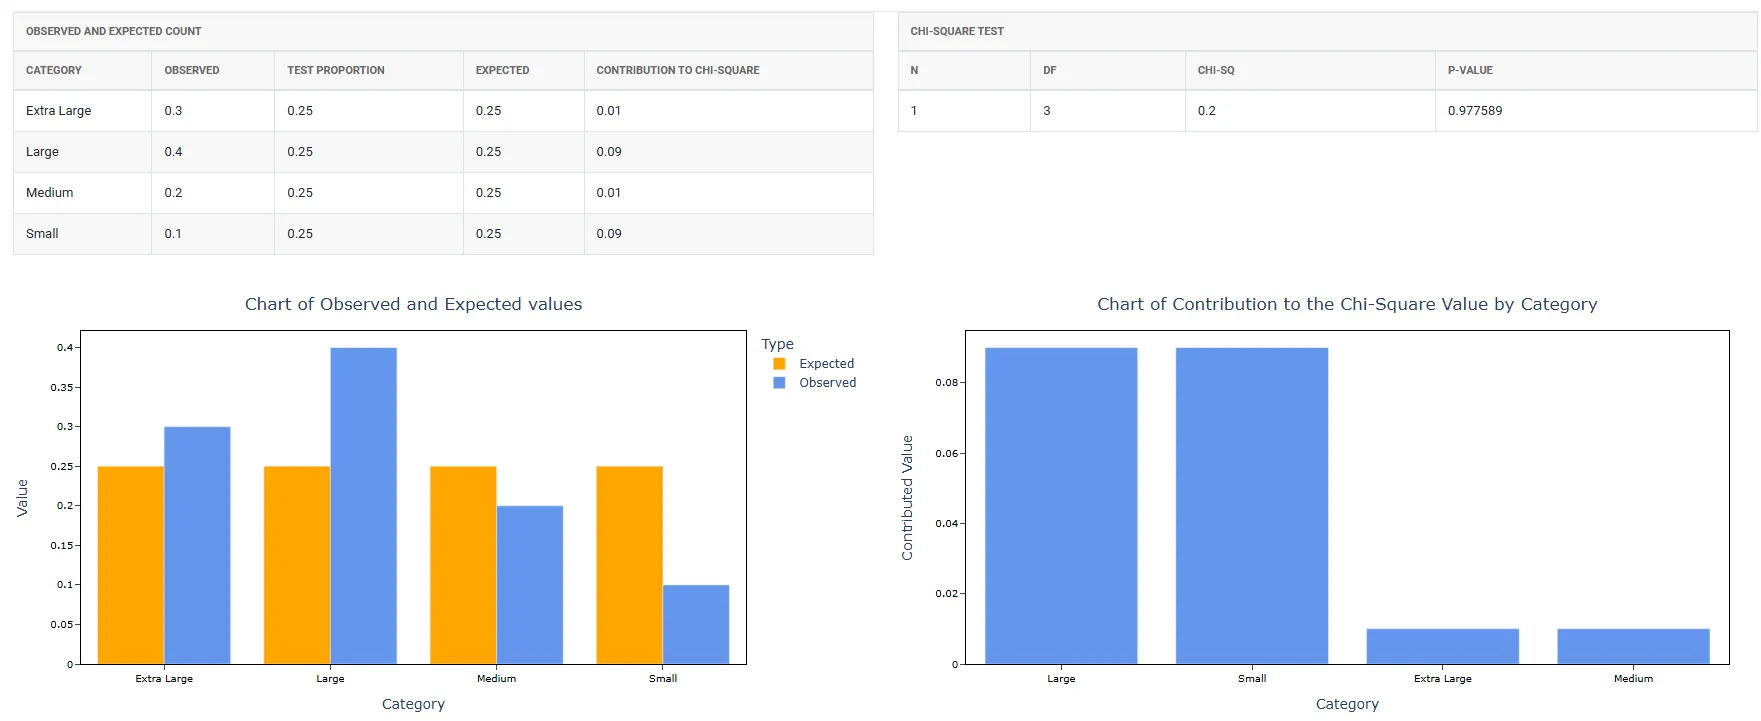
5. Na gebruik van bovenstaande tool haalt u de uitvoer als volgt op:
Zo voert u een chi-kwadraat aanpassingstoets uit
De handleiding is als volgt:
- Log in bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Hypothesis Test >Chi Square Goodness Of Fit .
- Werk vervolgens de gegevens handmatig bij, of kopieer de gegevens volledig (Ctrl+C) uit een Excel-blad en plak ze (Ctrl+V) hier.
- Vul de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
Op het dashboard van Chi Square Goodness Of Fit is het venster in twee delen verdeeld.
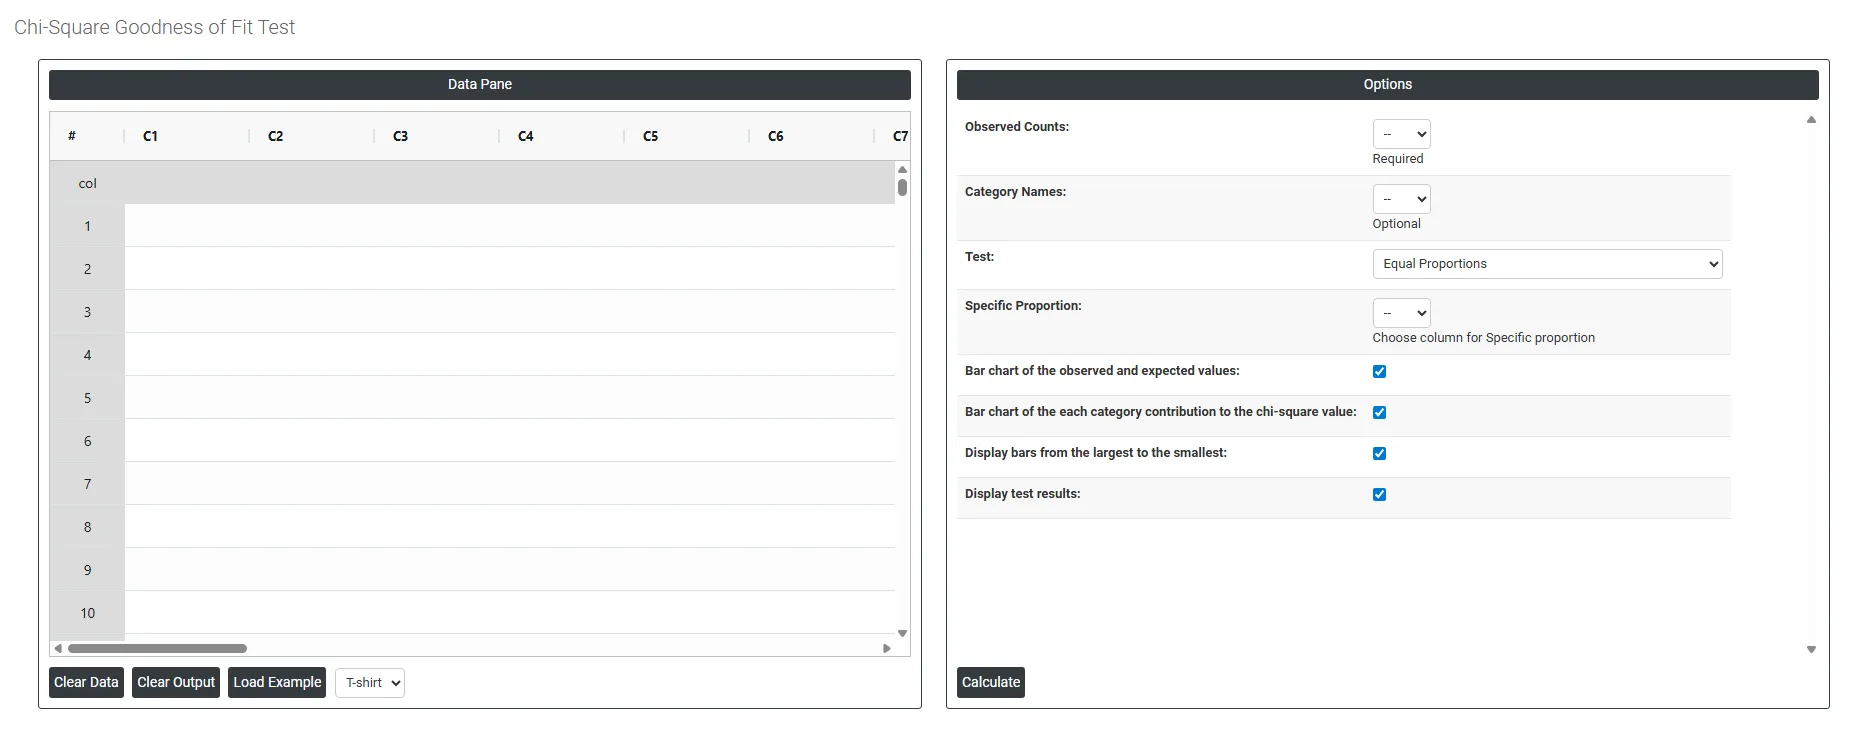
Links staat de Data Pane. In de Data Pane vormt elke rij één subgroep. U kunt de gegevens handmatig invoeren of volledig kopiëren (Ctrl+C) uit een Excel-blad en hier plakken (Ctrl+V).
Load example: Voorbeeldgegevens worden geladen.
Load File: Hiermee laadt u Excel-gegevens rechtstreeks.
Rechts staan veel opties, als volgt:
- Observed Counts Selecteer de kolom met de werkelijke aantallen die voor elke categorie in uw gegevens zijn vastgelegd, bijvoorbeeld het aantal waargenomen defecten per ploeg, het aantal klachten van klanten per categorie of het aantal gevallen in elke groep. Dit is de kerninvoer waarmee de toets vergelijkt wat er werkelijk is gebeurd met wat werd verwacht. Dit veld is verplicht.
- Category Names; Selecteer de kolom met de labels of namen van elke categorie, bijvoorbeeld Shift 1, Shift 2, Shift 3, of Scratch, Dent, Tear. Dit is optioneel maar aan te raden, omdat de grafieken en de resultatentabel dan duidelijk zijn gelabeld en gemakkelijker te interpreteren en in rapporten te presenteren zijn.
- Test: Bepaalt met welke verwachte verdeling de waargenomen aantallen worden vergeleken. Er zijn drie opties:
- Equal Proportions — toetst of alle categorieën even vaak voorkomen. Gebruik dit wanneer uw nulhypothese is dat elke categorie even vaak moet voorkomen, bijvoorbeeld om te toetsen of defecten gelijkmatig over alle dagen van de week zijn verdeeld.
- Specific Proportions — toetst of categorieën voorkomen in specifieke, vooraf bepaalde proporties die u handmatig invoert. Gebruik dit wanneer u een verwachte verdeling hebt op basis van theorie, historische gegevens of specificaties, bijvoorbeeld om te toetsen of 60% van de uitkomsten in Categorie A valt, 30% in Categorie B en 10% in Categorie C.
- Properties Specified by Historical Counts (Input Column) — toetst tegen verwachte proporties die zijn afgeleid van een referentiekolom met historische aantallen in plaats van handmatig ingevoerde waarden. Gebruik dit wanneer u een eerdere dataset of basisperiode hebt waarvan u de verdeling wilt vergelijken met uw huidige gegevens.
- Specific Proportion: Selecteer de kolom met de verwachte proporties of referentieaantallen van elke categorie wanneer u de testoptie Specific Proportions of Historical Counts gebruikt. De waarden in deze kolom bepalen hoe de verdeling er onder de nulhypothese uit moet zien; de verwachte proportie van elke categorie moet in dezelfde volgorde overeenkomen met de categorieën in de kolom Observed Counts.
- Bar Chart of Observed and Expected Values: Indien ingeschakeld, toont dit een staafdiagram waarin de waargenomen aantallen naast de verwachte aantallen voor elke categorie worden vergeleken. Dit is een van de nuttigste visuele uitvoeren: het maakt direct duidelijk welke categorieën het grootste verschil tussen waargenomen en verwacht vertonen, zodat u kunt aanwijzen waar de verdeling het meest afwijkt.
- Bar Chart of Each Category Contribution to the Chi-Square Value: Indien ingeschakeld, toont dit een staafdiagram met hoeveel elke afzonderlijke categorie bijdraagt aan de totale chi-kwadraatstatistiek. Categorieën met de hoogste staven zijn degene die het significante resultaat veroorzaken; zo ziet u precies welke categorieën het meest verantwoordelijk zijn voor de afwijking van de verwachte verdeling, in plaats van alleen te weten dat er in het geheel een verschil bestaat.
- Display Bars from Largest to Smallest: Indien ingeschakeld, sorteert dit de staven in de grafieken in aflopende volgorde van de grootste bijdrage of het grootste aantal naar de kleinste. Zo kunt u gemakkelijker bepalen welke categorieën het belangrijkst zijn en eerst de grootste afwijkingen aanpakken; vooral handig bij veel categorieën wanneer u snel de meest significante wilt vinden.
- Display Test Results: Indien ingeschakeld, toont dit de volledige statistische testuitvoer direct op of naast de grafiek, inclusief de chi-kwadraatstatistiek, vrijheidsgraden en p-waarde. Zo ziet u de visuele en statistische resultaten bij elkaar zonder een aparte uitvoertabel te hoeven raadplegen.
Veelgestelde vragen
Wat zegt een chi-kwadraat aanpassingstoets u?
De toets zegt of de waargenomen frequentieverdeling van een categorische variabele overeenkomt met een bepaalde verwachte verdeling, door te vergelijken hoe vaak elke categorie daadwerkelijk voorkomt met hoe vaak zij volgens een theoretisch model of eerdere aanname zou moeten voorkomen. Een p-waarde onder 0.05 duidt op een significant verschil; onderzoek dan welke categorieën de grootste afwijkingen vertonen.
Wat zijn de aannames van de chi-kwadraat aanpassingstoets?
Elke categorie moet een verwachte frequentie van minstens 5 hebben; voeg zo nodig categorieën samen en verzamel een voldoende grote totale steekproef. Waarnemingen moeten onafhankelijk zijn, zodat het aantal in de ene categorie een andere niet beïnvloedt. De verwachte proporties moeten worden vastgelegd voordat u de gegevens bekijkt, omdat het afleiden ervan uit dezelfde dataset circulair en ongeldig is.
Tegen welke verwachte verdelingen kunt u toetsen?
In Zometric Statistical Software biedt de optie Test drie keuzes: Equal Proportions, waarbij elke categorie even vaak moet voorkomen; Specific Proportions, handmatig ingevoerd op basis van theorie, historische gegevens of specificaties; en proporties gespecificeerd door historische aantallen in een referentiekolom, om huidige gegevens te vergelijken met een eerdere dataset of basisperiode.
Wanneer gebruikt u in plaats daarvan de chi-kwadraattoets voor onafhankelijkheid?
Gebruik de aanpassingstoets voor één categorische variabele die met een verwachte verdeling wordt vergeleken. Om de relatie tussen twee categorische variabelen te toetsen, gebruikt u de chi-kwadraattoets voor onafhankelijkheid. Is de respons continu, gebruik dan een normaliteitstoets of identificatie van individuele verdeling, en volgen de aantallen een Poisson-proces, gebruik dan de Poisson-aanpassingstoets.