
Chi-kwadraattoets voor onafhankelijkheid (kruistabel)
De chi-kwadraattoets voor onafhankelijkheid toetst of twee categorische variabelen samenhangen, uitgaande van een samengevatte tweewegtabel met aantallen of ruwe records. Hij vergelijkt waargenomen aantallen met de aantallen die bij onafhankelijkheid worden verwacht, met Pearson- en likelihood-ratio-chi-kwadraat op (r − 1)(c − 1) vrijheidsgraden. Bijdragen en aangepaste residuen tonen welke cellen het resultaat bepalen. De verwachte aantallen mogen niet te klein zijn.
Laatst beoordeeld
Belangrijkste conclusie
De chi-kwadraattoets voor onafhankelijkheid onderzoekt of twee categorische variabelen samenhangen, bijvoorbeeld of de verdeling van defecttypen afhangt van ploeg, leverancier of lijn, en toont welke cellen de samenhang bepalen.
Op deze pagina
Doel
De chi-kwadraattoets voor onafhankelijkheid (Chi-Square Test of Independence) onderzoekt of twee categorische variabelen samenhangen, bijvoorbeeld of de verdeling van defecttypen afhangt van de ploeg, de leverancier of de lijn. Voer een tabel in met aantallen die u al hebt samengevat, of de ruwe records met één rij per eenheid, en de tool toetst de samenhang en toont welke cellen die bepalen.
Belangrijkste mogelijkheden
- Samengevatte tweewegtabel (één kolom per kolomcategorie, één rij per rijcategorie) of ruwe categorische gegevens met optionele frequenties.
- Chi-kwadraattoetsen van Pearson en likelihood-ratio.
- Optionele tabellen met verwachte aantallen, bijdragen aan chi-kwadraat, ruwe, gestandaardiseerde en aangepaste residuen, en rij-, kolom- en totaalpercentages.
- Optionele begeleide interpretatie: samenvattend rapport met percentageprofielen en grafieken van het %-verschil, diagnostisch rapport en rapportkaart.
- Data Options: selecteer vóór de analyse een deel van de rijen.
Statistische methoden
Voor een r × c-tabel met waargenomen aantallen O, rijtotalen Rᵢ, kolomtotalen Cⱼ en eindtotaal N is het bij onafhankelijkheid verwachte aantal Eᵢⱼ = Rᵢ·Cⱼ / N. De toetsingsgrootheid van Pearson is χ² = Σ (O − E)² / E en de likelihood-ratio-toetsingsgrootheid is G² = 2 Σ O·ln(O / E). Beide worden vergeleken met een chi-kwadraatverdeling met (r − 1)(c − 1) vrijheidsgraden. Een kleine p-waarde betekent dat de rij- en kolomvariabelen samenhangen: de verdeling over de kolommen is niet in elke rij hetzelfde.
De bijdrage van elke cel (O − E)² / E laat zien waar de samenhang vandaan komt. Het ruwe residu is O − E, het gestandaardiseerde residu (O − E) / √E en het aangepaste residu (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)), dat bij benadering standaardnormaal is: waarden voorbij ongeveer ±2 markeren cellen die duidelijk afwijken van onafhankelijkheid. Bij ruwe gegevens maakt de tool eerst een kruistabel van de twee kolommen, waarbij de frequentiekolom wordt opgeteld als die is opgegeven; lege cellen blijven buiten beschouwing. Een rij of kolom met totaal nul moet worden verwijderd. De p-waarde is betrouwbaar wanneer de verwachte aantallen niet te klein zijn; de begeleide interpretatie controleert dit.
Invoervelden en opties
Veld | Beschrijving |
Data | Summarized data in a two-way table (standaard) of Raw data (categorische variabelen). |
Columns (one per column-category) | Tabelindeling: twee of meer numerieke kolommen, elk met de aantallen voor één categorie van de kolomvariabele, met één rij per rijcategorie. Vereist. |
Row labels | Tabelindeling, optioneel: een kolom die elke rijcategorie een naam geeft; leeg geeft Row 1, Row 2, … |
Rows / Columns / Frequencies (optional) | Ruwe indeling: de twee categorische kolommen en een optionele kolom met aantallen voor elk record. |
Statistics | Expected cell counts en Each cell's contribution to chi-square (standaard aangevinkt); Raw residuals, Standardized residuals, Adjusted residuals, Row percents, Column percents, Total percents. |
Data Options: Subset (optional) | Sluit overeenkomende rijen uit (standaard) of neem alleen overeenkomende rijen op, op basis van rijnummers en/of een voorwaarde. |
Show guided interpretation | Voegt een Summary, Diagnostic en Report Card in gewone taal toe; Difference between the % defectives with practical value is daarvoor een optionele invoer. |
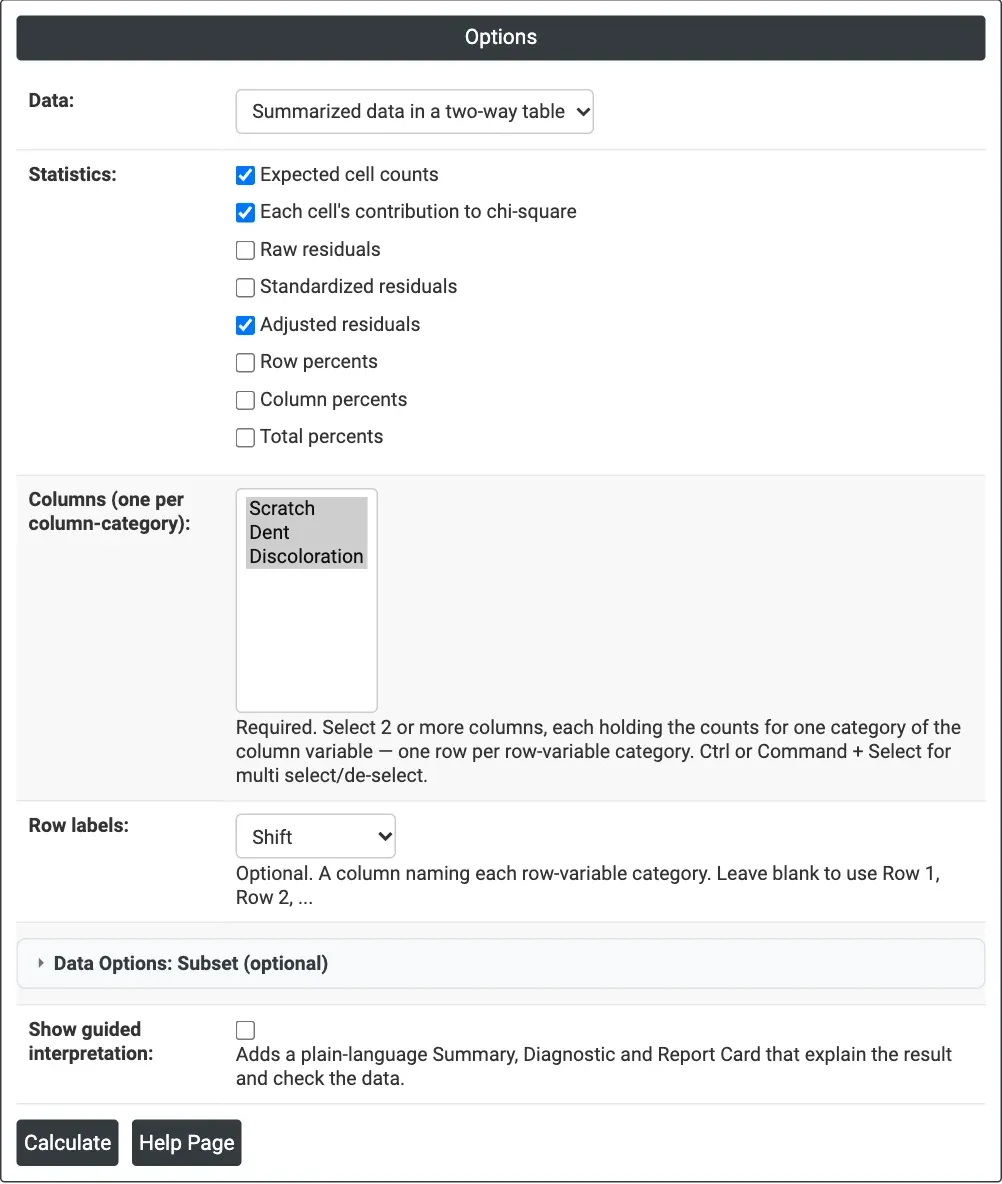
Figuur 1 — Opties voor het voorbeeld met defecttypen: een samengevatte tabel met de aantallen Scratch, Dent en Discoloration als kolommen en Shift als rijlabels, aangepaste residuen aangevinkt.
Beschrijving van de uitvoer
- Observed Counts — de tabel met rij- en kolomtotalen (All).
- Expected Counts en Contribution to Chi-Square — wanneer aangevinkt.
- Chi-Square Tests — Chi-Sq, DF en P-Value van de toetsen van Pearson en likelihood-ratio.
- Raw Residuals, Standardized Residuals, Adjusted Residuals, Row Percents, Column Percents en Total Percents — wanneer aangevinkt.
- Summary Report, Diagnostic Report en Report Card — met begeleide interpretatie.
- PDF-export via Download.
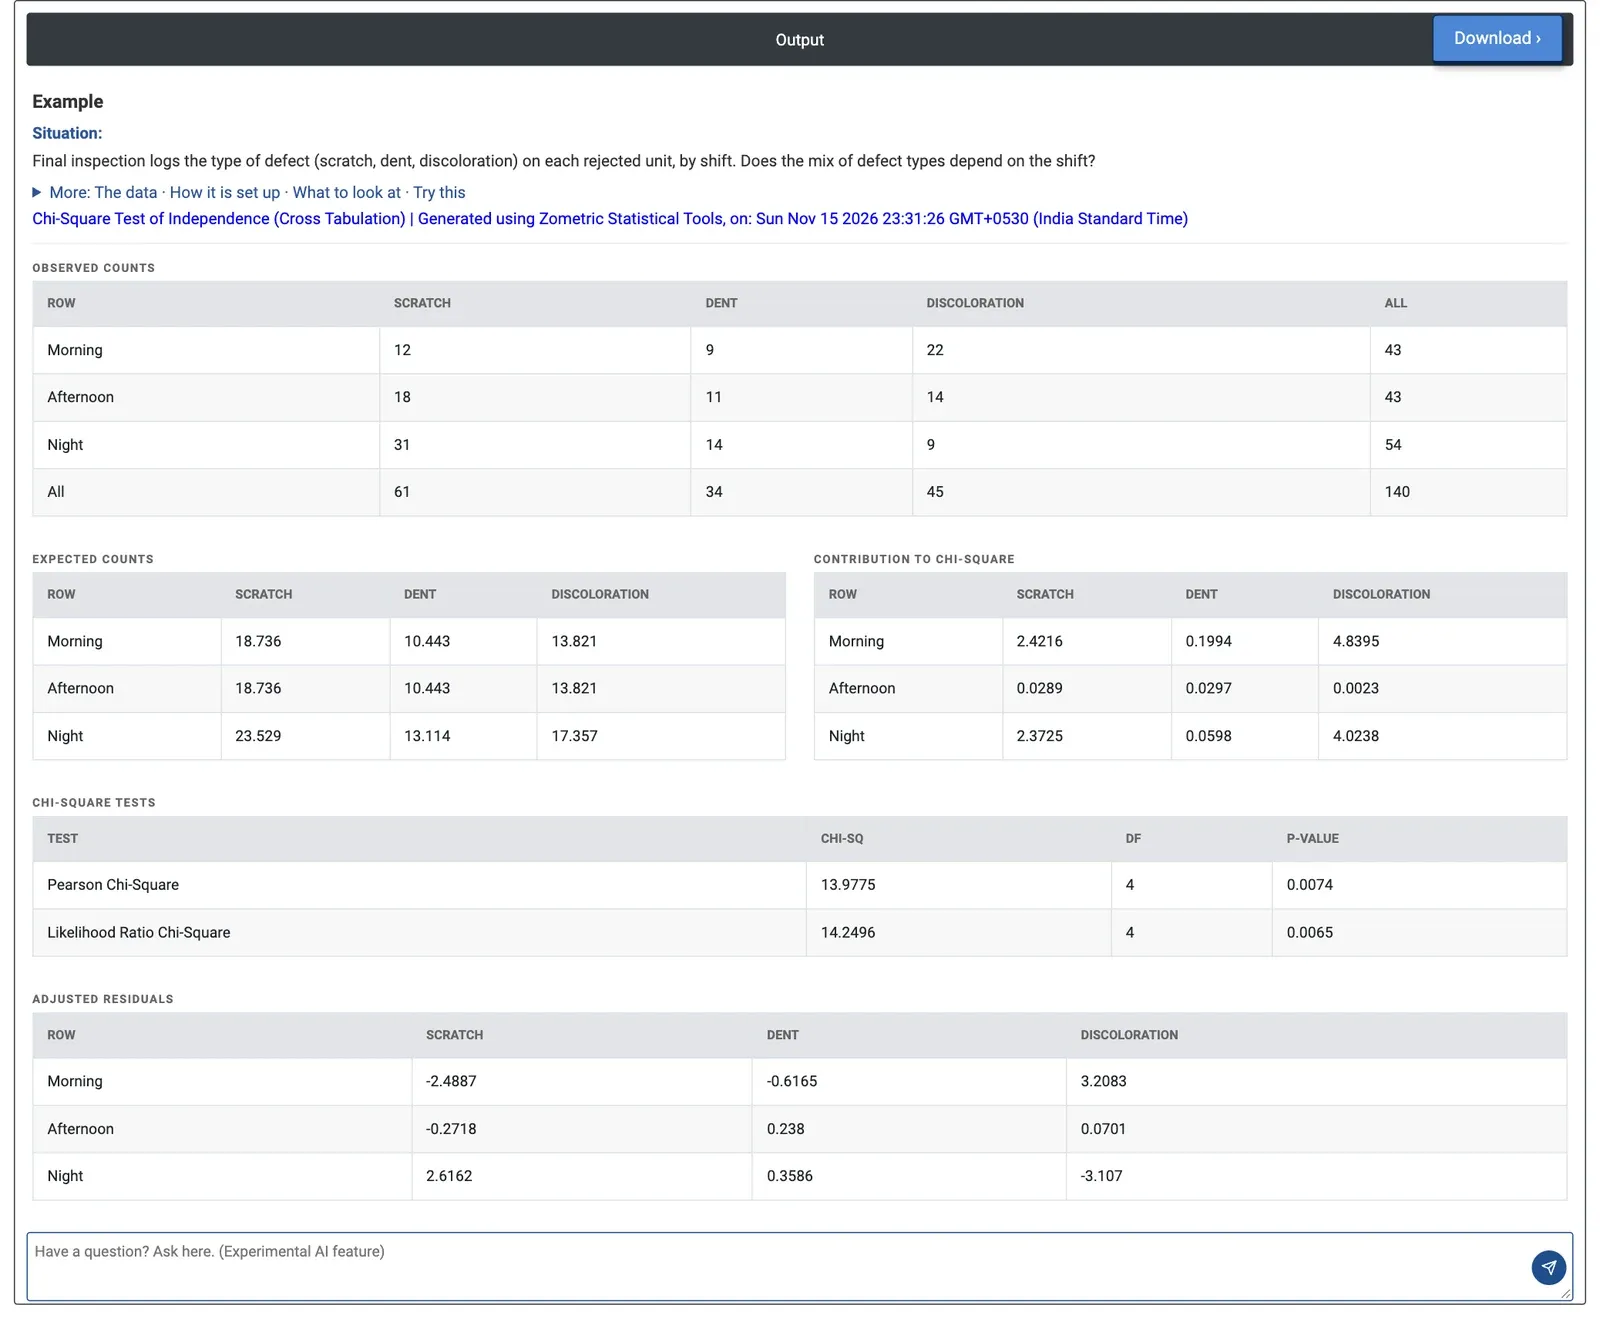
Figuur 2 — Defecttype per ploeg: chi-kwadraat van Pearson 13.98 met 4 DF, p = 0.0074; de aangepaste residuen wijzen op verkleuring bij de ochtendploeg en krassen bij de nachtploeg.
Uitgewerkt voorbeeld
De eindkeuring registreert het type defect van elke afgekeurde eenheid, per ploeg: in totaal 140 afgekeurde eenheden. Het kwaliteitsteam wil weten of de verdeling van defecttypen afhangt van de ploeg. Het voert de aantallen in als tabel met één kolom per defecttype (Scratch, Dent, Discoloration) en Shift als rijlabels, en vinkt Adjusted residuals aan naast de standaardstatistieken.
De verdeling van defecttypen hangt inderdaad af van de ploeg: chi-kwadraat van Pearson 13.98 op 4 DF, p = 0.0074 (likelihood-ratio 14.25, p = 0.0065). De bijdragen laten zien waar: verkleuring bij de ochtendploeg (4.84; 22 waargenomen tegen 13.8 verwacht) en bij de nachtploeg (4.02; 9 tegen 17.4), daarna krassen bij de ochtend- (2.42; 12 tegen 18.7) en nachtploeg (2.37; 31 tegen 23.5). De middagploeg komt overeen met de totale verdeling en de deuken zijn gelijkmatig verdeeld.
De aangepaste residuen bevestigen dit: 3.21 voor verkleuring in de ochtend en 2.62 voor krassen in de nacht liggen ruim voorbij 2. Het team onderzoekt wat er aan het begin van de dag verandert (bijvoorbeeld opwarmen of een andere verfbatch) voor verkleuring, en de hantering en verlichting bij de nachtploeg voor krassen. Alle verwachte aantallen liggen boven 10, dus de p-waarde is betrouwbaar.
Veelgestelde vragen
Hoe wordt het verwachte aantal berekend in een chi-kwadraattoets voor onafhankelijkheid?
Bij onafhankelijkheid is het verwachte aantal voor een cel het rijtotaal maal het kolomtotaal gedeeld door het eindtotaal, E = R x C / N. De toetsingsgrootheid van Pearson sommeert (O − E)² / E over alle cellen en wordt vergeleken met een chi-kwadraatverdeling met (r − 1)(c − 1) vrijheidsgraden, waarbij r en c het aantal rijen en kolommen zijn.
Hoe interpreteert u een chi-kwadraattoets voor onafhankelijkheid?
Een kleine p-waarde betekent dat de rij- en kolomvariabelen samenhangen: de verdeling over de kolommen is niet in elke rij hetzelfde. Om te zien waar de samenhang vandaan komt, kijkt u naar de bijdrage (O − E)² / E van elke cel en naar de aangepaste residuen, die bij benadering standaardnormaal zijn; waarden voorbij ongeveer ±2 markeren cellen die duidelijk afwijken van onafhankelijkheid.
Welk gegevensformaat heeft de toets nodig?
In Zometric Statistical Software kunt u een samengevatte tweewegtabel invoeren, met één numerieke kolom per kolomcategorie en één rij per rijcategorie, of ruwe gegevens met twee categorische kolommen en een optionele frequentiekolom. Bij ruwe gegevens maakt de tool eerst een kruistabel van de twee kolommen. Een rij of kolom met totaal nul moet worden verwijderd.
Wanneer is de p-waarde van de chi-kwadraattoets betrouwbaar?
De p-waarde is betrouwbaar wanneer de verwachte aantallen niet te klein zijn; de optionele begeleide interpretatie controleert dit. In het uitgewerkte voorbeeld van defecttype per ploeg lagen alle verwachte aantallen boven 10, dus de p-waarde van Pearson van 0.0074 op 4 vrijheidsgraden was betrouwbaar.