
K-means-clustering (Cluster K-Means)
Cluster K-Means groepeert waarnemingen op twee of meer numerieke variabelen in K door u gekozen clusters, met de methode van Lloyd, k-means++-startcentra en meerdere willekeurige starts. Standaardiseer variabelen die in verschillende eenheden zijn gemeten. Gebruik het wanneer u een bekend aantal groepen verwacht. De uitvoer bevat de uiteindelijke indeling, de clustercentroïden, het cluster en de afstand van elke waarneming en het percentage verklaarde variatie.
Laatst beoordeeld
Belangrijkste conclusie
Cluster K-Means verdeelt waarnemingen in een vast aantal groepen (K), zodat de waarnemingen in elke groep op de gekozen variabelen zoveel mogelijk op elkaar lijken, bijvoorbeeld om partijen, onderdelen of leveranciers in typen in te delen.
Op deze pagina
Doel
Cluster K-Means verdeelt waarnemingen in een vast aantal groepen (K), zodat de waarnemingen in elke groep op de door u gekozen variabelen zoveel mogelijk op elkaar lijken. Gebruik het wanneer u een bekend aantal groepen verwacht, bijvoorbeeld om materiaalpartijen, onderdelen of leveranciers op basis van meerdere gemeten eigenschappen in typen in te delen, of om te controleren of een label dat u al gebruikt (kwaliteitsklasse, lijn, ploeg) wel in de metingen terug te zien is.
Belangrijkste mogelijkheden
- Groepeert waarnemingen op twee of meer numerieke variabelen in K clusters die u zelf instelt.
- Optionele standaardisatie, zodat een variabele die in grote eenheden is gemeten de indeling niet domineert.
- Meerdere willekeurige startpunten; de beste oplossing (kleinste spreiding binnen de clusters) wordt bewaard, en dezelfde gegevens geven altijd hetzelfde resultaat.
- Rapporteert de uiteindelijke indeling (omvang, kwadratensom binnen het cluster, gemiddelde en maximale afstand tot de centroïde), de centroïde van elk cluster in de oorspronkelijke eenheden, het cluster van elke waarneming en het percentage van de totale variatie dat door de clusters wordt verklaard.
- Spreidingsdiagram van de eerste twee gekozen variabelen, gekleurd per cluster.
Statistische methoden
Rijen met een ontbrekende of niet-numerieke waarde in een van de gekozen variabelen worden weggelaten. Wanneer Standardize variables is aangevinkt, wordt elke variabele omgezet naar z = (x − gemiddelde) / s, met de steekproefstandaardafwijking s, zodat elke variabele vóór het clusteren gemiddelde 0 en standaardafwijking 1 heeft.
Het K-means-algoritme (methode van Lloyd) wijst elke waarneming toe aan het dichtstbijzijnde clustercentrum volgens de Euclidische afstand, berekent elk centrum opnieuw als het gemiddelde van zijn leden en herhaalt dit tot de toewijzingen niet meer veranderen. De startcentra worden gekozen met de k-means++-regel. Omdat het resultaat van de start kan afhangen, wordt het algoritme zo vaak uitgevoerd als Number of random starts en wordt de run met de kleinste kwadratensom binnen de clusters bewaard. Er wordt een vaste random seed gebruikt, dus resultaten zijn exact herhaalbaar.
Het percentage variatie dat door de clusters wordt verklaard is (totale SS − SS binnen clusters) / totale SS × 100, waarbij de totale SS de som van de gekwadrateerde afstanden van alle waarnemingen tot het totaalgemiddelde is en de SS binnen clusters de som van de gekwadrateerde afstanden van elke waarneming tot het eigen clustercentrum. Beide worden gemeten op de gegevens zoals geclusterd (gestandaardiseerd als die optie is aangevinkt). Een hoger getal betekent duidelijker gescheiden, compactere groepen, maar het stijgt altijd naarmate K groeit, dus vergelijk het met zorg tussen verschillende K. Centroïden worden voor de rapportage terugberekend naar de oorspronkelijke eenheden. De uiteindelijke indeling geeft per cluster het aantal waarnemingen, de kwadratensom binnen het cluster en de gemiddelde en maximale afstand van de leden tot de centroïde; deze afstanden, en de afstand van elke waarneming in de lidmaatschapstabel, zijn Euclidische afstanden in de geclusterde eenheden (gestandaardiseerd als die optie is aangevinkt), zoals in Minitab.
Invoervelden en opties
Veld | Beschrijving |
Variables | Twee of meer numerieke kolommen om op te clusteren. Ctrl of Command + klik om er meerdere te selecteren. |
Number of clusters (K) | Hoeveel groepen u wilt vormen. Standaard 3; minimaal 2. U hebt minimaal K volledige waarnemingen nodig. |
Standardize variables | Standaard aangevinkt. Brengt elke variabele vóór het clusteren op dezelfde schaal (gemiddelde 0, standaardafwijking 1). Vink het alleen uit wanneer alle variabelen dezelfde eenheden hebben en u variabelen met een grotere spreiding zwaarder wilt laten wegen. |
Number of random starts | Hoeveel startpunten er worden geprobeerd; het beste resultaat wordt bewaard. Standaard 10, 1 tot 100. |
Title | Titel die in de plot en de uitvoer wordt getoond. Standaard Cluster K-Means. |
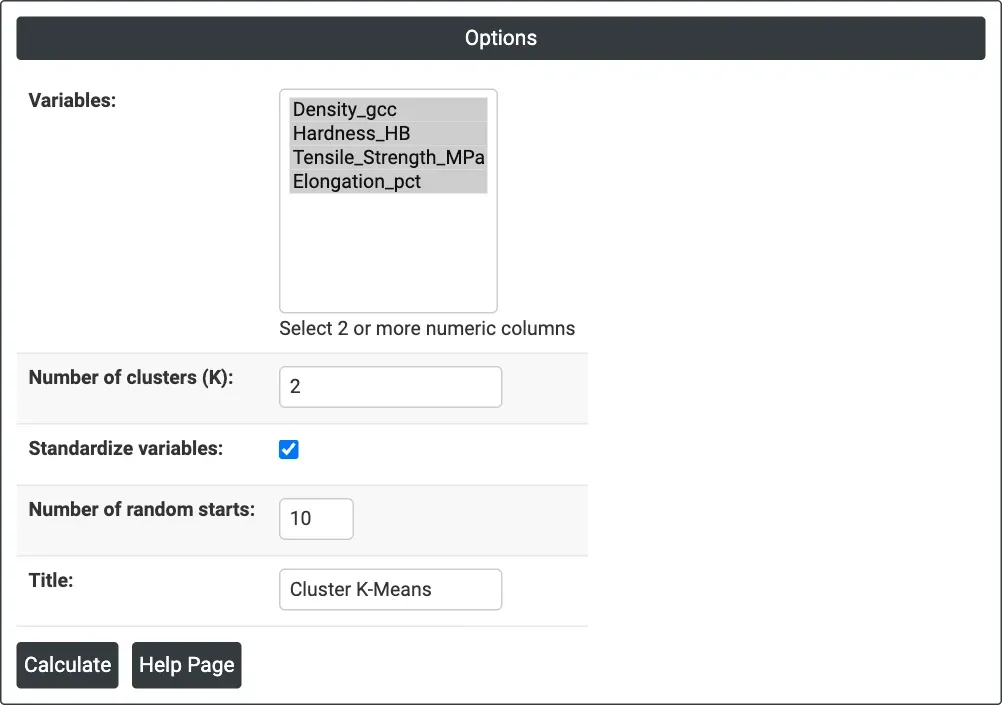
Figuur 1 — Opties voor het voorbeeld: de vier eigenschapkolommen, K = 2, gestandaardiseerd, 10 willekeurige starts.
Beschrijving van de uitvoer
- Cluster K-Means plot — spreidingsdiagram van de eerste gekozen variabele (x) tegen de tweede (y), met elk punt gekleurd naar zijn cluster.
- % variation explained by clusters — het aandeel van de totale variatie dat tussen de clusters ligt in plaats van binnen de clusters.
- Final Partition — per cluster: Number of observations, Within cluster sum of squares, Average distance from centroid en Maximum distance from centroid.
- Cluster Centroids — per cluster het aantal waarnemingen N en het gemiddelde van elke variabele in de oorspronkelijke eenheden.
- Cluster Membership — elke waarneming (naar werkbladrij), haar cluster en haar afstand tot de centroïde van dat cluster.
- PDF-export via Download.
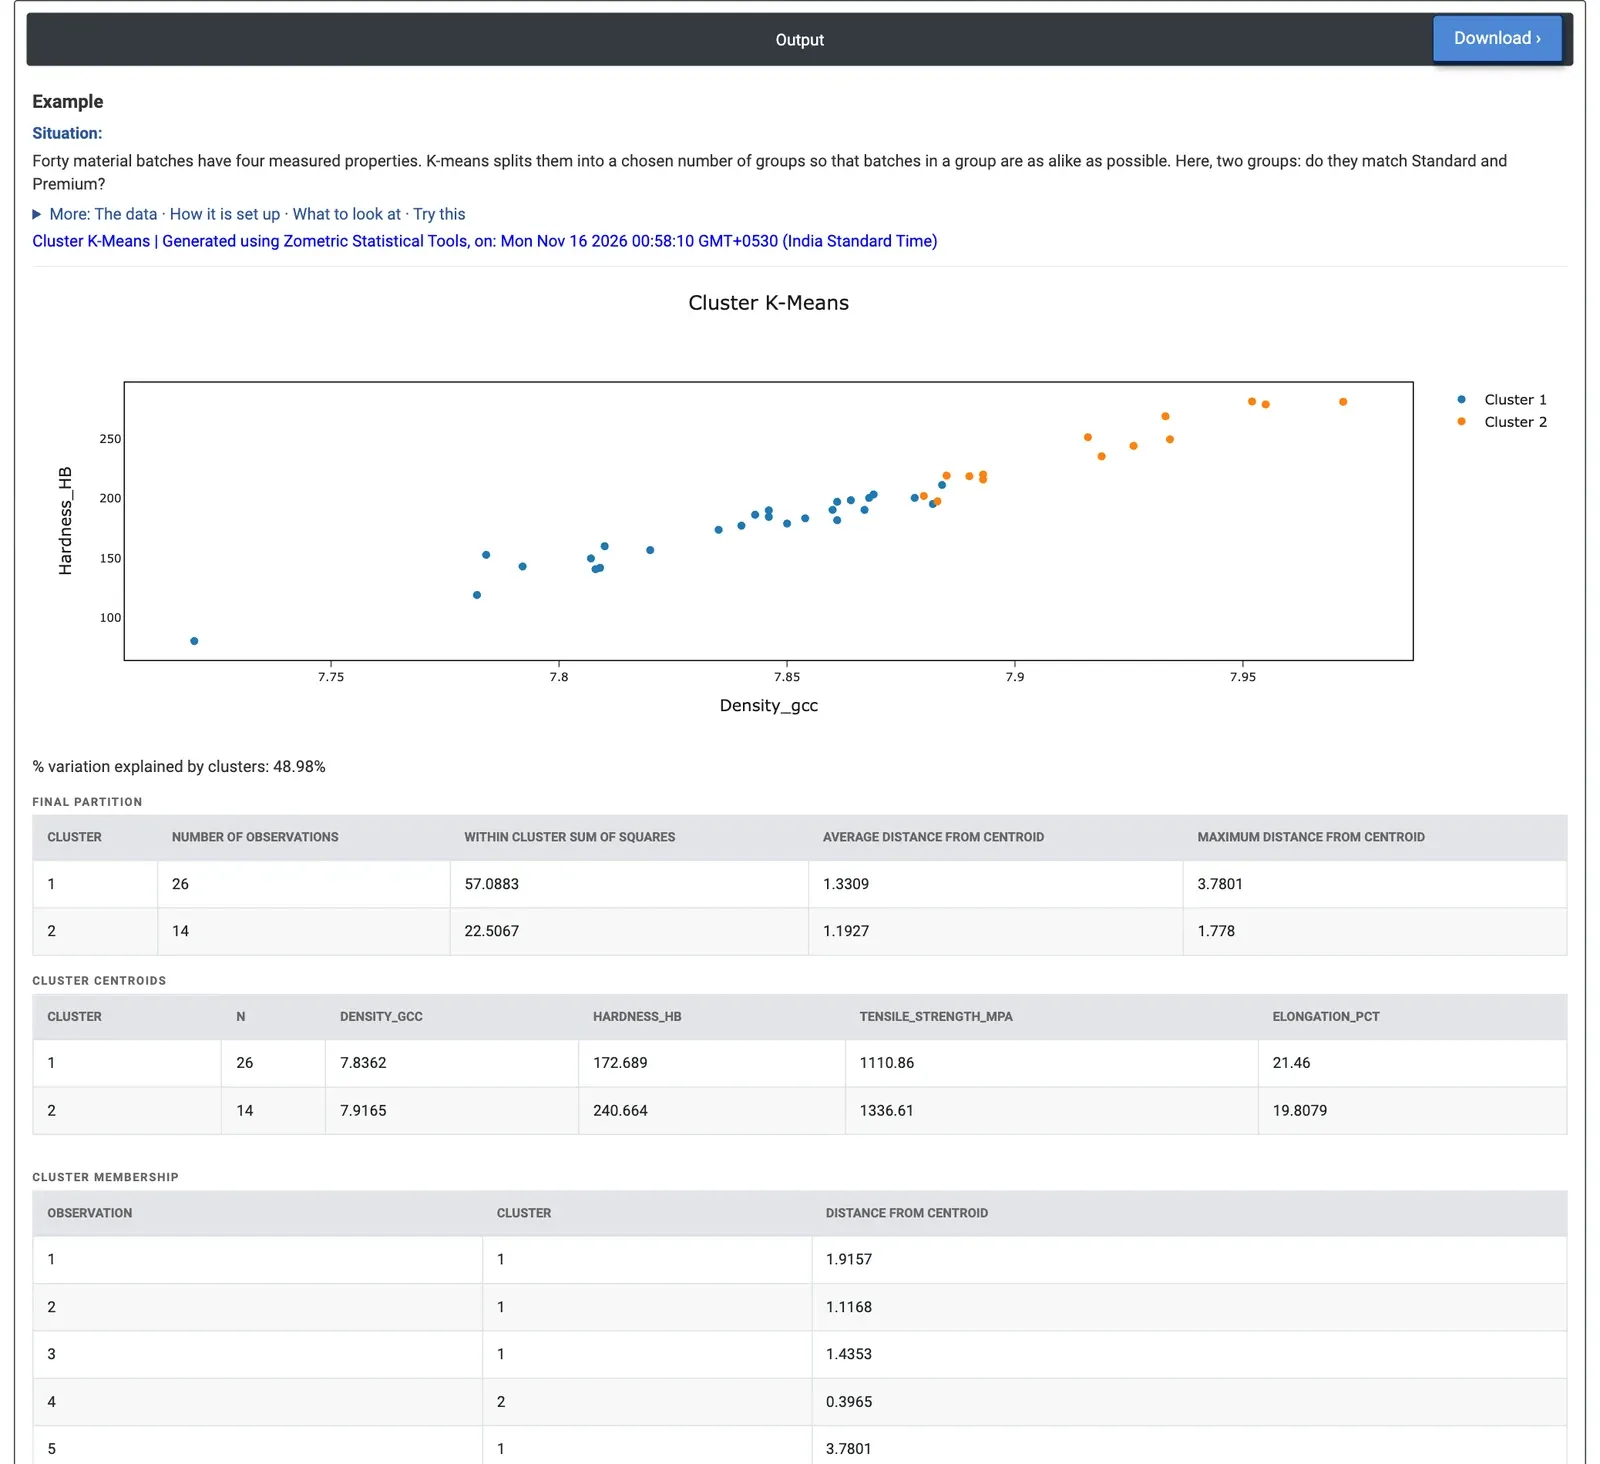
Figuur 2 — Twee clusters van 40 materiaalpartijen: Cluster 2 (14 partijen) is harder en sterker; de clusters verklaren 48.98% van de variatie. De uiteindelijke indeling, de centroïden en het begin van de lidmaatschapstabel volgen na de plot.
Uitgewerkt voorbeeld
Een materiaallab heeft 40 partijen, elk gemeten op dichtheid (g/cc), hardheid (HB), treksterkte (MPa) en rek (%). De partijen worden verkocht als Standard of Premium, 20 van elk. Het lab wil weten of de metingen alleen al in twee natuurlijke groepen uiteenvallen, en of die groepen overeenkomen met het partijtype. Het selecteert de vier eigenschapkolommen, stelt Number of clusters (K) = 2 in, laat Standardize variables aangevinkt (treksterkte, in de honderden, zou anders domineren) en houdt 10 willekeurige starts aan.
De clusters verklaren 48.98% van de variatie. Cluster 2 bevat 14 partijen die harder en sterker zijn (gemiddeld 240.7 HB en 1,336.6 MPa) en iets minder rekbaar (19.8% rek); Cluster 1 bevat 26 partijen met gemiddelden van 172.7 HB, 1,110.9 MPa en 21.5% rek. De dichtheidscentroïden verschillen slechts weinig (7.92 tegenover 7.84 g/cc). In de uiteindelijke indeling is Cluster 2 de compactere groep (gemiddelde afstand tot de centroïde 1.19 tegenover 1.33 gestandaardiseerde eenheden); het verst verwijderde lid van Cluster 1, rij 5, ligt 3.78 eenheden van zijn centroïde, een ongewone partij die een controle waard is. Vergeleken met de kolom met het partijtype bevat Cluster 2 11 Premium- en 3 Standard-partijen, en Cluster 1 17 Standard- en 9 Premium-partijen, dus 28 van de 40 partijen vallen in het cluster dat bij hun type past.
Voor het lab betekent dit dat de sterkste partijen een duidelijke groep vormen, maar dat veel Premium-partijen niet harder of sterker zijn dan Standard-partijen: het label wordt door de eigenschappen niet volledig ondersteund. Met K = 3 stijgt de verklaarde variatie naar 69.66% en scheidt een zachte, zwakke groep van 9 partijen (138.2 HB, 995.9 MPa) zich af van een middengroep van 23 en een topgroep van 8. Het uitvinken van Standardize variables verandert de verdeling in 19 en 21 partijen, omdat treksterkte dan het zwaarst weegt. Om een regel op te stellen die de bekende typen gebruikt, voert u Discriminant Analysis uit op dezelfde gegevens.
Veelgestelde vragen
Wanneer gebruikt u k-means-clustering?
Gebruik het wanneer u een bekend aantal groepen verwacht en waarnemingen, zoals materiaalpartijen, onderdelen of leveranciers, op basis van meerdere gemeten eigenschappen in typen wilt indelen. Het is ook nuttig om te controleren of een label dat u al gebruikt, zoals kwaliteitsklasse, lijn of ploeg, wel in de metingen terug te zien is.
Moet u variabelen standaardiseren vóór k-means?
Standaardiseren zet elke variabele om naar gemiddelde 0 en standaardafwijking 1, zodat een variabele die in grote eenheden is gemeten de indeling niet domineert. Het is standaard aangevinkt. Vink het alleen uit wanneer alle variabelen dezelfde eenheden hebben en u variabelen met een grotere spreiding zwaarder wilt laten wegen; in het uitgewerkte voorbeeld veranderde het uitvinken de verdeling, omdat treksterkte toen het zwaarst woog.
Hoe kiest u het aantal clusters K?
De uitvoer rapporteert het percentage van de totale variatie dat door de clusters wordt verklaard; een hoger getal betekent duidelijker gescheiden, compactere groepen. Het stijgt altijd naarmate K groeit, dus vergelijk het met zorg tussen verschillende K. In het voorbeeld verklaarden twee clusters 48.98% van de variatie en drie clusters 69.66%, waarbij een zachte, zwakke groep van 9 partijen zich afscheidde.
Wat is het verschil tussen k-means en discriminantanalyse?
K-means vindt groepen uitsluitend op basis van de metingen, zonder bekende labels te gebruiken. In het voorbeeld kwamen de twee clusters slechts bij 28 van de 40 partijen overeen met het label Standard of Premium. Om een regel op te stellen die de bekende typen gebruikt om de groepen te scheiden, voert u Discriminant Analysis uit op dezelfde gegevens.