
Waarnemingen clusteren (Cluster Observations)
Cluster Observations voegt stap voor stap de meest gelijkende waarnemingen samen op twee of meer numerieke variabelen en tekent het resultaat als dendrogram. Kies uit zeven koppelingsmethoden en vijf afstandsmaten, en standaardiseer variabelen met verschillende eenheden. Ward, Centroid en Median vereisen euclidische of kwadratische euclidische afstand. Bij invoer van een aantal clusters wordt de boom afgekapt en krijgt elke waarneming een label.
Laatst beoordeeld
Belangrijkste conclusie
Cluster Observations is hiërarchische clustering die rijen groepeert die op meerdere numerieke variabelen op elkaar lijken, zonder vooraf het aantal groepen te kennen, met een dendrogram dat natuurlijke groepen en afwijkende rijen toont.
Op deze pagina
Doel
Cluster Observations groepeert waarnemingen (rijen) die op meerdere numerieke variabelen op elkaar lijken, zonder dat u het aantal groepen vooraf hoeft te kennen. De tool voegt stap voor stap de meest gelijkende waarnemingen samen en tekent het resultaat als dendrogram (boom), zodat u ziet hoeveel natuurlijke groepen er zijn en welke waarnemingen bij elkaar horen. Gebruik het om te zoeken naar natuurlijke families van batches, onderdelen, leveranciers of productieruns, of om een waarneming op te sporen die in geen enkele groep past.
Belangrijkste mogelijkheden
- Hiërarchische (agglomeratieve) clustering van waarnemingen op twee of meer numerieke variabelen.
- Zeven koppelingsmethoden: Single, Complete, Average, Centroid, Median, McQuitty en Ward.
- Vijf afstandsmaten: Euclidean, Squared Euclidean, Manhattan (City Block), Cosine en Correlation.
- Optionele standaardisatie zodat variabelen met verschillende eenheden even zwaar tellen.
- Dendrogram van de volledige samenvoegingsvolgorde, en optioneel een clustertoewijzing voor elke waarneming wanneer u een aantal clusters opgeeft.
Statistische methoden
Rijen met een ontbrekende of niet-numerieke waarde in een van de geselecteerde variabelen worden weggelaten; er zijn minimaal 3 waarnemingen nodig. Als Standardize variables is aangevinkt, wordt elke variabele omgezet naar z = (x − gemiddelde) / s met de steekproefstandaardafwijking s. De afstand tussen elk paar waarnemingen wordt daarna berekend met de gekozen maat: Euclidean √Σ(xᵢ − yᵢ)², Squared Euclidean Σ(xᵢ − yᵢ)², Manhattan Σ|xᵢ − yᵢ|, Cosine 1 − cos(hoek tussen de twee rijen) of Correlation 1 − r tussen de twee rijen.
De clustering begint met elke waarneming als eigen cluster en voegt herhaaldelijk de twee dichtstbijzijnde clusters samen tot er één overblijft. De koppelingsmethode bepaalt hoe de afstand tussen twee clusters wordt gemeten: Single gebruikt het dichtstbijzijnde paar leden, Complete het verst verwijderde paar, Average het gemiddelde van alle onderlinge afstanden, McQuitty een gewogen gemiddelde, Centroid de afstand tussen de clustermiddelpunten, Median de afstand tussen ongewogen middelpunten, en Ward voegt het paar clusters samen dat de kleinste toename van de kwadratensom binnen de clusters geeft. Ward, Centroid en Median vereisen een euclidische of kwadratische euclidische afstand; de tool weigert andere combinaties.
De hoogte waarop twee takken in het dendrogram samenkomen, is de afstand tussen die takken op het moment van samenvoegen, dus lange verticale takken wijzen op goed gescheiden groepen. Als Number of clusters is ingevuld, wordt de boom afgekapt op het niveau dat dat aantal clusters geeft, en krijgt elke waarneming het nummer van haar cluster.
Invoervelden en opties
Veld | Beschrijving |
Variables | Twee of meer numerieke kolommen die elke waarneming beschrijven. Ctrl of Command + klik om er meerdere te selecteren. |
Linkage method | Hoe de afstand tussen clusters wordt gemeten: Single, Complete, Average (standaard), Centroid, Median, McQuitty of Ward. |
Distance measure | Hoe de afstand tussen twee waarnemingen wordt gemeten: Euclidean (standaard), Squared Euclidean, Manhattan (City Block), Cosine of Correlation. |
Standardize variables | Standaard aangevinkt. Schaalt eerst elke variabele naar gemiddelde 0 en standaardafwijking 1, zodat een variabele in grote eenheden niet domineert. |
Number of clusters | Optioneel, 2 of meer. Kapt de boom af in dit aantal clusters en voegt de tabel Cluster Assignments toe. Laat leeg om alleen het dendrogram te tonen. |
Title | Titel die op het dendrogram wordt getoond. Standaard Cluster Observations. |
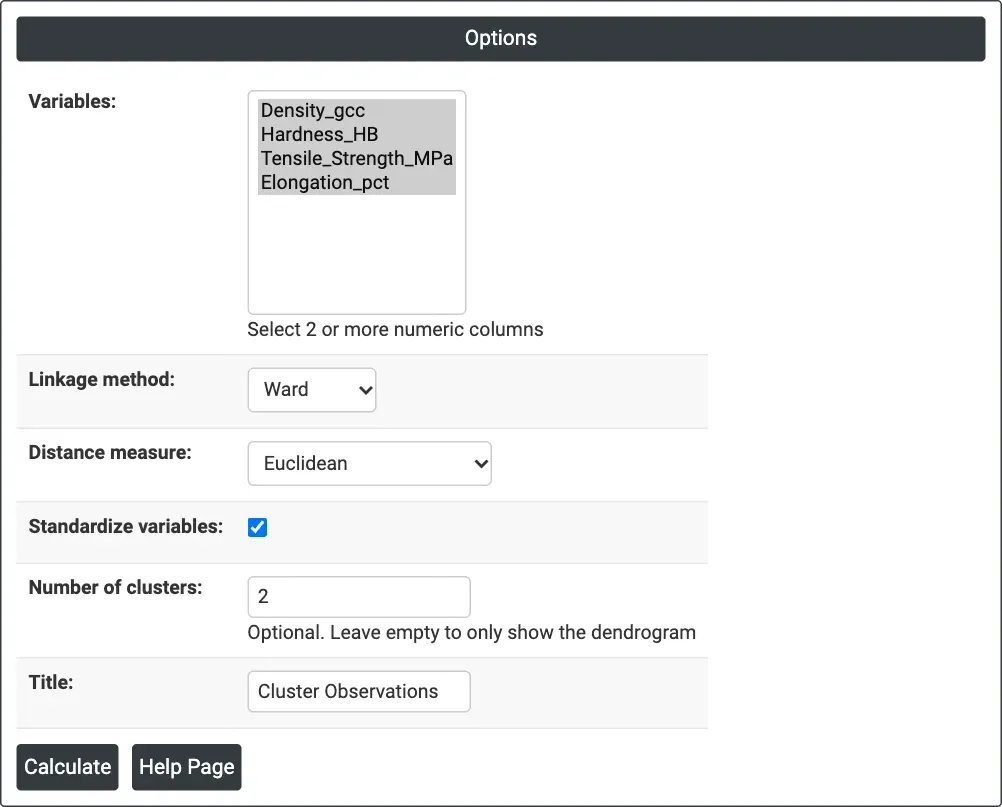
Figuur 1 — Opties voor het voorbeeld: vier eigenschapskolommen, Ward-koppeling, euclidische afstand, gestandaardiseerd, 2 clusters.
Beschrijving van de uitvoer
- Dendrogram — de samenvoegingsvolgorde. De waarnemingen (rijnummers) staan langs de x-as in boomvolgorde; de y-as (Distance) toont het niveau waarop takken samenkomen.
- Cluster Assignments — getoond wanneer Number of clusters is ingevuld: het rijnummer van elke waarneming en haar clusternummer.
- Pdf-export via Download.
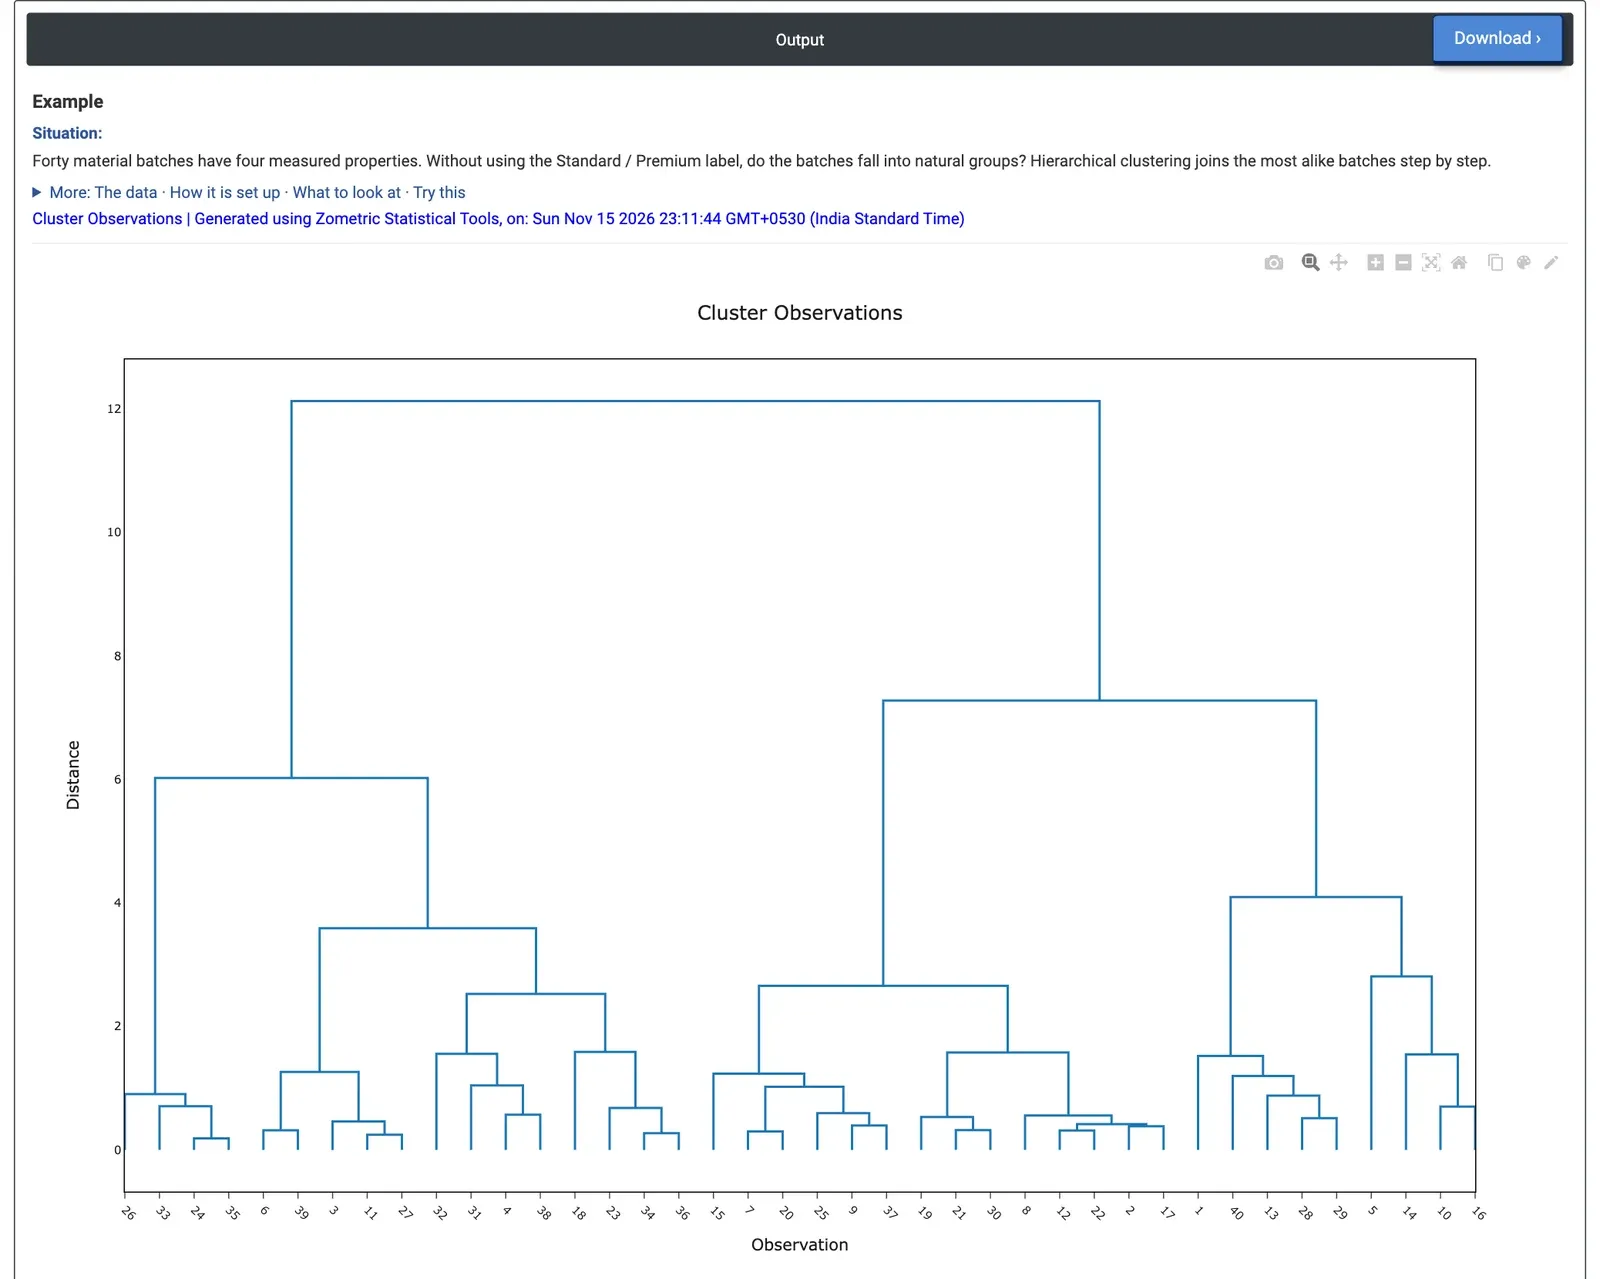
Figuur 2 — Dendrogram van 40 materiaalbatches met Ward-koppeling: twee hoofdtakken komen samen op een afstand van ongeveer 12.1.
Uitgewerkt voorbeeld
Een materiaallab heeft 40 batches gemeten op dichtheid (g/cc), hardheid (HB), treksterkte (MPa) en rek (%). Zonder gebruik te maken van het label Standard of Premium wil het lab weten of de batches in natuurlijke groepen uiteenvallen. Het selecteert de vier eigenschapskolommen, kiest Linkage method = Ward en Distance measure = Euclidean, laat Standardize variables aangevinkt (dichtheid in g/cc en sterkte in MPa zijn anders niet vergelijkbaar) en voert Number of clusters = 2 in.
Het dendrogram toont twee hoofdtakken die samenkomen op een afstand van 12.1, ruim boven de volgende samenvoegingen (7.3 en 6.0), dus twee groepen is een natuurlijke afkapping. Cluster 1 telt 17 batches die harder en sterker zijn (gemiddeld 231.6 HB en 1,308 MPa, 19.8% rek); Cluster 2 telt 23 zachtere en taaiere batches (170.5 HB, 1,103 MPa, 21.7% rek). Afgezet tegen het batchtype bevat Cluster 1 12 Premium- en 5 Standard-batches en Cluster 2 15 Standard- en 8 Premium-batches: de clusters volgen het type slechts voor 27 van de 40 batches.
Voor het lab overlappen de eigenschappen van de twee typen sterk, en een flink deel van de Standard-batches is even sterk als Premium-batches. De keuze van de koppeling doet ertoe: met Average-koppeling scheidt de afkapping in twee clusters één enkele batch af (rij 5, 80.1 HB en 822.6 MPa, veel zachter dan de rest) en voegt ze de andere 39 samen, wat een bruikbare manier is om een uitschieter te vinden in plaats van groepen. Het afkappen van de Ward-boom op 3 clusters scheidt een zachte groep van 9 batches af (138.2 HB, 995.9 MPa).
Veelgestelde vragen
Wat is hiërarchische clustering van waarnemingen?
Het begint met elke waarneming als eigen cluster en voegt herhaaldelijk de twee dichtstbijzijnde clusters samen tot er één overblijft. Het resultaat wordt als dendrogram getekend, zodat u kunt zien hoeveel natuurlijke groepen er zijn en welke waarnemingen bij elkaar horen, zonder het aantal groepen vooraf te kennen. Het kan ook een waarneming aan het licht brengen die in geen enkele groep past.
Hoe leest u een dendrogram?
De waarnemingen staan langs de x-as in boomvolgorde, en de y-as toont de afstand waarop takken samenkomen. Lange verticale takken wijzen op goed gescheiden groepen. In het uitgewerkte voorbeeld kwamen twee hoofdtakken samen op een afstand van 12.1, ruim boven de volgende samenvoegingen op 7.3 en 6.0, dus twee groepen was een natuurlijke afkapping.
Welke koppelingsmethode gebruikt u?
De tool biedt Single, Complete, Average, Centroid, Median, McQuitty en Ward. Ward voegt het paar clusters samen dat de kleinste toename van de kwadratensom binnen de clusters geeft en vereist, net als Centroid en Median, een euclidische of kwadratische euclidische afstand. De keuze doet ertoe: in het voorbeeld scheidde Average-koppeling één afwijkende batch af, terwijl Ward twee groepen vond.
Moet u variabelen standaardiseren voordat u waarnemingen clustert?
Standardize variables is standaard aangevinkt en schaalt eerst elke variabele naar gemiddelde 0 en standaardafwijking 1, zodat een variabele in grote eenheden niet domineert. In het voorbeeld waren dichtheid in g/cc en sterkte in MPa anders niet vergelijkbaar geweest. Rijen met een ontbrekende of niet-numerieke waarde worden weggelaten, en er zijn minimaal 3 waarnemingen nodig.