
Variabelen clusteren
Variabelen clusteren past hiërarchische clustering toe op drie of meer numerieke variabelen, met correlatie, absolute correlatie of Euclidische afstand en een van zeven koppelingsmethoden. Variabelen die samen bewegen worden als eerste samengevoegd, getoond in een dendrogram. Gebruik het om een lange lijst metingen of enquêtevragen in te korten. Er zijn minimaal 3 volledige rijen nodig. Door een aantal clusters in te voeren wordt elke variabele gelabeld.
Laatst beoordeeld
Belangrijkste conclusie
Variabelen clusteren groepeert variabelen (kolommen) met vergelijkbare informatie en voegt de variabelen samen die samen stijgen en dalen, zodat een lange lijst metingen of enquêtevragen kan worden teruggebracht tot één per cluster.
Op deze pagina
Doel
Variabelen clusteren groepeert variabelen (kolommen) die vergelijkbare informatie bevatten. Variabelen die over de waarnemingen heen samen stijgen en dalen, worden als eerste samengevoegd, en het resultaat wordt als dendrogram getekend. Gebruik het om een lange lijst metingen of enquêtevragen in te korten: als meerdere variabelen in hetzelfde cluster vallen, kunt u er één van volgen, of een gecombineerde score, in plaats van alle.
Belangrijkste mogelijkheden
- Hiërarchische clustering van drie of meer numerieke variabelen.
- Afstand op basis van correlatie, absolute correlatie of Euclidische afstand.
- Zeven koppelingsmethoden: Single, Complete, Average, Centroid, Median, McQuitty en Ward.
- Dendrogram dat de volgorde en het niveau toont waarop variabelen worden samengevoegd.
- Optionele clustertoewijzing voor elke variabele wanneer u een aantal clusters opgeeft.
Statistische methoden
Rijen met een ontbrekende of niet-numerieke waarde in een geselecteerde variabele worden weggelaten; er zijn minimaal 3 variabelen en 3 volledige rijen nodig. Elke variabele wordt behandeld als een punt waarvan de coördinaten de waarden over de rijen zijn, en de afstand tussen elk paar variabelen wordt berekend met de gekozen maat. De correlatieafstand is 1 − r, waarbij r de Pearson-correlatie tussen de twee variabelen is: 0 voor een perfect positieve correlatie en 2 voor een perfect negatieve. De Absolute Correlation-afstand is 1 − |r| en behandelt een sterk negatief verband als even dichtbij als een sterk positief verband. De Euclidische afstand is √Σ(xᵢ − yᵢ)² op de ruwe waarden en hangt dus af van de eenheden van elke variabele.
De clustering begint met elke variabele afzonderlijk en voegt telkens de twee dichtstbijzijnde clusters samen. De koppelingsmethode bepaalt de afstand tussen clusters: Single gebruikt het dichtstbijzijnde paar, Complete het verst verwijderde paar, Average het gemiddelde van alle paarsgewijze afstanden, McQuitty een gewogen gemiddelde, Centroid en Median de afstand tussen clustermiddelpunten, en Ward de kleinste toename van de kwadratensom binnen clusters. Ward, Centroid en Median vereisen de Euclidische afstand; de tool weigert andere combinaties.
Bij correlatieafstand betekent een samenvoeging op hoogte h dat de variabelen in de twee takken een gemiddelde correlatie van ongeveer 1 − h hebben. Wanneer Number of clusters is ingevuld, wordt de boom afgekapt tot dat aantal clusters en krijgt elke variabele het label van zijn cluster.
Invoervelden en opties
Veld | Beschrijving |
Variables | Drie of meer numerieke kolommen om te groeperen. Ctrl of Command + klik om er meerdere te selecteren. |
Linkage method | Hoe de afstand tussen clusters wordt gemeten: Single, Complete, Average (standaard), Centroid, Median, McQuitty of Ward. |
Distance measure | Correlation (standaard), Absolute Correlation of Euclidean. |
Number of clusters | Optioneel, 2 of meer. Kapt de boom af tot dit aantal clusters en voegt de tabel Cluster Assignments toe. Laat leeg om alleen het dendrogram te tonen. |
Title | Titel die op het dendrogram wordt getoond. Standaard Cluster Variables. |
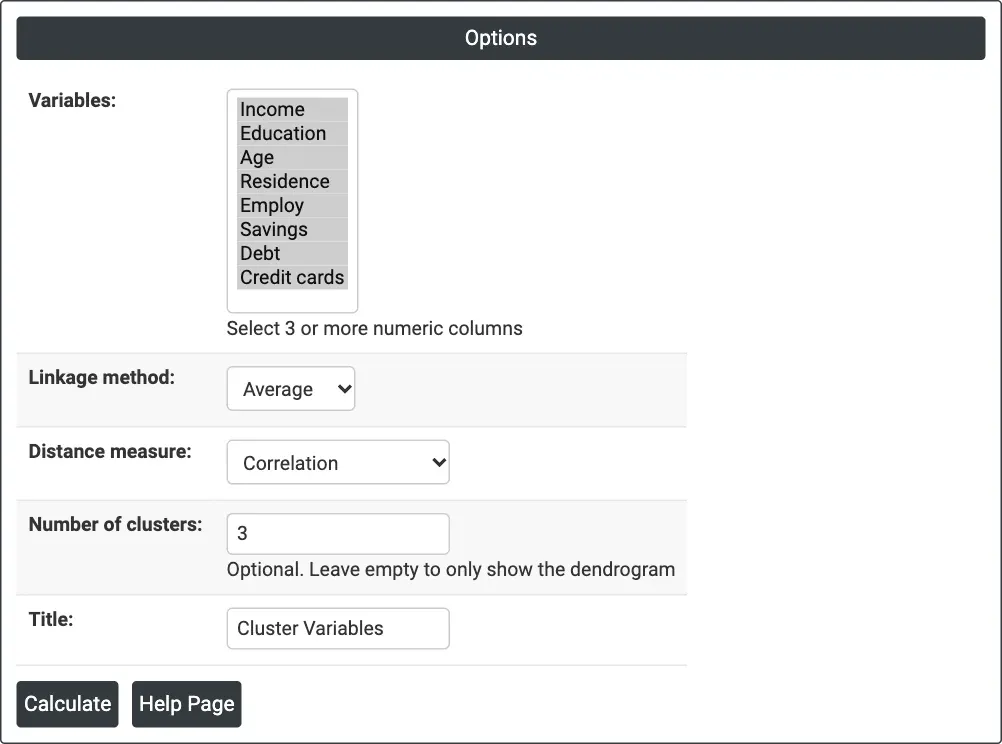
Figuur 1 — Opties voor het voorbeeld: acht variabelen van leningaanvragers, Average-koppeling, Correlation-afstand, 3 clusters.
Beschrijving van de uitvoer
- Dendrogram: de variabelen langs de x-as in boomvolgorde; de y-as (Distance) toont het niveau waarop takken samenkomen. Hoe lager de samenvoeging, hoe meer de variabelen op elkaar lijken.
- Cluster Assignments: getoond wanneer Number of clusters is ingevuld; elke variabele met haar clusternummer.
- PDF-export via Download.
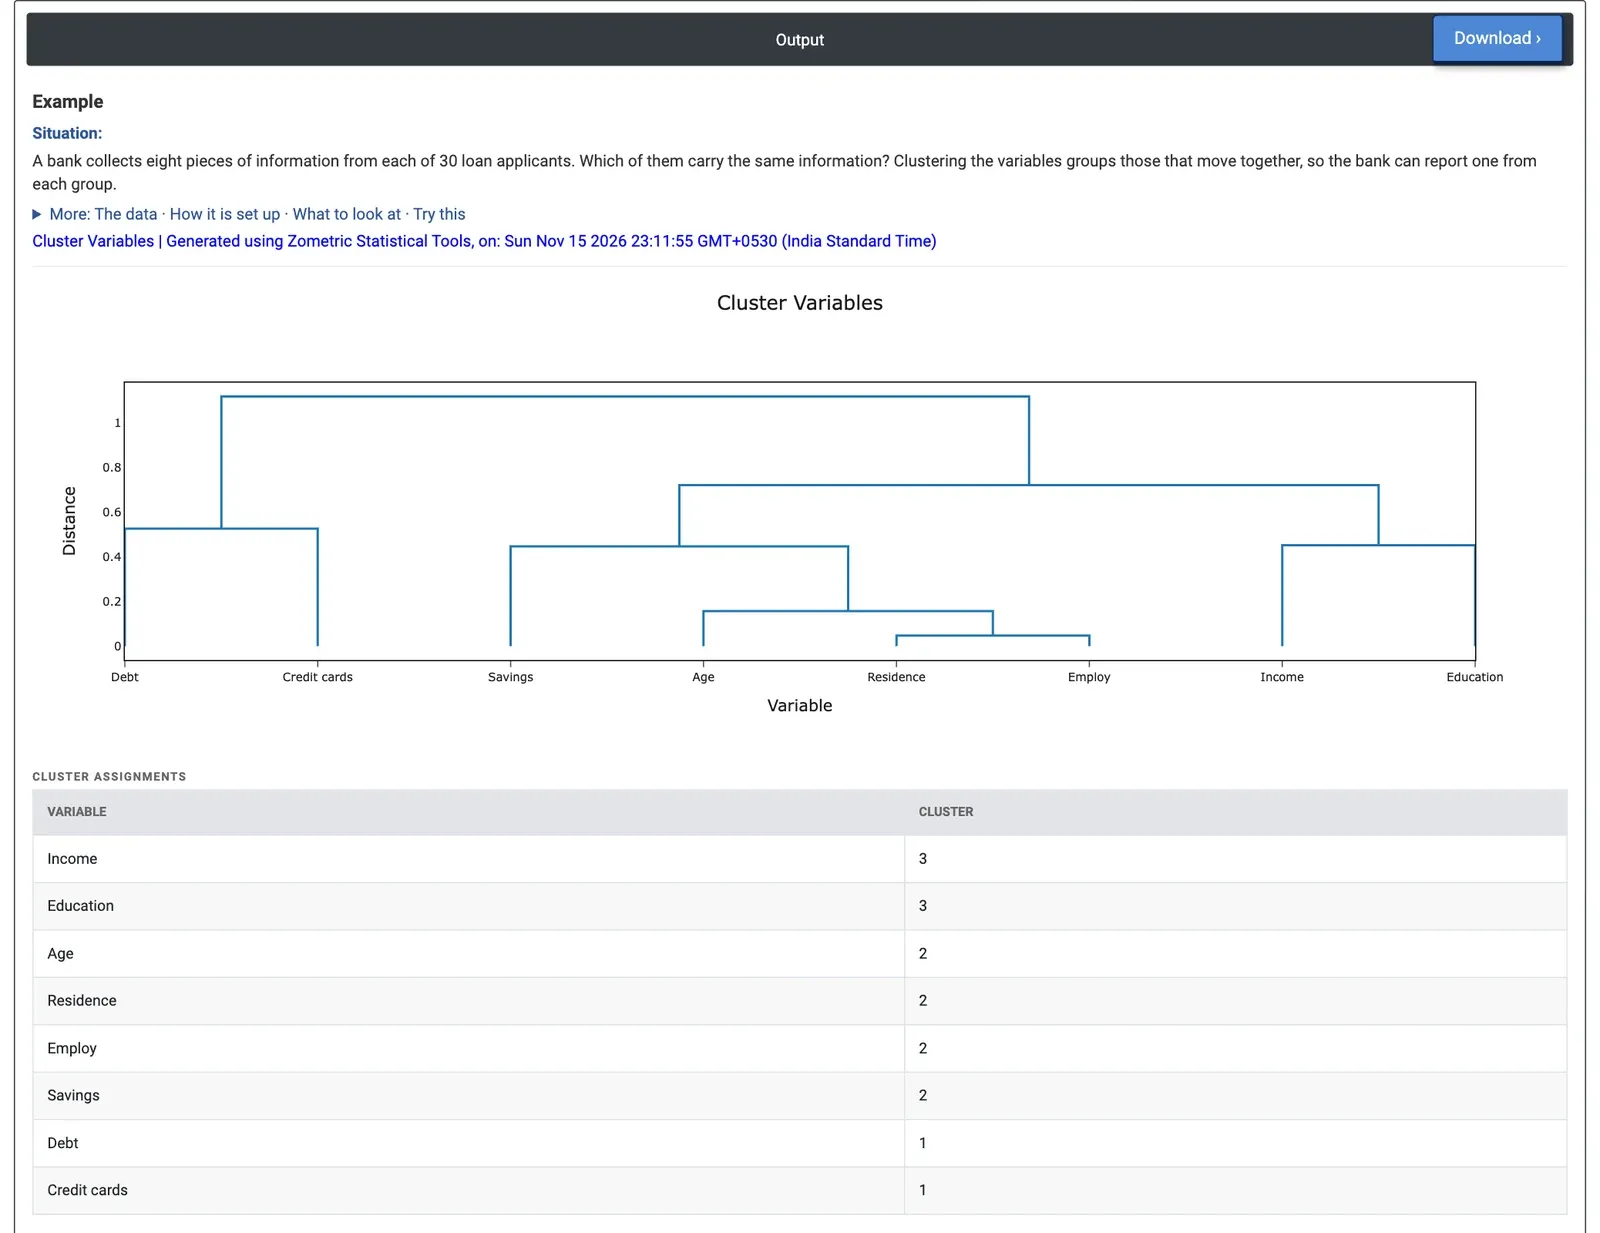
Figuur 2 — Dendrogram en clustertoewijzingen voor de acht variabelen van leningaanvragers: clusters voor stabiliteit, inkomen en lenen.
Uitgewerkt voorbeeld
Een bank registreert acht gegevens van elke leningaanvrager: inkomen, jaren opleiding, leeftijd, jaren op het huidige adres (Residence), jaren bij de huidige werkgever (Employ), spaargeld, schulden en aantal creditcards. Een kredietanalist wil weten welke daarvan dezelfde informatie bevatten, zodat een kort rapport er één uit elke groep kan tonen. Met 30 aanvragers selecteert de analist alle acht kolommen, laat hij Linkage method = Average en Distance measure = Correlation staan en voert hij Number of clusters = 3 in.
Residence en Employ worden als eerste samengevoegd, op een afstand van 0.048 (correlatie 0.95), en Age sluit daar aan op 0.157. Savings voegt zich bij deze groep op 0.446. Income en Education komen samen op 0.451, en Debt en Credit cards op 0.526. Met drie clusters bevat Cluster 2 Age, Residence, Employ en Savings, die de stabiliteit van de aanvrager beschrijven; Cluster 3 bevat Income en Education; en Cluster 1 bevat Debt en Credit cards, het lenen. De laatste twee samenvoegingen komen op 0.72 en 1.117, ruim boven de andere, wat drie groepen ondersteunt.
Voor de analist zou één variabele uit elk cluster, bijvoorbeeld Employ, Income en Debt, het grootste deel dekken van wat de acht variabelen zeggen. Met Number of clusters = 2 worden de clusters voor stabiliteit en inkomen samengevoegd en blijven Debt en Credit cards apart staan; bij 4 clusters worden Debt en Credit cards gescheiden. Factoranalyse op dezelfde acht kolommen geeft een vergelijkbare groepering, met ladingen die tonen hoe sterk elke variabele bij haar groep hoort.
Veelgestelde vragen
Waarvoor wordt Variabelen clusteren gebruikt?
Het wordt gebruikt om een lange lijst metingen of enquêtevragen in te korten. Variabelen die over de waarnemingen heen samen stijgen en dalen, worden als eerste samengevoegd, en het resultaat wordt als dendrogram getekend. Als meerdere variabelen in hetzelfde cluster vallen, kunt u er één van volgen, of een gecombineerde score, in plaats van alle.
Wat is correlatieafstand?
Correlatieafstand is 1 − r, waarbij r de Pearson-correlatie tussen twee variabelen is: 0 voor een perfect positieve correlatie en 2 voor een perfect negatieve. De absolute correlatieafstand, 1 − |r|, behandelt een sterk negatief verband als even dichtbij als een sterk positief verband. De Euclidische afstand gebruikt de ruwe waarden en hangt dus af van de eenheden van elke variabele.
Hoe leest u het dendrogram voor variabelen?
De variabelen staan langs de x-as in boomvolgorde en de y-as toont de afstand waarop takken samenkomen; hoe lager de samenvoeging, hoe meer de variabelen op elkaar lijken. Bij correlatieafstand betekent een samenvoeging op hoogte h dat de variabelen in de twee takken een gemiddelde correlatie van ongeveer 1 − h hebben.
Hoe kiest u het aantal clusters van variabelen?
Zoek naar samenvoegingen die ruim boven de andere liggen. In het voorbeeld van de leningaanvragers kwamen de laatste twee samenvoegingen op 0.72 en 1.117, ruim boven de rest, wat drie clusters ondersteunde: stabiliteit, inkomen en lenen. Eén variabele uit elk cluster, zoals Employ, Income en Debt, zou dan het grootste deel dekken van wat de acht variabelen zeggen.