
Eenvoudige correspondentieanalyse
Eenvoudige correspondentieanalyse neemt ruwe categorische gegevens of een kruistabel en zet rij- en kolomcategorieën uit op een kaart. Ze rapporteert een chikwadraattoets voor associatie, een inertietabel die toont hoeveel elke component verklaart, en bijdragetabellen voor rijen en kolommen. Elke variabele heeft ten minste 2 categorieën nodig. Gebruik ze om het patroon in een grote kruistabel te lezen, zoals defecttypen per machine.
Laatst beoordeeld
Belangrijkste conclusie
Eenvoudige correspondentieanalyse zet een tweewegtabel met aantallen om in een kaart waarop rij- en kolomcategorieën die vaker samengaan dan op basis van toeval te verwachten is, dicht bij elkaar liggen.
Op deze pagina
Doel
Eenvoudige correspondentieanalyse zet een tweewegtabel met aantallen om in een kaart. Rijcategorieën en kolomcategorieën worden als punten getekend, en categorieën die vaker samengaan dan op basis van toeval te verwachten is, liggen dicht bij elkaar. Gebruik ze om in één oogopslag het patroon in een grote kruistabel te zien: welke defecttypen bij welke machines horen, welke klachtencategorieën bij welke producten, of welke eigenschappen klanten met welke merken verbinden.
Belangrijkste mogelijkheden
- Accepteert ruwe gegevens (één rij per eenheid met twee categorische kolommen) of een kruistabel die al als aantallen is samengevat.
- Chikwadraattoets voor associatie tussen de rij- en de kolomvariabele.
- Inertietabel die toont hoeveel van de associatie elke component (as van de kaart) verklaart.
- Bijdragetabellen voor rijen en kolommen: kwaliteit, massa, inertie, coördinaten, gekwadrateerde correlaties en bijdragen voor het aantal componenten dat u kiest.
- Vijf plots: symmetrische plot van rijen en kolommen, alleen rijen, alleen kolommen, en asymmetrische rij- of kolomplots.
Statistische methoden
Bij de invoer Categorical variables maakt de tool een kruistabel van de rijvariabele tegen de kolomvariabele, waarbij rijen met een ontbrekende waarde worden genegeerd. Bij de invoer Columns of a contingency table bevat elke geselecteerde kolom de aantallen voor één kolomcategorie en is elke rij een rijcategorie; rijen of kolommen met totaal nul worden weggelaten. Elke variabele heeft ten minste 2 categorieën nodig.
De aantallen worden gedeeld door het eindtotaal n om proporties P te krijgen, met rijmassa's r (rijtotalen van P) en kolommassa's c (kolomtotalen). De matrix van gestandaardiseerde residuen S = Dr^−½ (P − r cᵀ) Dc^−½ wordt ontbonden via singulierewaardenontbinding. Elke singuliere waarde d geeft één component met inertie d², en het aantal componenten is het kleinste van (rijen − 1) en (kolommen − 1). De totale inertie is gelijk aan de chikwadraatstatistiek gedeeld door n, en de tool rapporteert chikwadraat = n × totale inertie met (rijen − 1)(kolommen − 1) vrijheidsgraden en de bijbehorende p-waarde. Een kleine p-waarde betekent dat de rijen en kolommen geassocieerd zijn, zodat de kaart een echt patroon toont.
De hoofdcoördinaten voor rijen zijn Dr^−½ U D en voor kolommen Dc^−½ V D. In de bijdragetabellen is Mass het aandeel van de categorie in het totale aantal, Inert het aandeel in de totale inertie, Corr de gekwadrateerde cosinus (hoe goed één component het punt weergeeft), Qual de som van Corr over de gerapporteerde componenten en Contr het deel van de inertie van een component dat het punt verklaart. Symmetrische plots gebruiken hoofdcoördinaten voor beide puntenverzamelingen; een asymmetrische rijplot toont rijen in hoofdcoördinaten en kolommen in standaardcoördinaten (hoofdcoördinaten gedeeld door d), en een asymmetrische kolomplot het omgekeerde.
Invoervelden en opties
Veld | Beschrijving |
Input data | Categorical variables (standaard): één rij per eenheid. Columns of a contingency table: aantallen die al zijn samengevat. De onderstaande velden veranderen met deze keuze. |
Row variable / Column variable | Bij de invoer Categorical variables: de twee categorische kolommen waarvan een kruistabel wordt gemaakt. Beide zijn vereist en moeten verschillend zijn. |
Contingency table columns | Bij kruistabelinvoer: twee of meer kolommen, elk met de aantallen voor één kolomcategorie, één rij per rijcategorie. |
Row names | Bij kruistabelinvoer, optioneel: een kolom met de naam van elke rij van de tabel. Leeg laten gebruikt Row 1, Row 2, enzovoort. |
Column names | Bij kruistabelinvoer, optioneel: een kolom met één naam per geselecteerde tabelkolom, in dezelfde volgorde. Leeg laten gebruikt de kolomkoppen. |
Number of components | Voor hoeveel componenten Coord, Corr en Contr in de bijdragetabellen worden gerapporteerd. Standaard 2; 1 tot 20, beperkt tot het aantal beschikbare componenten. |
Symmetric plot showing rows and columns | Standaard aangevinkt. Rijen en kolommen op één kaart, beide in hoofdcoördinaten. |
Symmetric plot showing rows only / columns only | Standaard niet aangevinkt. Dezelfde kaart met slechts één puntenverzameling. |
Asymmetric row plot / Asymmetric column plot | Standaard niet aangevinkt. Rijen in hoofdcoördinaten en kolommen in standaardcoördinaten, of omgekeerd. |
Title | Titel die op de plots wordt getoond. Standaard Simple Correspondence Analysis. |
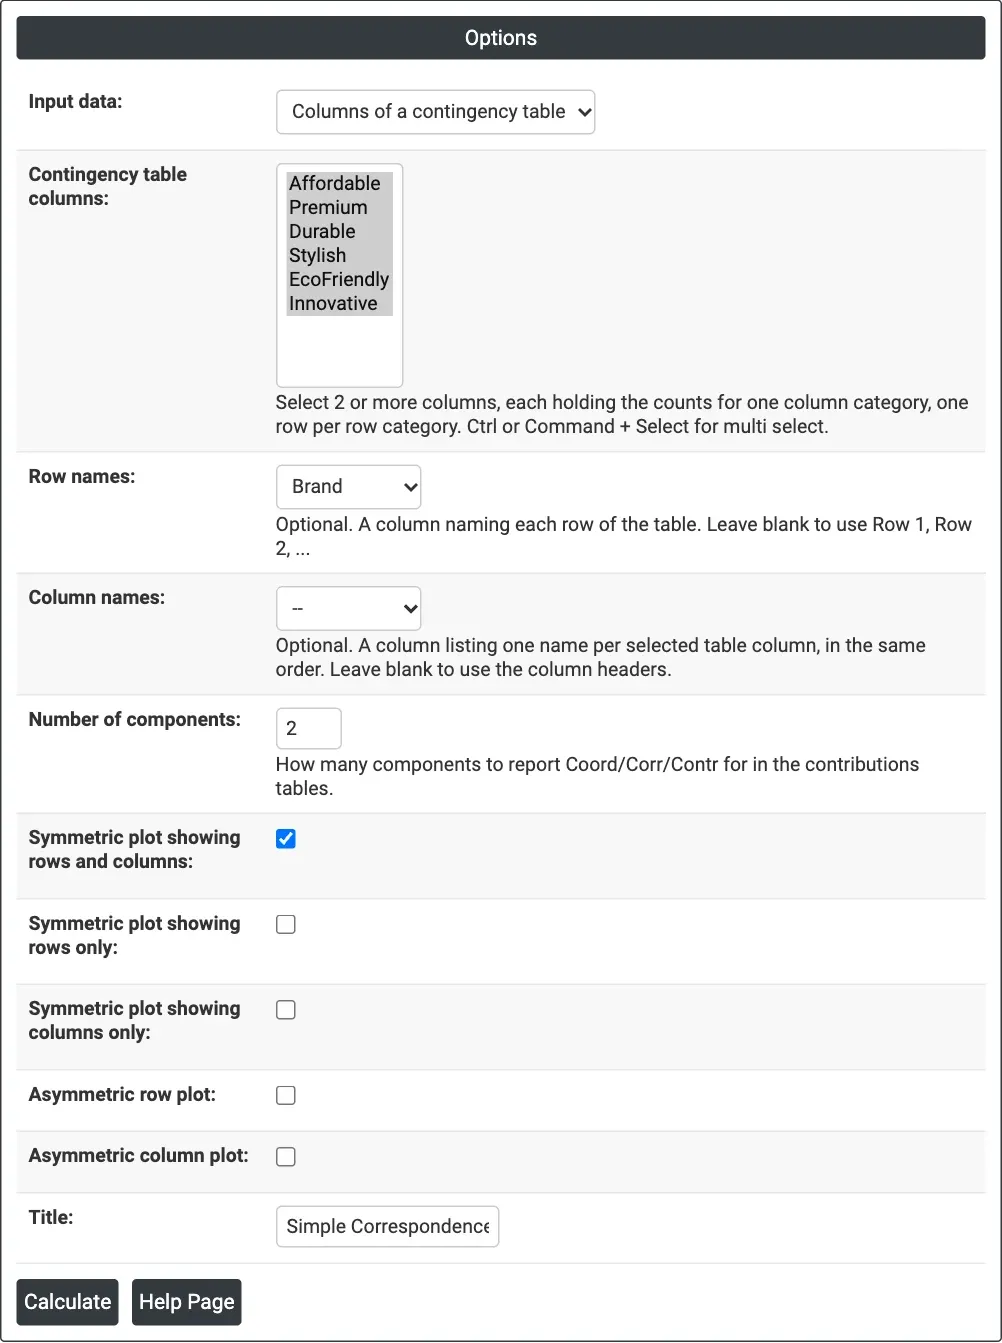
Figuur 1 — Opties voor het voorbeeld over merkperceptie: kruistabelinvoer met zes eigenschapskolommen en Brand als rijnamen.
Beschrijving van de uitvoer
- Symmetric Plot, Row Plot, Column Plot, Asymmetric Row Plot, Asymmetric Column Plot — de aangevinkte plots, met Component 1 en Component 2 als assen en in de astitels het percentage inertie dat elke component verklaart.
- Contingency Table — getoond bij kruistabelinvoer: de tabel zoals geanalyseerd.
- Chi-square, DF en P-value — de toets voor associatie tussen rijen en kolommen.
- Analysis of Contingency Table — inertie, proportie en cumulatieve proportie voor elke as, met een teksthistogram, en de totale inertie.
- Row Contributions en Column Contributions — ID, Name, Qual, Mass, Inert, en Coord, Corr en Contr voor elke gerapporteerde component.
- PDF-export via Download.
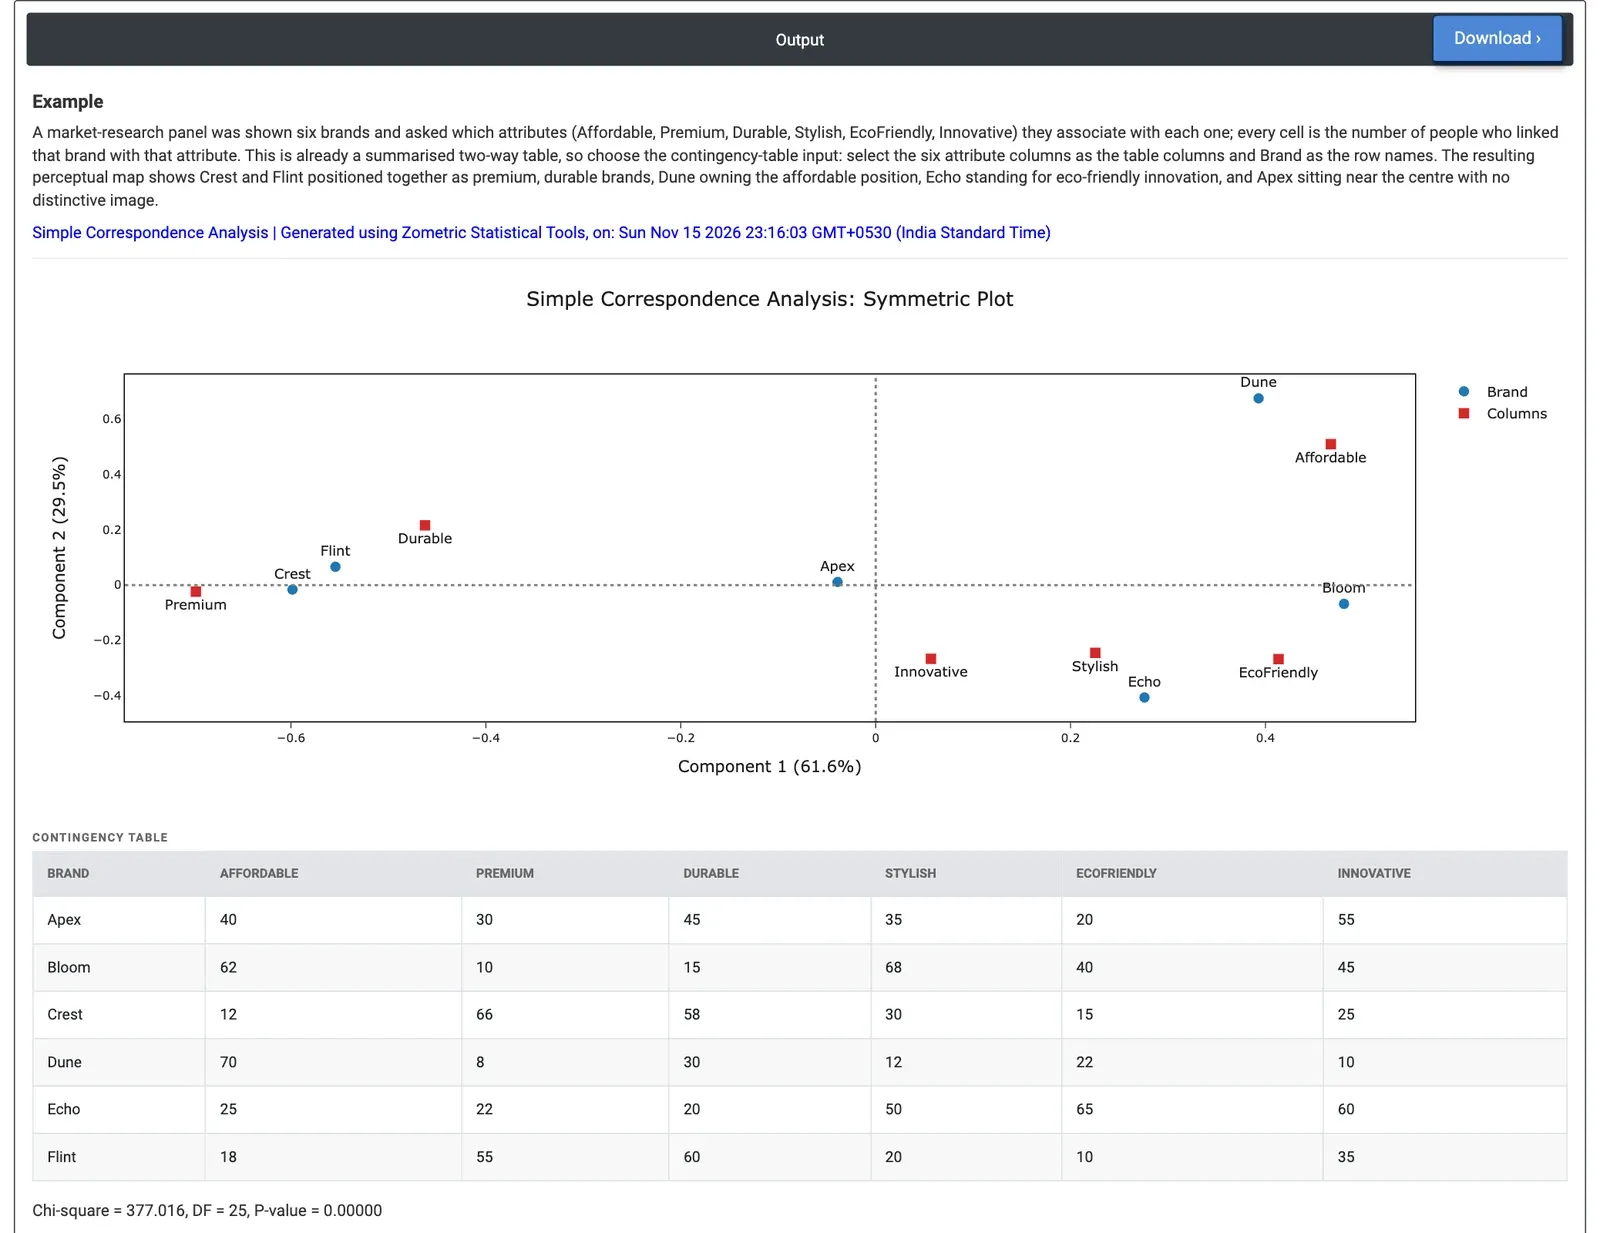
Figuur 2 — Symmetrische plot van zes merken en zes eigenschappen: Crest en Flint liggen bij Premium en Durable, Dune bij Affordable, Echo dicht bij EcoFriendly; chikwadraat 377.0 met 25 DF.
Uitgewerkt voorbeeld
Aan een marktonderzoekspanel zijn zes merken (Apex, Bloom, Crest, Dune, Echo en Flint) getoond met de vraag welke van zes eigenschappen men met elk merk verbindt: Affordable, Premium, Durable, Stylish, EcoFriendly en Innovative. Elke cel bevat het aantal mensen dat dat merk met die eigenschap verbond. Het marketingteam wil de positie van elk merk zien. Omdat de gegevens al een tabel met aantallen zijn, stellen ze Input data = Columns of a contingency table in, selecteren ze de zes eigenschapskolommen als Contingency table columns en kiezen ze Brand als Row names, waarbij de symmetrische plot van rijen en kolommen behouden blijft.
Het chikwadraat is 377.016 met 25 vrijheidsgraden (p < 0.00001), dus het merkimago verschilt duidelijk tussen merken. Component 1 draagt 61.6% van de inertie en Component 2 29.5%, zodat de tweedimensionale kaart 91.1% van het patroon toont. Component 1 loopt van Premium (−0.698) en Durable (−0.462) links naar Affordable (0.467) en EcoFriendly (0.414) rechts. Crest (−0.599) en Flint (−0.554) liggen aan de premium, duurzame kant en worden op deze as bijna perfect weergegeven (Corr 0.94 en 0.98). Dune ligt hoog op Component 2 (0.674), naast Affordable, en verklaart 62.2% van de inertie van die component. Echo (0.276, −0.406) ligt dicht bij EcoFriendly, Stylish en Innovative, en Bloom (0.481) helt naar Stylish en Affordable.
Apex ligt dicht bij het midden (−0.039, 0.011) met een kwaliteit van slechts 0.038: zijn profiel ligt dicht bij het gemiddelde van alle merken, dus het heeft geen onderscheidend imago. Voor het team betekent dit dat Crest en Flint strijden om dezelfde premium, duurzame positie, dat Dune de betaalbare positie bezit, en dat Apex het merk is dat een duidelijkere boodschap nodig heeft.
Veelgestelde vragen
Waarvoor wordt correspondentieanalyse gebruikt?
Ze wordt gebruikt om in één oogopslag het patroon in een grote kruistabel te zien, bijvoorbeeld welke defecttypen bij welke machines horen, welke klachtencategorieën bij welke producten, of welke eigenschappen klanten met welke merken verbinden. Rij- en kolomcategorieën worden als punten getekend, en categorieën die vaker samengaan dan op basis van toeval te verwachten is, liggen dicht bij elkaar.
Wat is inertie in correspondentieanalyse?
Inertie meet de associatie in de tabel. Elke component, oftewel as van de kaart, heeft een inertie gelijk aan het kwadraat van zijn singuliere waarde, en de totale inertie is gelijk aan de chikwadraatstatistiek gedeeld door het eindtotaal n. De inertietabel toont het aandeel dat elke component verklaart; in het merkvoorbeeld toonden de eerste twee componenten 91.1% van het patroon.
Hoe interpreteert u kwaliteit, massa en bijdrage?
Mass is het aandeel van een categorie in het totale aantal, Inert het aandeel in de totale inertie, Corr hoe goed één component het punt weergeeft, Qual de som van Corr over de gerapporteerde componenten en Contr het deel van de inertie van een component dat het punt verklaart. Een punt dicht bij het midden met een lage kwaliteit, zoals Apex in het voorbeeld, heeft een profiel dicht bij het gemiddelde.
Wat is het verschil tussen symmetrische en asymmetrische plots?
Een symmetrische plot toont rijen en kolommen samen, beide in hoofdcoördinaten, en is standaard aangevinkt. Een asymmetrische rijplot toont rijen in hoofdcoördinaten en kolommen in standaardcoördinaten (hoofdcoördinaten gedeeld door de singuliere waarde), en een asymmetrische kolomplot doet het omgekeerde. Plots met alleen rijen of alleen kolommen zijn ook beschikbaar.