
Beschrijvende statistiek
Beschrijvende statistiek is een fundamentele analysetool die een uitgebreide set numerieke samenvattingen berekent en toont van de belangrijkste kenmerken van uw gegevens. Ze omvat drie hoofddimensies — centrale tendens (waar de gegevens gecentreerd zijn), spreiding (hoeveel de gegevens variëren) en vorm (hoe de gegevens verdeeld zijn).
Laatst beoordeeld
Belangrijkste conclusie
Beschrijvende statistiek is een fundamentele analysetool die een set numerieke samenvattingen berekent en toont van de belangrijkste kenmerken van uw gegevens: centrale tendens, spreiding en vorm.
Op deze pagina
- Wat is beschrijvende statistiek?
- Wanneer gebruikt u beschrijvende statistiek?
- Belangrijke statistieken uitgelegd
- Richtlijnen voor correct gebruik van beschrijvende statistiek
- Alternatieven: wanneer u beschrijvende statistiek niet gebruikt
- Voorbeeld van beschrijvende statistiek
- Zo voert u beschrijvende statistiek uit
Wat is beschrijvende statistiek?
Beschrijvende statistiek is een fundamentele analysetool die een uitgebreide set numerieke samenvattingen berekent en toont van de belangrijkste kenmerken van uw gegevens. Ze omvat drie hoofddimensies — centrale tendens (waar de gegevens gecentreerd zijn), spreiding (hoeveel de gegevens variëren) en vorm (hoe de gegevens verdeeld zijn).
In plaats van gevolgtrekkingen of voorspellingen te doen, beschrijft beschrijvende statistiek eenvoudigweg wat al in de gegevens aanwezig is. Ze is doorgaans de eerste stap in elk statistisch onderzoek — en geeft u een helder, objectief inzicht in uw dataset voordat u geavanceerdere technieken toepast.
Wanneer gebruikt u beschrijvende statistiek?
- Gebruik ze als eerste stap in elke data-analyse — om de basisstructuur en het gedrag van uw dataset te begrijpen voordat u een andere tool toepast.
- Gebruik ze wanneer u gegevens helder moet samenvatten en communiceren aan een team, manager of belanghebbende die een beknopt numeriek overzicht nodig heeft.
- Gebruik ze wanneer u meerdere groepen of datasets vergelijkt — beschrijvende statistiek per groep toont verschillen in centrum en spreiding in één oogopslag.
- Gebruik ze om te controleren op uitschieters, scheefheid of ongewone patronen voordat u verdergaat met formele statistische analyse.
Belangrijke statistieken uitgelegd
Statistiek
Wat zij u vertelt
Gemiddelde
Het rekenkundig gemiddelde — het evenwichtspunt van alle metingen
Mediaan
De middelste waarde — minder beïnvloed door uitschieters dan het gemiddelde
Standaardafwijking
Hoeveel metingen doorgaans rond het gemiddelde spreiden
Variantie
De gekwadrateerde spreiding — gebruikt in verdere statistische berekeningen
Minimum / maximum
De kleinste en grootste waarden die in de dataset zijn waargenomen
Spreidingsbreedte
De totale spreiding van de minimum- tot de maximumwaarde
Scheefheid
Of de gegevens naar links (negatief) of naar rechts (positief) van het centrum overhellen
Kurtosis
Of de verdeling zwaardere of lichtere staarten heeft dan de normale verdeling
N (steekproefomvang)
Het totale aantal waarnemingen dat in de analyse is opgenomen
Richtlijnen voor correct gebruik van beschrijvende statistiek
- Rapporteer altijd zowel een maat voor het centrum als een maat voor de spreiding samen — alleen het gemiddelde rapporteren zonder de standaardafwijking geeft een onvolledig beeld.
- Wanneer gegevens scheef zijn of uitschieters bevatten, gebruik dan de mediaan in plaats van het gemiddelde als primaire maat voor het centrum — die is representatiever.
- Controleer de waarden van scheefheid en kurtosis om te beoordelen of normaliteit kan worden aangenomen voordat u parametrische statistische methoden toepast.
- Verzamel minstens 20 tot 30 waarnemingen zodat statistieken zoals de standaardafwijking en scheefheid stabiel en betekenisvol zijn.
Alternatieven: wanneer u beschrijvende statistiek niet gebruikt
Situatie
Gebruik in plaats daarvan
Visuele vorm van de verdeling nodig naast de cijfers
Grafische samenvatting
Toetsen op significante verschillen tussen groepen
Hypothesetoetsen (t-toets, ANOVA)
Relaties tussen variabelen begrijpen
Correlatie- of regressieanalyse
De gegevens zijn categorisch (labels, groepen)
Staafdiagram
Trends of verschuivingen in de tijd detecteren
Verloopkaart of regelkaart
Voorbeeld van beschrijvende statistiek
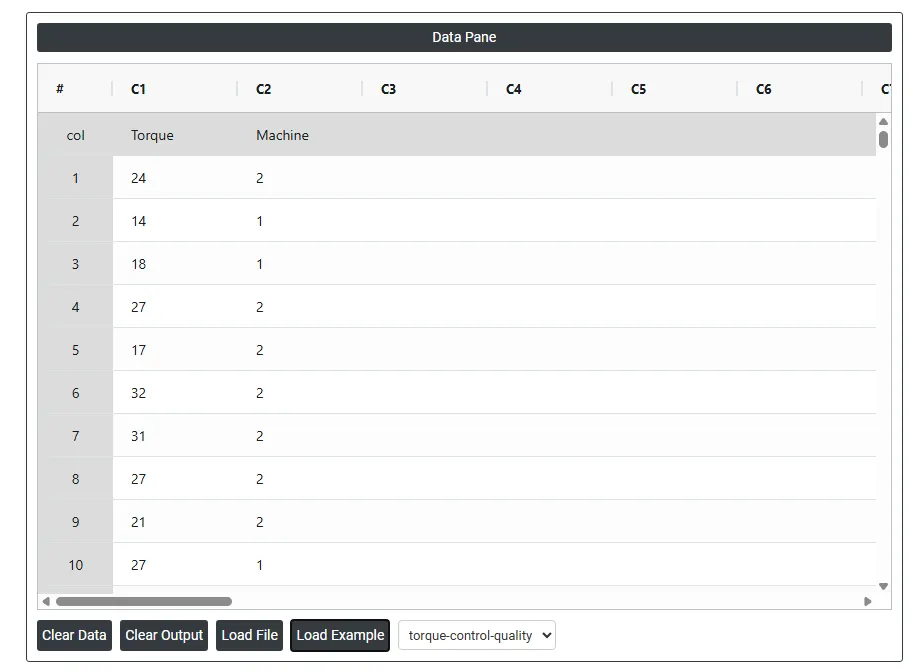
Een kwaliteitsingenieur moet ervoor zorgen dat de doppen op shampooflessen correct zijn vastgedraaid. Als de doppen te los zitten, kunnen ze tijdens het transport eraf vallen. Als ze te strak zitten, zijn ze te moeilijk te verwijderen. De streefwaarde voor het koppel waarmee de doppen worden vastgedraaid is 18. De ingenieur neemt een aselecte steekproef van 68 flessen en test het koppel dat nodig is om de doppen te verwijderen. De volgende stappen:
- De benodigde gegevens verzameld.
- Analyseer de gegevens nu in Zometric Statistical Software op https://statsai.zometric.com/.
- Om Descriptive Statistics te vinden, kiest u Statistical module> Graphical analysis > Descriptive Statistics.
- Voer in de tool de gegevens en de overige invoer als volgt in:
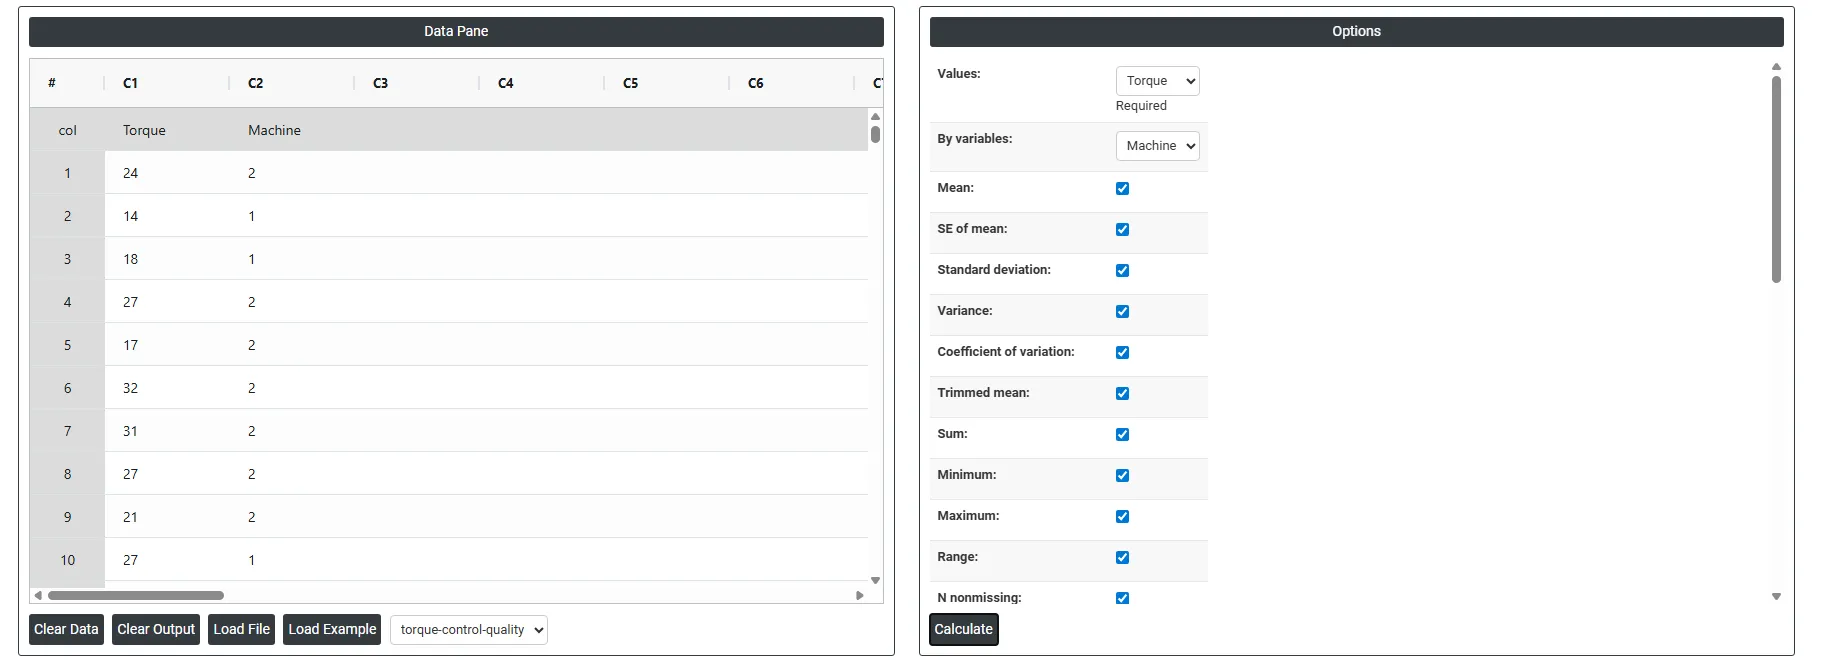
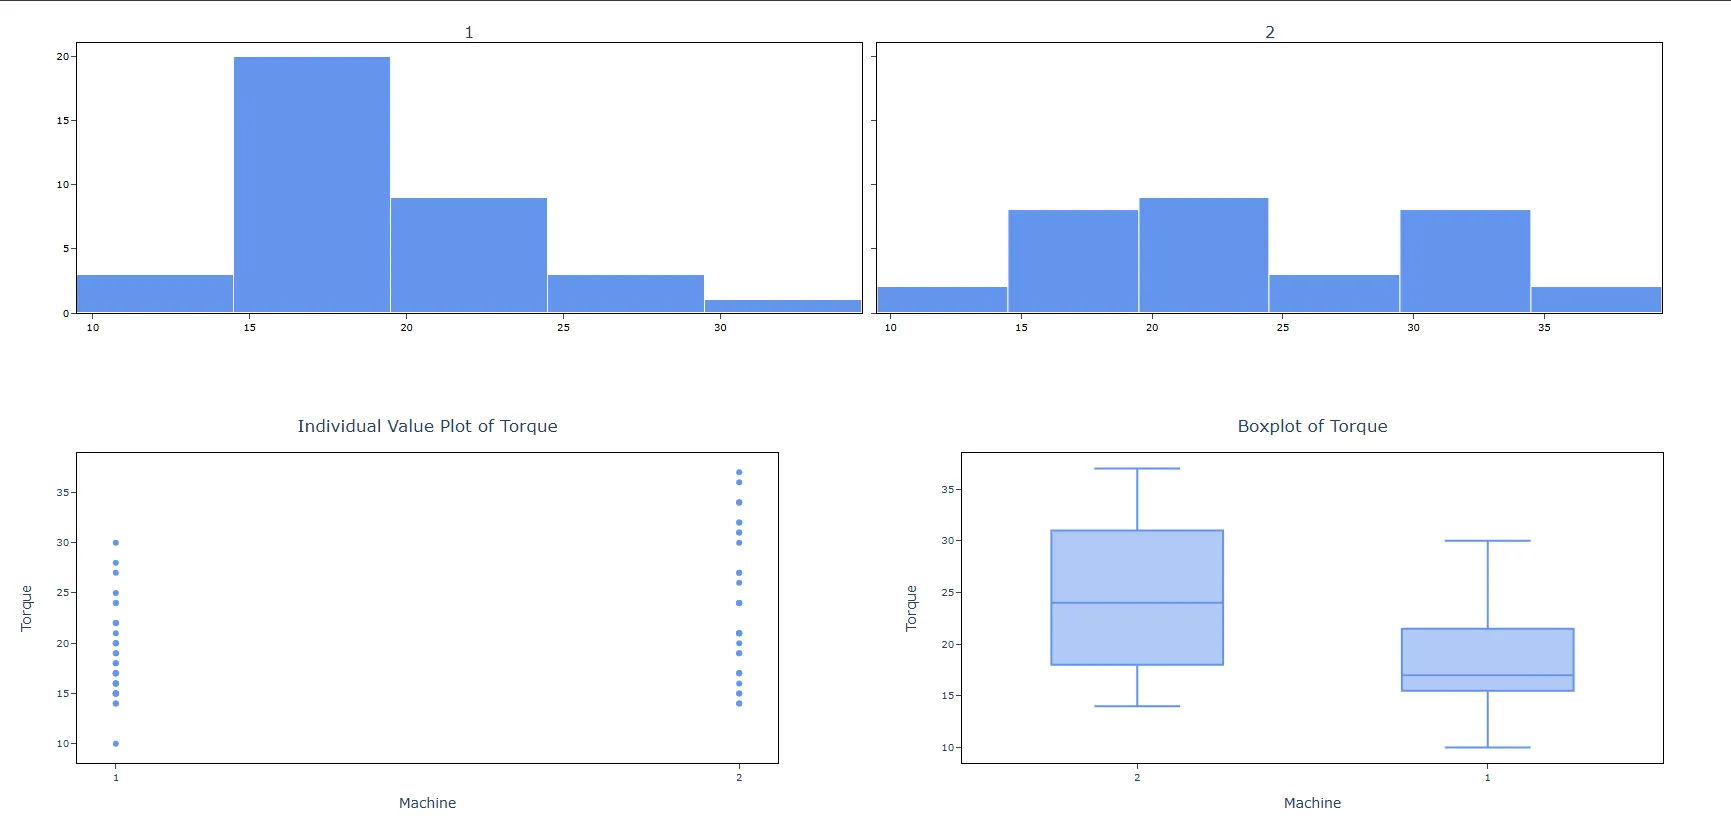
6. Na gebruik van de bovengenoemde tool wordt de uitvoer als volgt weergegeven:
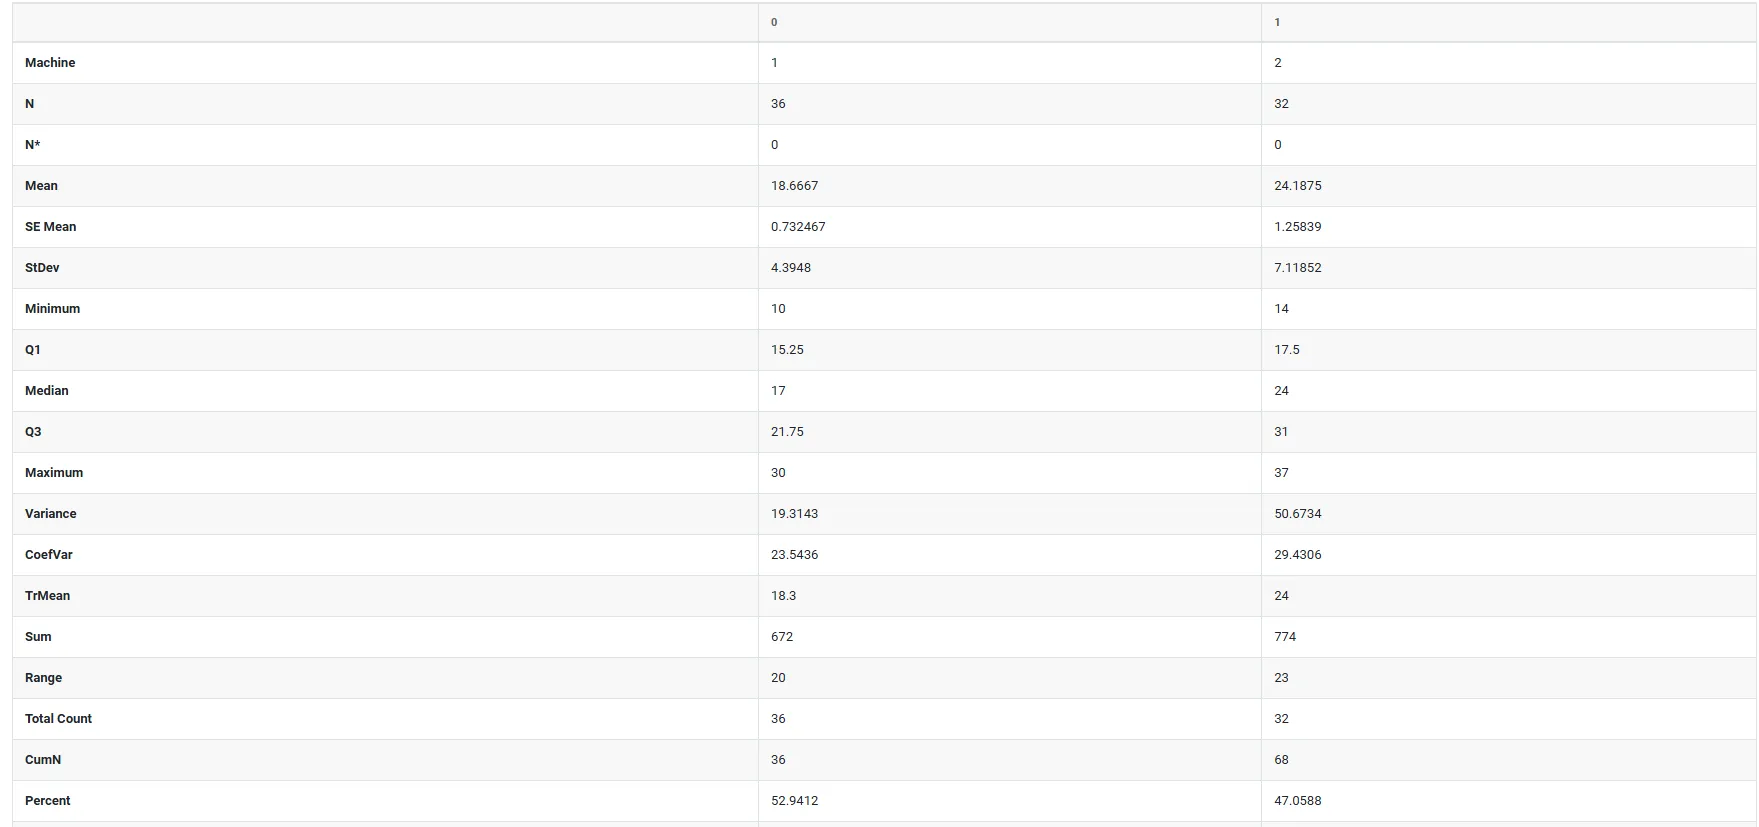
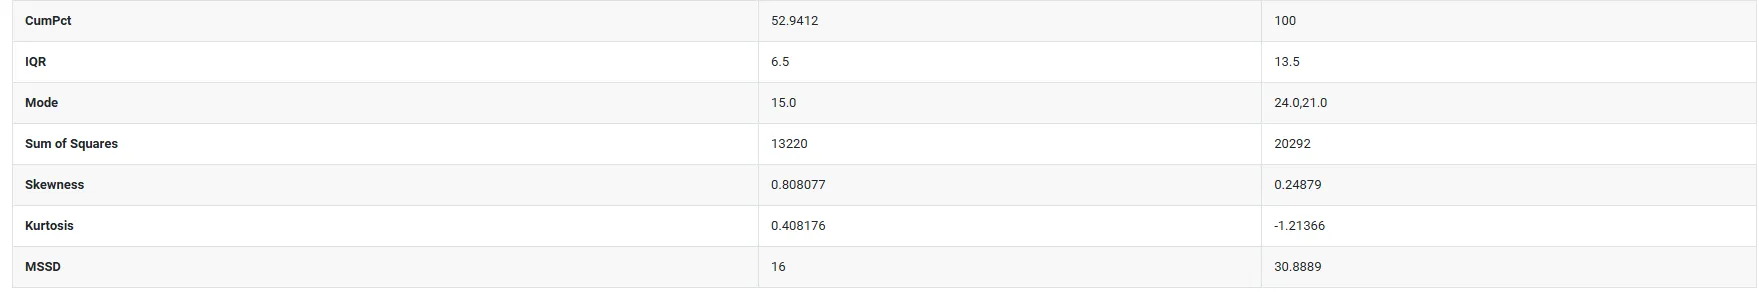
Zo voert u beschrijvende statistiek uit
De handleiding is als volgt:
- Meld u aan bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Graphical analysis > Descriptive Statistics.
- Werk vervolgens de gegevens handmatig bij, of kopieer (Ctrl+C) de gegevens volledig uit een Excel-blad of plak (Ctrl+V) ze, of gebruik de optie Load Example, waarmee de voorbeeldgegevens worden geladen.
- Vul vervolgens de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
Op het dashboard van Descriptive Statistics is het venster in twee delen verdeeld.
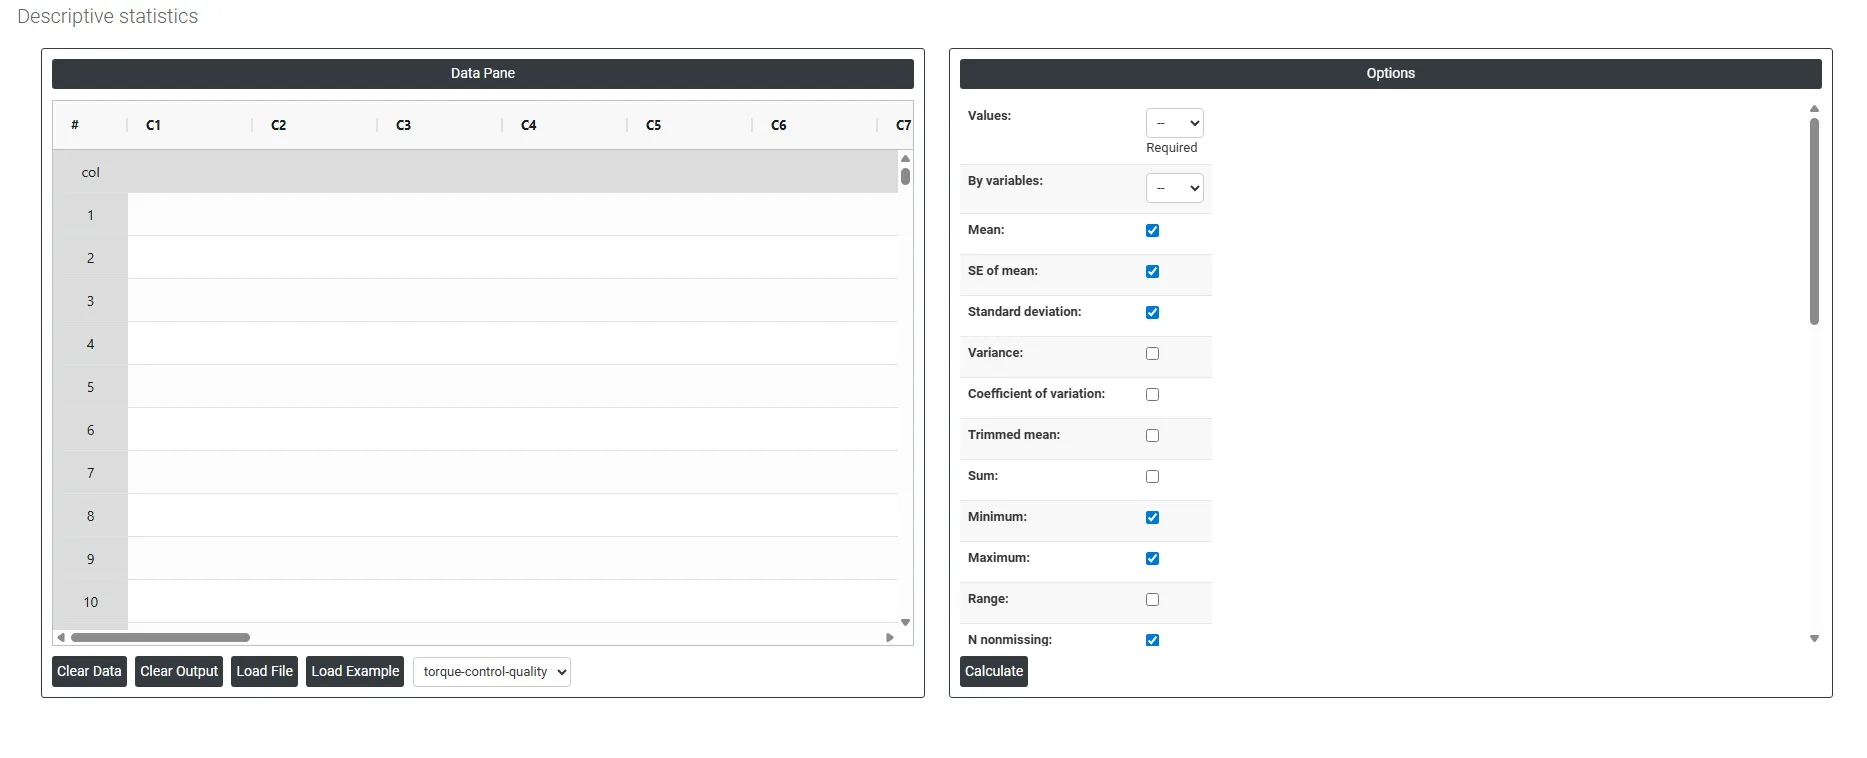
Links bevindt zich het Data Pane. In het Data Pane vormt elke rij één subgroep. Gegevens kunnen handmatig worden ingevoerd, of u kunt de gegevens volledig kopiëren (Ctrl+C) uit een Excel-blad en hier plakken (Ctrl+V).
Load example: Er worden voorbeeldgegevens geladen.
Load File: Hiermee laadt u Excel-gegevens rechtstreeks.
Rechts hoeft u alleen het volgende op te geven:
Values: De variabele(n) met de werkelijke gegevens die u wilt analyseren, bijvoorbeeld koppelmetingen of machine; selecteer dus de kolom.
By Variables: Een optionele groeperingsvariabele. Indien geselecteerd, worden de statistieken voor elke groep afzonderlijk berekend (bijv. per machinetype), zodat u groepen naast elkaar kunt vergelijken.
Mean: Het rekenkundig gemiddelde. Tel alle waarden op en deel door het aantal. De meest gebruikelijke manier om samen te vatten waar uw gegevens liggen.
SE of mean (Standard Error of the Mean): Schat hoeveel uw steekproefgemiddelde kan afwijken van het werkelijke populatiegemiddelde. Een kleine SE betekent dat uw schatting van het gemiddelde betrouwbaar is; een grote SE betekent meer onzekerheid.
Trimmed mean: Het gemiddelde berekend nadat een klein percentage van de laagste en hoogste waarden is verwijderd. Dit verkleint de invloed van extreme uitschieters en geeft een stabielere schatting van het centrum.
Median: De middelste waarde wanneer alle datapunten op volgorde zijn gesorteerd. De helft van de waarden ligt erboven, de helft eronder. Betrouwbaarder dan het gemiddelde wanneer gegevens scheef zijn of uitschieters bevatten.
Mode: De waarde die het vaakst in de dataset voorkomt. Nuttig om de meest voorkomende meting of categorie te bepalen.
Sum: Het totaal van alle opgetelde waarden. Nuttig wanneer het cumulatieve bedrag telt, niet alleen het gemiddelde.
Standard deviation: Meet de gemiddelde afstand van elk datapunt tot het gemiddelde. Een kleine waarde betekent dat de gegevens dicht bij elkaar liggen; een grote waarde betekent dat ze wijd gespreid zijn.
Variance: De gekwadrateerde standaardafwijking. Minder intuïtief om rechtstreeks te interpreteren, maar ze wordt achter de schermen in veel statistische berekeningen en toetsen gebruikt.
Coefficient of variation (CV): Drukt de standaardafwijking uit als percentage van het gemiddelde (SD ÷ gemiddelde × 100). Hiermee kunt u de variabiliteit vergelijken tussen datasets met verschillende eenheden of sterk verschillende gemiddelde groottes.
Range: De eenvoudigste spreidingsmaat: maximum min minimum. Gemakkelijk te begrijpen, maar zeer gevoelig voor één extreme waarde.
Interquartile range (IQR): De spreiding van de middelste 50% van uw gegevens (Q3 min Q1). Omdat de bovenste en onderste 25% worden genegeerd, is ze bestand tegen uitschieters en een betrouwbare maat voor de typische spreiding.
MSSD (Mean of Successive Squared Differences): Meet de variabiliteit tussen opeenvolgende datapunten in de volgorde waarin ze zijn verzameld. Vooral nuttig bij procesbewaking en tijdreeksgegevens om te detecteren of een proces instabiel is of in de tijd driftt.
Sum of squares: De som van elke gekwadrateerde waarde. Op zichzelf niet rechtstreeks interpreteerbaar, maar een belangrijke bouwsteen die intern wordt gebruikt in berekeningen van variantie, regressie en ANOVA.
Minimum: De kleinste waarde in de hele dataset.
Maximum: De grootste waarde in de hele dataset.
First quartile (Q1): Het 25e percentiel. Een kwart van alle waarden ligt op of onder dit punt.
Third quartile (Q3): Het 75e percentiel. Driekwart van alle waarden ligt op of onder dit punt.
N nonmissing: Het aantal datapunten met een geldige geregistreerde waarde die in de analyse zijn opgenomen.
N missing: Het aantal datapunten zonder waarde (leeg of null). Veel ontbrekende waarden kunnen op een probleem bij de gegevensverzameling wijzen.
N total: Het totale aantal rijen = N nonmissing + N missing.
Cumulative N: Een lopend totaal van waarnemingen terwijl u door de rijen of groepen naar beneden gaat.
Percent: Het aantal van elke groep uitgedrukt als percentage van het totale aantal waarnemingen.
Cumulative Percent: Een lopend totaal van percentages. De laatste rij bereikt altijd 100%.
Skewness: Meet hoe asymmetrisch de verdeling rond het gemiddelde is.
- Nul = perfect symmetrisch
- Positief = de staart strekt zich naar rechts uit (een paar zeer hoge waarden trekken het gemiddelde omhoog)
- Negatief = de staart strekt zich naar links uit (een paar zeer lage waarden trekken het gemiddelde omlaag)
Kurtosis: Meet hoe zwaar of licht de staarten van de verdeling zijn in vergelijking met een normale (klokvormige) verdeling.
- Hoge kurtosis = meer extreme uitschieters dan verwacht
- Lage kurtosis = minder extreme waarden, vlakkere verdeling
Histogram of data: Een staafdiagram dat toont hoe vaak waarden binnen gedefinieerde intervallen (klassen) vallen. Het best om de algehele vorm te zien: of de gegevens normaal, scheef, bimodaal enzovoort zijn.
Individual value plot: Zet elk datapunt als afzonderlijke stip op een getallenlijn uit. Niets wordt verborgen of gemiddeld. Het best om uitschieters op te sporen en de ware ruwe spreiding van uw gegevens te zien.
Boxplot of data: Een box-and-whiskerdiagram dat de mediaan, Q1, Q3 en uitschieters samenvat in één compact beeld. Uitstekend om de spreiding en het centrum van meerdere groepen naast elkaar te vergelijken.
Show variables as columns: Transponeert de resultatentabel zodat elke variabele een kolom wordt in plaats van een rij. Vooral nuttig wanneer u veel variabelen vergelijkt en ze naast elkaar wilt hebben voor een eenvoudige vergelijking.
Download as Excel: Hiermee wordt het resultaat in Excel-formaat weergegeven, dat u eenvoudig kunt bewerken en met de optie Load File opnieuw kunt laden voor berekeningen.
Veelgestelde vragen
Wat is beschrijvende statistiek?
Beschrijvende statistiek bestaat uit numerieke samenvattingen van de belangrijkste kenmerken van een dataset in drie dimensies: centrale tendens (waar de gegevens gecentreerd zijn), spreiding (hoeveel ze variëren) en vorm (hoe ze verdeeld zijn). Ze beschrijft wat al in de gegevens zit in plaats van gevolgtrekkingen te maken en is doorgaans de eerste stap in elk statistisch onderzoek.
Gebruikt u het gemiddelde of de mediaan?
Wanneer gegevens scheef zijn of uitschieters bevatten, gebruik dan de mediaan als primaire maat voor het centrum, omdat die minder door extreme waarden wordt beïnvloed dan het gemiddelde. Rapporteer altijd een maat voor het centrum samen met een maat voor de spreiding; alleen het gemiddelde rapporteren zonder de standaardafwijking geeft een onvolledig beeld.
Wat vertellen scheefheid en kurtosis u?
Scheefheid meet asymmetrie: nul is symmetrisch, positief betekent dat de staart zich naar rechts uitstrekt en negatief dat die zich naar links uitstrekt. Kurtosis vergelijkt de zwaarte van de staarten met een normale verdeling: hoge kurtosis betekent meer extreme uitschieters dan verwacht, lage kurtosis minder. Controleer beide om te beoordelen of normaliteit kan worden aangenomen voordat u parametrische methoden gebruikt.
Hoeveel waarnemingen hebt u nodig voor beschrijvende statistiek?
Verzamel minstens 20 tot 30 waarnemingen zodat statistieken zoals de standaardafwijking en scheefheid stabiel en betekenisvol zijn. Selecteer in Zometric Statistical Software de kolom Values, eventueel een By-variabele om groepen naast elkaar te vergelijken, en vink de statistieken en grafieken aan die u nodig hebt, zoals een histogram, plot van individuele waarden of boxplot.