
Beschrijvende statistiek (tabellen)
Kies numerieke variabelen en optionele groepeervariabelen voor rijen en kolommen, en kies uit negen statistieken: N, gemiddelde, standaardfout van het gemiddelde, standaardafwijking, minimum, eerste kwartiel, mediaan, derde kwartiel en maximum. Ontbrekende waarden blijven buiten beschouwing. Gebruik de tabel om subgroepen te vergelijken, zoals vulgewichten per vulmachine en ploeg. Ze beschrijft de gegevens en toetst niet of verschillen echt zijn.
Laatst beoordeeld
Belangrijkste conclusie
Descriptive Statistics (Tables) vat een of meer numerieke kolommen samen in één tabel, uitgesplitst naar maximaal twee groepeerkolommen, zodat veel subgroepen naast elkaar kunnen worden vergeleken voordat u nader kijkt.
Op deze pagina
Doel
Descriptive Statistics (Tables) vat een of meer numerieke kolommen samen in één tabel, uitgesplitst naar maximaal twee groepeerkolommen: één langs de zijkant van de tabel en één bovenaan. Voor elke variabele kiest u welke statistieken worden getoond: aantal, gemiddelde, standaardfout van het gemiddelde, standaardafwijking, minimum, kwartielen, mediaan en maximum. Gebruik de tabel om veel subgroepen naast elkaar te zetten voordat u beslist waar u nader gaat kijken, bijvoorbeeld vulgewichten per vulmachine en ploeg, cyclustijden per lijn en product, of testresultaten per leverancier en partij. Ze beschrijft de gegevens; ze toetst niet of de verschillen echt zijn.
Belangrijkste mogelijkheden
- Meerdere numerieke variabelen in één tabel, elk met een eigen blok statistieken.
- Uitsplitsing naar een rijvariabele, een kolomvariabele of beide: de groepen van de rijvariabele lopen langs de tabel en die van de kolomvariabele erboven, zoals in Minitab.
- Negen statistieken om uit te kiezen; N, Mean, Standard deviation, Minimum, Median en Maximum zijn standaard aangevinkt.
- Ontbrekende waarden in een variabele blijven buiten de statistieken van die variabele.
- Pdf-export via Download.
Statistische methoden
De gegevens worden gesplitst naar de niveaus van de rijvariabele en de kolomvariabele (indien opgegeven), en de statistieken worden afzonderlijk berekend binnen elke groep en voor elke variabele, nadat ontbrekende en niet-numerieke waarden zijn weggelaten. Groepen verschijnen in gesorteerde volgorde van de groeperingswaarden. Zonder groepeervariabele heeft de tabel één rij voor de hele kolom.
N is het aantal niet-ontbrekende waarden. Gemiddelde x̄ = Σx / N. De standaardafwijking s gebruikt de deler N − 1: s = √(Σ(x − x̄)² / (N − 1)). SE of mean = s / √N, de onzekerheid van het groepsgemiddelde. Minimum, Median en Maximum zijn de kleinste, middelste en grootste waarde. Het eerste en derde kwartiel zijn het 25e en 75e percentiel, bepaald door lineaire interpolatie tussen de gesorteerde waarden op positie 1 + (N − 1)·p, zodat ze licht kunnen afwijken van software die de regel (N + 1)·p gebruikt. Bij kleine groepen (minder dan ongeveer 10 waarden) zijn de standaardafwijking en de kwartielen ruw, dus lees ze met zorg.
Invoervelden en opties
Veld | Beschrijving |
Variables | Vereist. Een of meer numerieke kolommen om samen te vatten (houd Ctrl of Cmd ingedrukt om er meerdere te selecteren). |
For rows (optional) | Groepeerkolom. Elk niveau krijgt eigen rijen in de tabel. |
For columns (optional) | Tweede groepeerkolom. De niveaus worden de kolommen van de tabel, één per niveau; elke rij bevat dan één statistiek van één variabele (voor elk niveau van de rijvariabele, indien ingesteld). |
N / Mean / SE of mean / Standard deviation / Minimum / First quartile / Median / Third quartile / Maximum | Statistieken die voor elke variabele worden getoond. Standaard aangevinkt: N, Mean, Standard deviation, Minimum, Median en Maximum. Er moet er minimaal één zijn aangevinkt. |
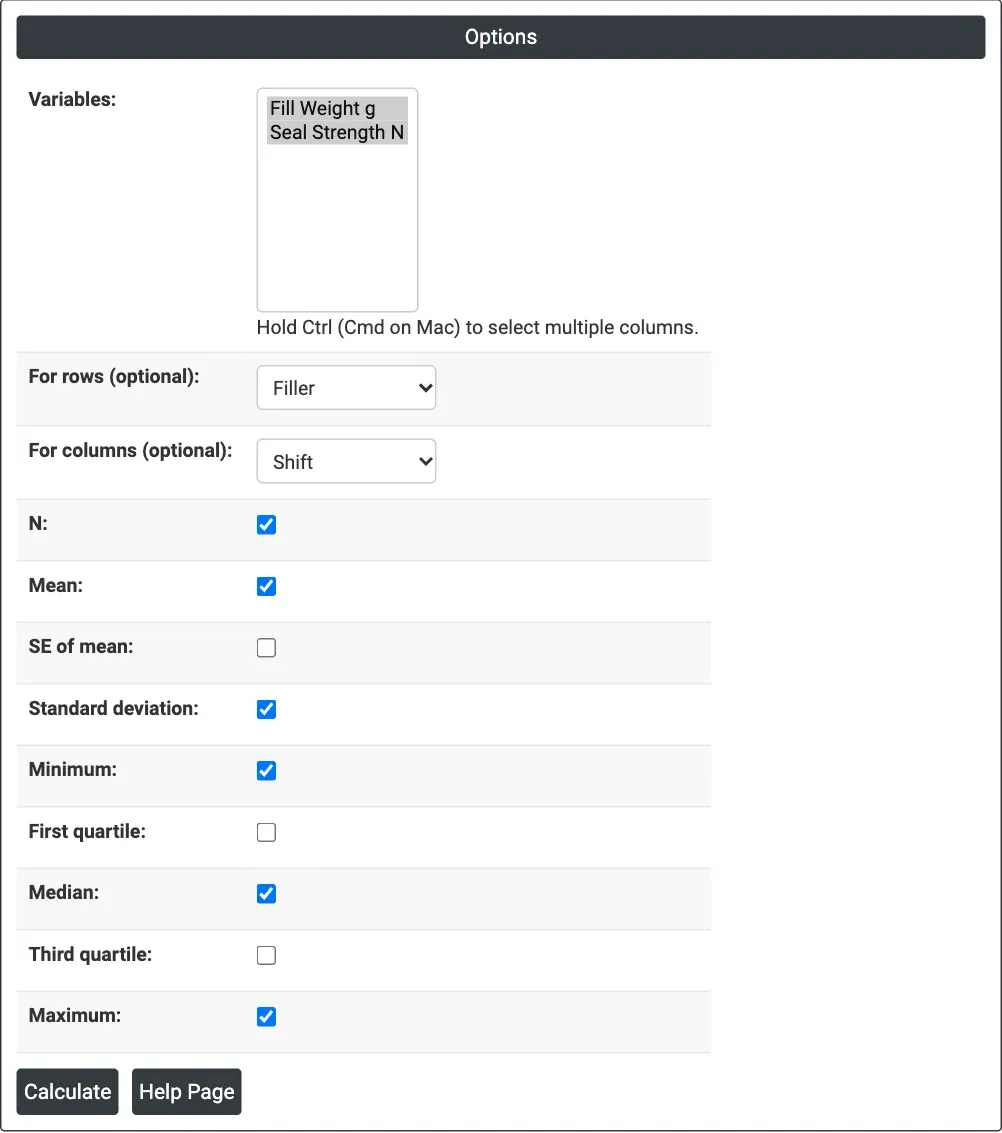
Figuur 1 — Fill Weight g en Seal Strength N samengevat per Filler (rijen) en Shift (kolommen) met de standaardstatistieken.
Beschrijving van de uitvoer
- Statistics table — met een kolomvariabele (met de kop “Rows: <row variable>; Columns: <column variable>”): eerst het niveau van de rijvariabele, Variable en Statistic, daarna één kolom per niveau van de kolomvariabele. Zonder kolomvariabele: één rij per groep van de rijvariabele (of in totaal één rij), daarna één kolom per variabele en statistiek, genaamd Variable_Statistic, bijv. Fill Weight g_Mean, Seal Strength N_StDev (Q1, Q3 en SE Mean voor de optionele statistieken).
- Pdf-export via Download.
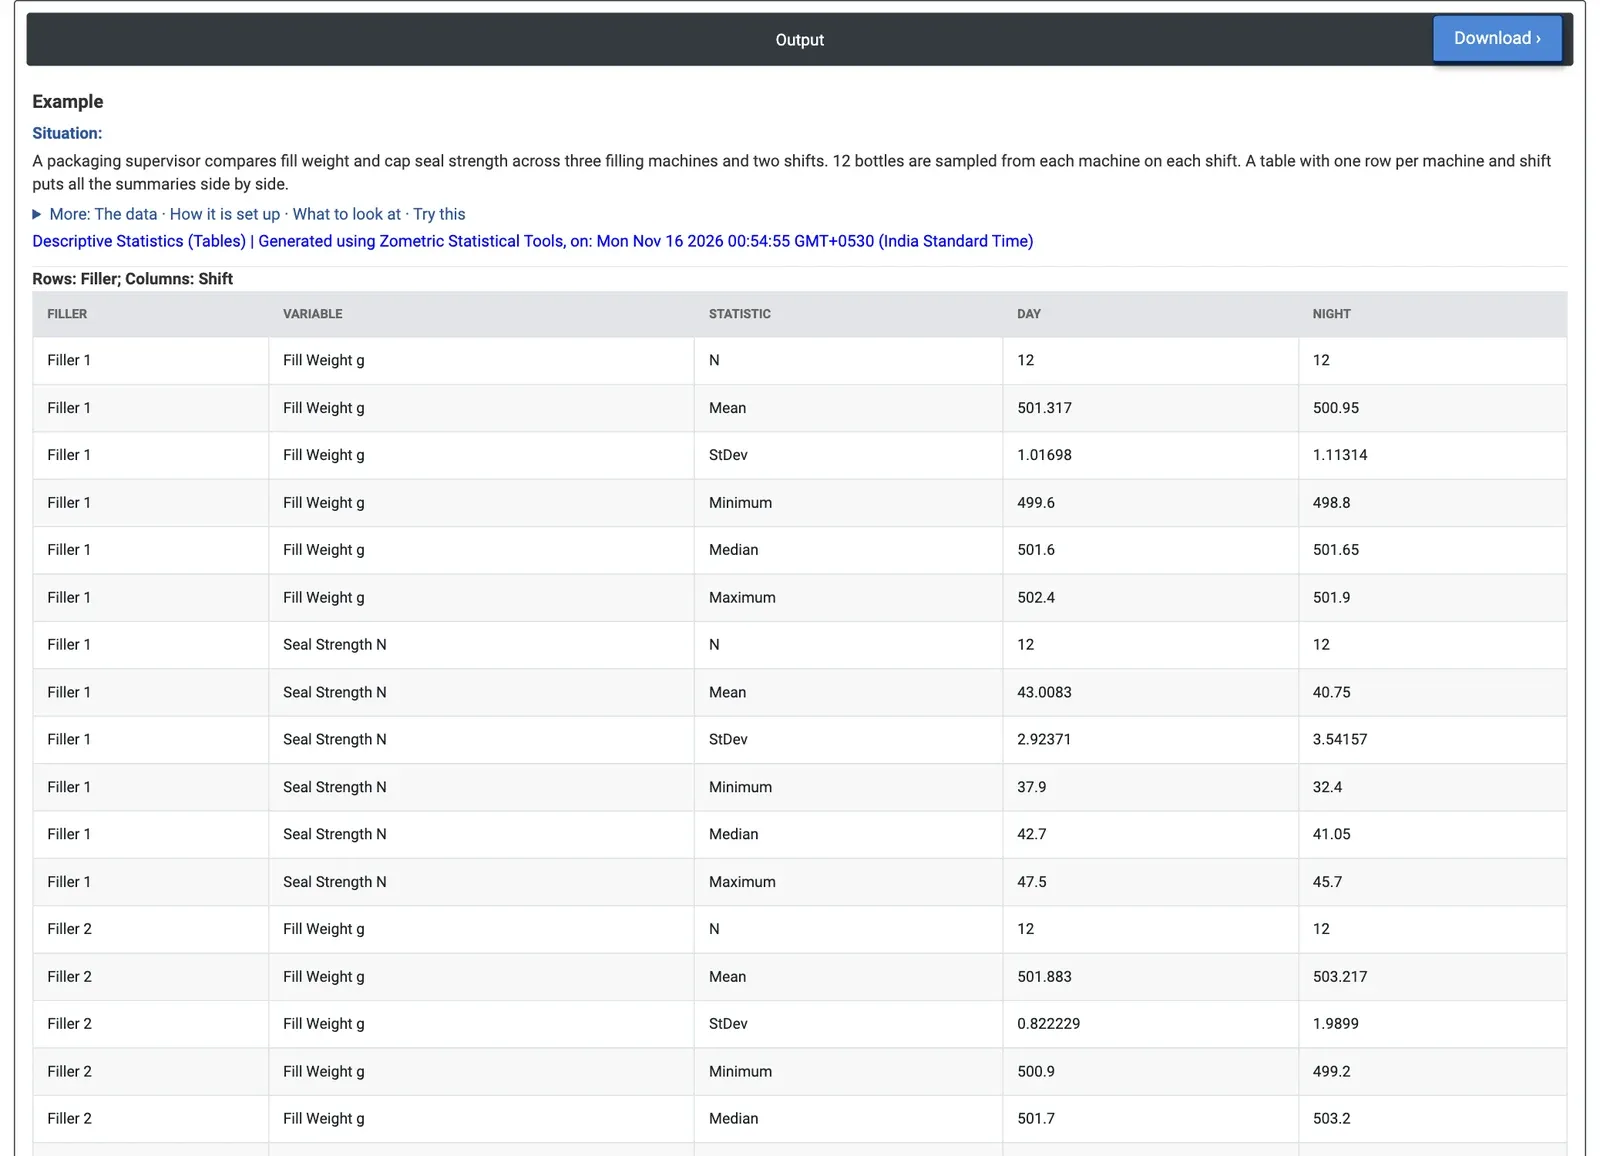
Figuur 2 — Vulmachines langs de zijkant en ploegen bovenaan: de zegelsterkte is lager in de nachtploeg voor alle drie de vulmachines, en Filler 2 vult in de nachtploeg het zwaarst en het meest variabel.
Uitgewerkt voorbeeld
Een verpakkingssupervisor vergelijkt drie vulmachines over twee ploegen. Van elke vulmachine worden in elke ploeg twaalf flessen bemonsterd (72 in totaal), en van elke fles worden het vulgewicht (g) en de zegelsterkte van de dop (N) gemeten. De supervisor selecteert Variables = Fill Weight g en Seal Strength N, For rows = Filler en For columns = Shift, en houdt de standaardstatistieken aan.
De zegelsterkte is in de nachtploeg lager voor elke vulmachine: gemiddelden van 40.75, 38.93 en 38.66 N 's nachts tegenover 43.01, 43.38 en 43.23 N overdag. Het patroon is bij alle drie de machines gelijk, wat wijst op iets bij de ploeg (bemanning, doppartij, aanhaalmoment) in plaats van op één machine. Het vulgewicht vertelt een ander verhaal: Filler 2 draait in de nachtploeg het zwaarst (gemiddelde 503.22 g) en is het meest variabel (standaardafwijking 1.99 g, spreidingsbreedte 499.2 tot 506.2 g), terwijl Filler 3 in beide ploegen het lichtst draait (499.67 en 499.61 g).
Voor een beeld op ploegniveau levert For rows = Shift zonder kolomvariabele, met First quartile en Third quartile aangevinkt, gemiddelde zegelsterktes op van 43.21 N overdag en 39.44 N 's nachts, waarbij de middelste helft van de nachtflessen tussen 37.15 en 41.18 N ligt. De tabel laat zien waar u moet kijken; om te controleren of de verschillen tussen ploegen en vulmachines groter zijn dan toeval, voert de supervisor een tweewegsvariantieanalyse (ANOVA) uit op Seal Strength N met Filler en Shift als factoren.
Veelgestelde vragen
Wanneer gebruikt u tabellen met beschrijvende statistiek?
Gebruik ze om veel subgroepen naast elkaar te zetten voordat u beslist waar u nader gaat kijken, bijvoorbeeld vulgewichten per vulmachine en ploeg, cyclustijden per lijn en product, of testresultaten per leverancier en partij. Eén groepeervariabele loopt langs de zijkant van de tabel en een tweede kan bovenaan lopen.
Hoe worden de kwartielen berekend?
Het eerste en derde kwartiel zijn het 25e en 75e percentiel, bepaald door lineaire interpolatie tussen de gesorteerde waarden op positie 1 + (N − 1)·p, zodat ze licht kunnen afwijken van software die de regel (N + 1)·p gebruikt. Bij kleine groepen van minder dan ongeveer 10 waarden zijn de standaardafwijking en de kwartielen ruw, dus lees ze met zorg.
Toetst een tabel met beschrijvende statistiek of groepen verschillen?
Nee. Ze beschrijft de gegevens maar toetst niet of de verschillen echt zijn. In het uitgewerkte voorbeeld toonde de tabel een lagere zegelsterkte in de nachtploeg voor alle drie de vulmachines; om te controleren of de verschillen tussen ploegen en vulmachines groter waren dan toeval, voerde de supervisor een tweewegsvariantieanalyse (ANOVA) uit.
Hoe stelt u de tabel in Zometric Statistical Software in?
Selecteer een of meer numerieke Variables, optioneel een kolom bij For rows en een kolom bij For columns, en vink de te tonen statistieken aan. N, Mean, Standard deviation, Minimum, Median en Maximum zijn standaard aangevinkt, en er moet er minimaal één zijn aangevinkt. De standaardafwijking gebruikt de deler N − 1 en ontbrekende waarden blijven buiten beschouwing.