
Discriminantanalyse (Discriminant Analysis)
Geef items met een bekende groep en numerieke voorspellers op. Lineaire discriminantanalyse veronderstelt multivariaat normaal verdeelde voorspellers met een gemeenschappelijke covariantiematrix; kwadratische staat er één per groep toe. A-priorikansen kunnen gelijk, proportioneel of door de gebruiker opgegeven zijn. De uitvoer bevat verwarringsmatrices, de totale en met leave-one-out gevalideerde nauwkeurigheid en lineaire classificatiefuncties om nieuwe items te scoren. Gebruik het om te controleren of een kwaliteitsklasse uit inspectiegegevens is te herkennen.
Laatst beoordeeld
Belangrijkste conclusie
Discriminant Analysis bouwt een regel die items op basis van gemeten waarden aan bekende groepen toewijst, vindt de combinatie van metingen die de groepen het best scheidt en rapporteert hoeveel items correct worden geclassificeerd.
Op deze pagina
Doel
Discriminant Analysis bouwt een regel die items op basis van gemeten waarden aan bekende groepen toewijst. U geeft items op waarvan de groep bekend is (bijvoorbeeld Standard- en Premium-partijen, goede en slechte onderdelen of leveranciers) en de metingen die eraan zijn verricht; het vindt de combinatie van metingen die de groepen het best scheidt en toont hoeveel items de regel correct classificeert. Gebruik het om te controleren of een kwaliteitsklasse of type uit inspectiegegevens is te herkennen, of om een regel op te stellen voor het sorteren van nieuwe items.
Belangrijkste mogelijkheden
- Lineaire of kwadratische discriminantfuncties voor twee of meer groepen.
- A-priorikansen gelijk voor alle groepen, proportioneel aan de groepsgroottes, of door u ingesteld.
- Verwarringsmatrix van werkelijke tegenover voorspelde groep, met het totale percentage correct geclassificeerd.
- Leave-one-out-kruisvalidatie voor een eerlijker schatting van hoe de regel bij nieuwe items zal werken.
- Lineaire classificatiefuncties (constante en één coëfficiënt per voorspeller voor elke groep) om nieuwe items te scoren.
Statistische methoden
Rijen met een ontbrekende groep of een ontbrekende of niet-numerieke voorspeller worden weggelaten. De respons wordt als tekstlabel behandeld en groepen worden in alfabetische of numerieke volgorde weergegeven. Er moeten minimaal 2 groepen zijn en meer rijen dan het aantal voorspellers plus het aantal groepen.
Lineaire discriminantanalyse veronderstelt dat de voorspellers in elke groep een multivariate normale verdeling volgen met dezelfde covariantiematrix. Het schat het gemiddelde x̄g van elke groep en een gepoolde covariantiematrix S binnen de groepen, en geeft elke groep een score Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg), waarbij pg de a-priorikans van de groep is. Een item wordt toegewezen aan de groep met de hoogste score. De tabel Linear Discriminant (Classification) Functions toont voor elke groep de constante (−½ x̄gᵀ S⁻¹ x̄g + ln pg) en de coëfficiënten S⁻¹ x̄g. Kwadratische discriminantanalyse laat de aanname van gelijke covariantie vallen en schat voor elke groep een aparte covariantiematrix, wat gekromde grenzen oplevert; het vergt meer gegevens per groep en heeft geen eenvoudige classificatiefuncties.
A-priorikansen zijn standaard 1/k voor k groepen. Proportionele priors gebruiken het aandeel van elke groep in de gegevens, wat grotere groepen bevoordeelt. De resubstitutienauwkeurigheid classificeert dezelfde items als waarmee de regel is opgebouwd en is optimistisch. Leave-one-out-kruisvalidatie verwijdert elk item om de beurt, bouwt de regel op uit de rest en classificeert het verwijderde item, en is zo een betere indicatie van de nauwkeurigheid bij nieuwe items.
Invoervelden en opties
Veld | Beschrijving |
Response (grouping variable) | Verplicht. Categorische kolom met de bekende groep van elk item. |
Predictors | Eén of meer numerieke kolommen waarmee de groepen worden gescheiden. |
Discriminant function | Linear (standaard; gemeenschappelijke covariantiematrix) of Quadratic (één covariantiematrix per groep). |
Prior probabilities | All groups equal (standaard), Proportional to group sizes in the data of User-specified. |
Custom priors | Alleen gebruikt wanneer Prior probabilities op User-specified staat. Eén waarde per groep, gescheiden door komma's of spaties, in alfabetische of numerieke groepsvolgorde; allemaal positief en met som 1, bijv. 0.2, 0.5, 0.3. |
Cross-validate (leave-one-out) | Standaard aangevinkt. Voegt de gekruisvalideerde nauwkeurigheid en verwarringsmatrix toe. |
Title | Titel van de analyse. Standaard Discriminant Analysis. |
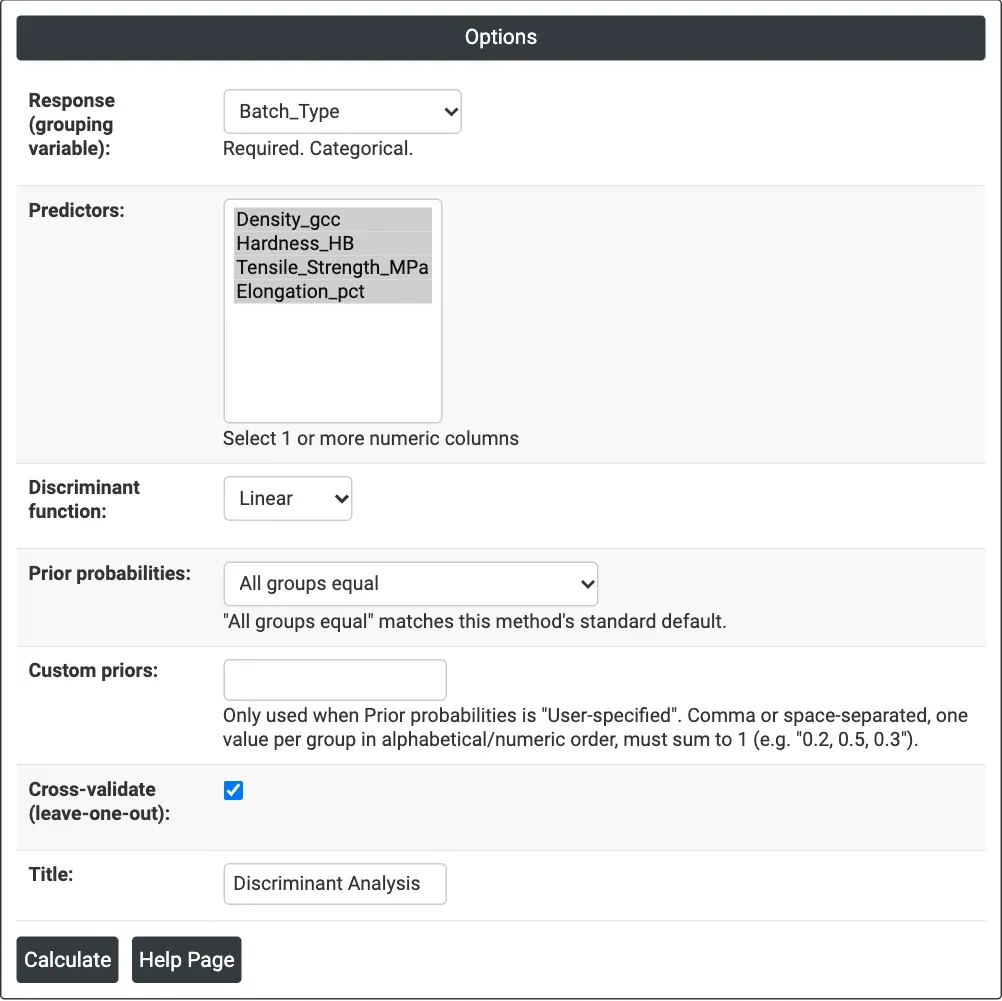
Figuur 1 — Opties voor het voorbeeld: Batch_Type als respons, vier eigenschapkolommen als voorspellers, lineaire functie, gelijke priors, leave-one-out-kruisvalidatie.
Beschrijving van de uitvoer
- Summary line — gebruikte N, resubstitutienauwkeurigheid en, indien aangevinkt, gekruisvalideerde (leave-one-out) nauwkeurigheid.
- Prior Probabilities — de gebruikte prior voor elke groep.
- Confusion Matrix (Resubstitution) — werkelijke groep in de rijen, voorspelde groep in de kolommen.
- Confusion Matrix (Cross-Validated) — hetzelfde met leave-one-out-voorspellingen.
- Linear Discriminant (Classification) Functions — alleen voor een lineaire functie: de constante en de coëfficiënt van elke voorspeller voor elke groep. Een nieuw item gaat naar de groep waarvan de functie de hoogste waarde geeft.
- PDF-export via Download.
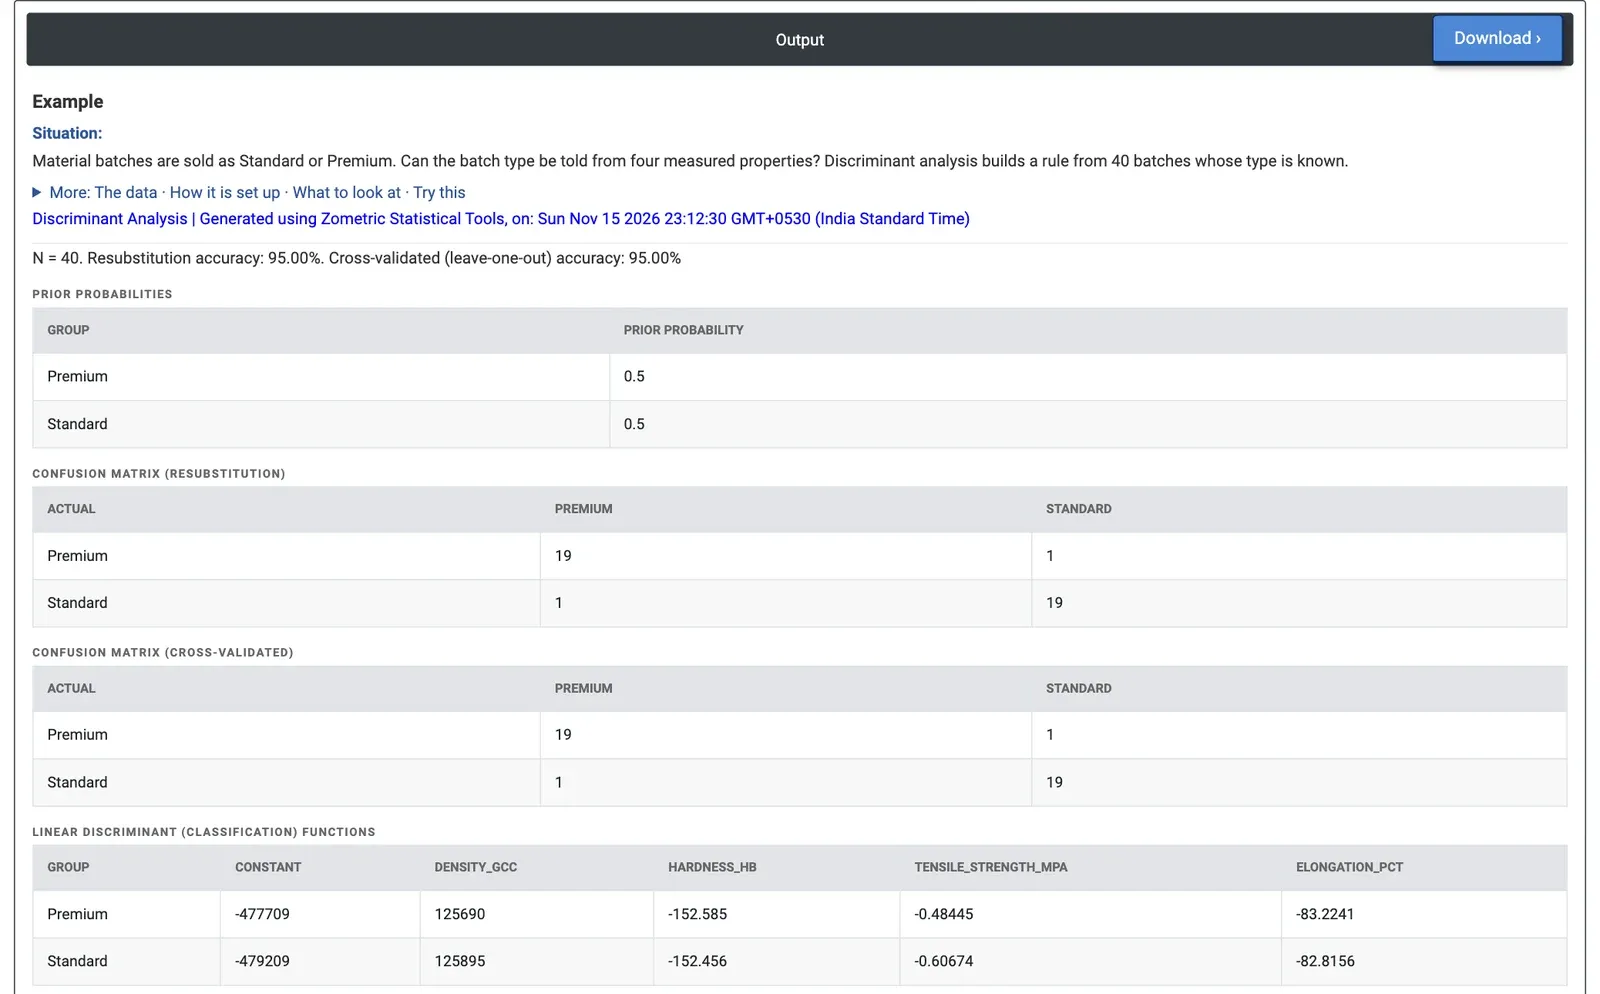
Figuur 2 — Resultaten voor 40 partijen: 95% correct geclassificeerd, zowel op de gegevens als met leave-one-out-kruisvalidatie; van elk type is één partij verkeerd geclassificeerd.
Uitgewerkt voorbeeld
Een materiaalfabriek verkoopt partijen als Standard of Premium. De kwaliteitsingenieur wil weten of het partijtype uit vier routinemetingen is af te leiden: dichtheid (g/cc), hardheid (HB), treksterkte (MPa) en rek (%). De ingenieur gebruikt 40 partijen waarvan het type bekend is, 20 van elk, en stelt Response (grouping variable) = Batch_Type in, de vier eigenschappen als Predictors, Discriminant function = Linear, Prior probabilities = All groups equal en Cross-validate aangevinkt.
De regel classificeert 38 van de 40 partijen correct: 95.00% op de gegevens en 95.00% met leave-one-out-kruisvalidatie, dus hij past zich niet alleen aan de 40 partijen aan waarmee hij is opgebouwd. Binnen elk type zijn 19 van de 20 correct. De twee verkeerd geclassificeerde partijen zijn rij 3 (Standard, 197.4 HB, 1,210.8 MPa) en rij 27 (Premium, 202.3 HB, 1,209.7 MPa): ze liggen tussen de groepsgemiddelden (Premium 212.9 HB en 1,253.6 MPa, Standard 180.1 HB en 1,126.2 MPa) en zijn een controle waard. De classificatiefuncties geven elke nieuwe partij op basis van haar vier metingen een Premium-score en een Standard-score, en de partij wordt toegewezen aan het type met de hogere score.
Dichtheid is belangrijker dan haar geringe spreiding doet vermoeden: het Premium-gemiddelde is 7.878 g/cc tegenover 7.850 voor Standard, en zonder dichtheid als voorspeller daalt de nauwkeurigheid tot 82.5% (75.0% gekruisvalideerd). Een kwadratische functie presteert hier slechter, met 92.5% op de gegevens en 85.0% gekruisvalideerd, omdat ze meer parameters schat uit slechts 20 partijen per groep. Voor de ingenieur is de lineaire regel op alle vier de eigenschappen goed genoeg om partijen te signaleren waarvan het label niet bij de metingen past. Vergeleken met het clusteren van dezelfde gegevens zonder de labels (Cluster K-Means komt voor 28 van de 40 met de typen overeen) geeft kennis van de groepen een veel duidelijkere scheiding.
Veelgestelde vragen
Wat is het verschil tussen lineaire en kwadratische discriminantanalyse?
Lineaire discriminantanalyse veronderstelt dat de voorspellers in elke groep multivariaat normaal verdeeld zijn met dezelfde covariantiematrix, en geeft lineaire classificatiefuncties. Kwadratische discriminantanalyse schat voor elke groep een aparte covariantiematrix, wat gekromde grenzen oplevert, maar vergt meer gegevens per groep en heeft geen eenvoudige classificatiefuncties. In het voorbeeld presteerde de kwadratische variant slechter met slechts 20 partijen per groep.
Waarom leave-one-out-kruisvalidatie gebruiken?
De resubstitutienauwkeurigheid classificeert dezelfde items als waarmee de regel is opgebouwd en is dus optimistisch. Leave-one-out-kruisvalidatie verwijdert elk item om de beurt, bouwt de regel op uit de rest en classificeert het verwijderde item, wat een betere indicatie van de nauwkeurigheid bij nieuwe items geeft. In het voorbeeld waren beide 95%, dus de regel paste zich niet alleen aan de eigen gegevens aan.
Hoe beïnvloeden a-priorikansen de discriminantanalyse?
Standaard krijgt elk van k groepen een prior van 1/k. Proportionele priors gebruiken het aandeel van elke groep in de gegevens, wat grotere groepen bevoordeelt. Door de gebruiker opgegeven priors moeten positief zijn, één per groep in alfabetische of numerieke groepsvolgorde, en som 1 hebben. De prior gaat via de natuurlijke logaritme van de prior in de score van elke groep.
Hoe classificeert u een nieuw item met discriminantanalyse?
Voor een lineaire discriminantfunctie toont Zometric Statistical Software in de tabel Linear Discriminant (Classification) Functions voor elke groep een constante en één coëfficiënt per voorspeller. Score het nieuwe item met de functie van elke groep en wijs het toe aan de groep waarvan de functie de hoogste waarde geeft.