
Dubbele exponentiële afvlakking
De methode van Holt werkt in elke periode een niveau bij met gewicht alpha en een trend met gewicht gamma, en voorspelt het niveau plus m maal de trend. Gewichten kunt u opgeven of leeg laten voor optimale ARIMA(0,2,2)-gewichten, die op redelijkheid moeten worden gecontroleerd. De uitvoer bevat voorspellingen met breder wordende voorspellingsgrenzen en MAPE, MAD en MSD. De reeks mag geen hiaten bevatten en heeft minstens 4 waarden nodig.
Laatst beoordeeld
Belangrijkste conclusie
Dubbele exponentiële afvlakking (methode van Holt) vlakt een tijdreeks af met een niveau en een trend, zodat voorspellingen doorlopen met de laatste trendsnelheid; gebruik haar voor reeksen met een gestage drift en zonder seizoenspatroon.
Op deze pagina
Doel
Dubbele exponentiële afvlakking (methode van Holt) vlakt een tijdreeks af met twee voortschrijdende componenten, een niveau en een trend, zodat haar voorspellingen blijven stijgen of dalen met de laatste trendsnelheid. Gebruik haar voor een reeks met een gestage opwaartse of neerwaartse drift en zonder seizoenspatroon, bijvoorbeeld cumulatieve slijtage, een vraag die maand na maand groeit, of een langzaam driftend procesgemiddelde. Gebruik voor gegevens met een seizoen de methode van Winters of Decompositie.
Belangrijkste mogelijkheden
- Niveaugewicht (alpha) en trendgewicht (gamma) die u opgeeft, of optimale gewichten uit een ARIMA(0,2,2)-fit wanneer beide leeg worden gelaten.
- Beginniveau en begintrend uit de gegevens of uit waarden die u invoert.
- Voorspellingen langs de laatste trend met voorspellingsgrenzen die met elke periode vooruit breder worden, vanaf het einde van de reeks of vanaf een eerdere rij.
- De nauwkeurigheidsmaten MAPE, MAD en MSD, en een plot van de gegevens, fits en voorspellingen.
- Optionele resultatentabel (niveau, trend, voorspelling en fout voor elke periode) en viervoudige residuenplots.
Statistische methoden
In elke periode worden het niveau en de trend bijgewerkt: Lₜ = α·yₜ + (1 − α)·(Lₜ₋₁ + Tₜ₋₁) en Tₜ = γ·(Lₜ − Lₜ₋₁) + (1 − γ)·Tₜ₋₁. De fit voor periode t is Lₜ₋₁ + Tₜ₋₁, en de voorspelling m perioden na de oorsprong is L + m·T, met het niveau en de trend bij de oorsprong. Een grotere α laat het niveau recente waarden nauwer volgen; een grotere γ laat de trend sneller veranderen.
Bij opgegeven gewichten zijn het beginniveau en de begintrend het snijpunt en de helling van een kleinstekwadratenlijn van de gegevens tegen de tijd. Wanneer de gewichten leeg blijven, fit de tool een ARIMA(0,2,2)-model aan de tweede verschillen met kleinste kwadraten en rekent ze de coëfficiënten om: α = 1 + θ₂ en γ = (2 − α − θ₁) / α; het beginniveau en de begintrend worden uit die fit teruggerekend. Optimale gewichten kunnen buiten 0 tot 1 vallen en moeten op redelijkheid worden gecontroleerd. Met Starting values = User-specified worden de door u ingevoerde Initial level en Initial trend gebruikt.
De voorspellingsgrenzen zijn voorspelling ± z × dₘ × MAD, waarbij z het kwantiel van de normale verdeling voor het betrouwbaarheidsniveau is, MAD de gemiddelde absolute fout van de fits is, en dₘ een factor is die groeit met het aantal perioden vooruit m (berekend uit de grootste van α en γ), zodat de band verderop in de toekomst breder wordt. Nauwkeurigheid: MAPE = gemiddelde |fout / gegeven| × 100, MAD = gemiddelde |fout|, MSD = gemiddelde fout². De reeks mag geen hiaten bevatten en moet minstens 4 waarden hebben.
Invoervelden en opties
Veld | Beschrijving |
Variable (Y) | Vereist. De numerieke reeks, in tijdsvolgorde. |
Level weight (alpha) / Trend weight (gamma) | 0.0001 tot 1. Laat beide leeg om de optimale ARIMA(0,2,2)-gewichten te gebruiken. |
Starting values | From the data (standaard): teruggerekend uit de ARIMA-fit (optimale gewichten) of uit de regressie van de gegevens op de tijd (opgegeven gewichten). Of User-specified. |
Initial level / Initial trend | Wordt gebruikt wanneer Starting values op User-specified staat; beide zijn dan vereist. |
Number of forecasts | Standaard 0 (geen), tot 1000. |
Confidence level (%) for forecast interval | Standaard 95. Actief wanneer voorspellingen worden gevraagd. |
Forecast origin (row) | Optioneel, actief wanneer voorspellingen worden gevraagd. Voorspellingen beginnen na deze rij, met de gegevens tot en met die rij; leeg = einde van de reeks. |
Results to display | Summary table (standaard) of Summary table and results table. |
Residual plots (four in one) | Standaard niet aangevinkt. Normale waarschijnlijkheidsplot, residuen tegen fits, histogram en residuen tegen volgorde. |
Title | Titel van de uitvoer. Standaard Double Exponential Smoothing. |
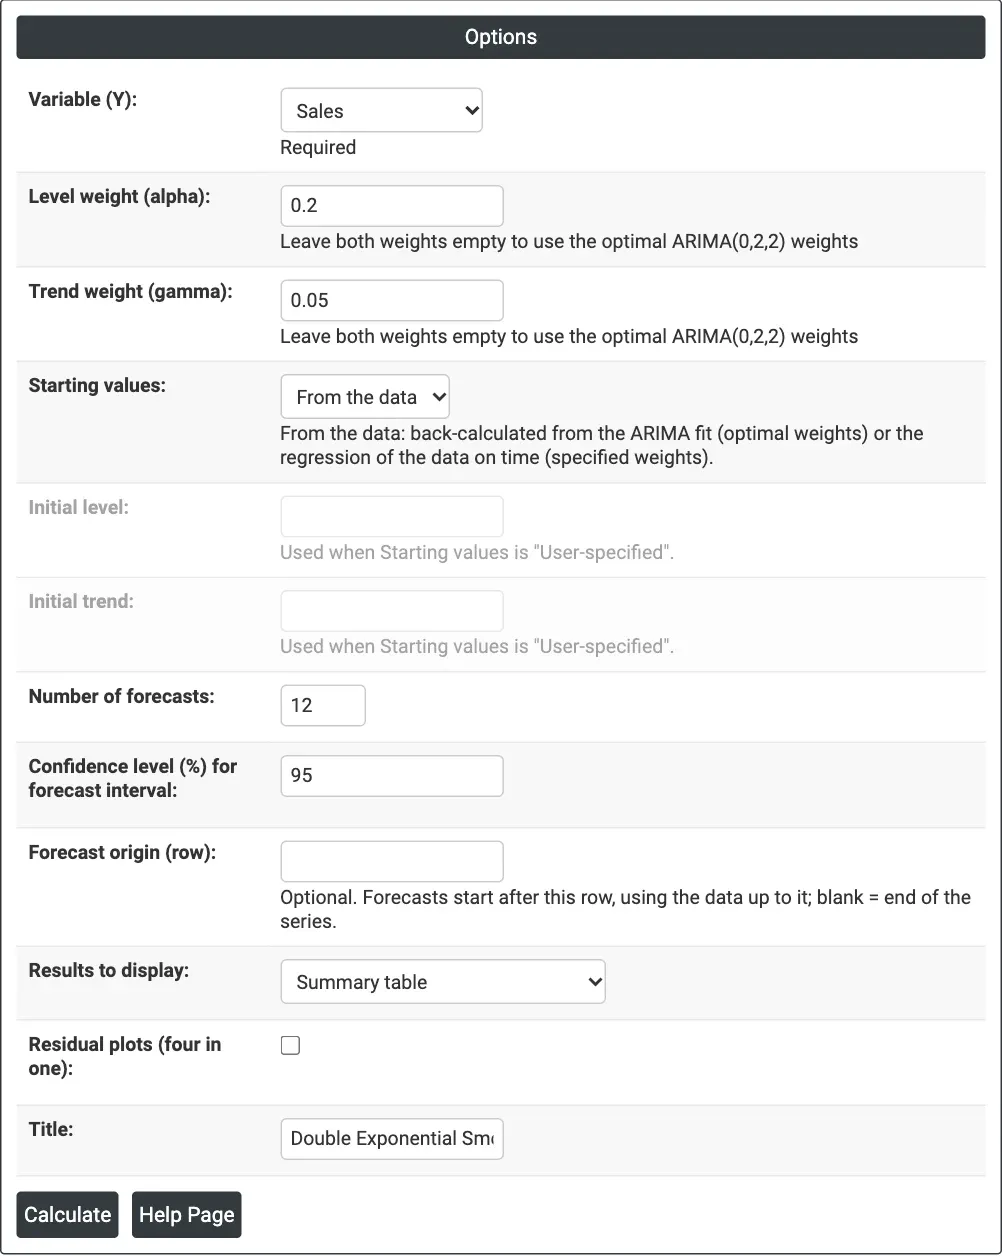
Figuur 1 — Monthly Sales met alpha = 0.2, gamma = 0.05 en 12 voorspellingen.
Beschrijving van de uitvoer
- Double Exponential Smoothing (graph) — werkelijke gegevens, fits, voorspellingen en de voorspellingsband, met MAPE, MAD en MSD in de titel en de gebruikte gewichten boven de plot.
- Method — gegevenskolom, lengte en of de gewichten zijn opgegeven of optimaal zijn (plus de voorspellingsoorsprong wanneer die is ingesteld).
- Smoothing Constants — α (niveau) en γ (trend).
- Accuracy Measures — MAPE, MAD en MSD.
- Forecasts — periode, voorspelling, onder- en bovengrens.
- Results — indien gekozen: Period, data, Level, Trend, Predict en Error voor elke periode.
- Residual Plots — indien aangevinkt.
- PDF-export via Download.
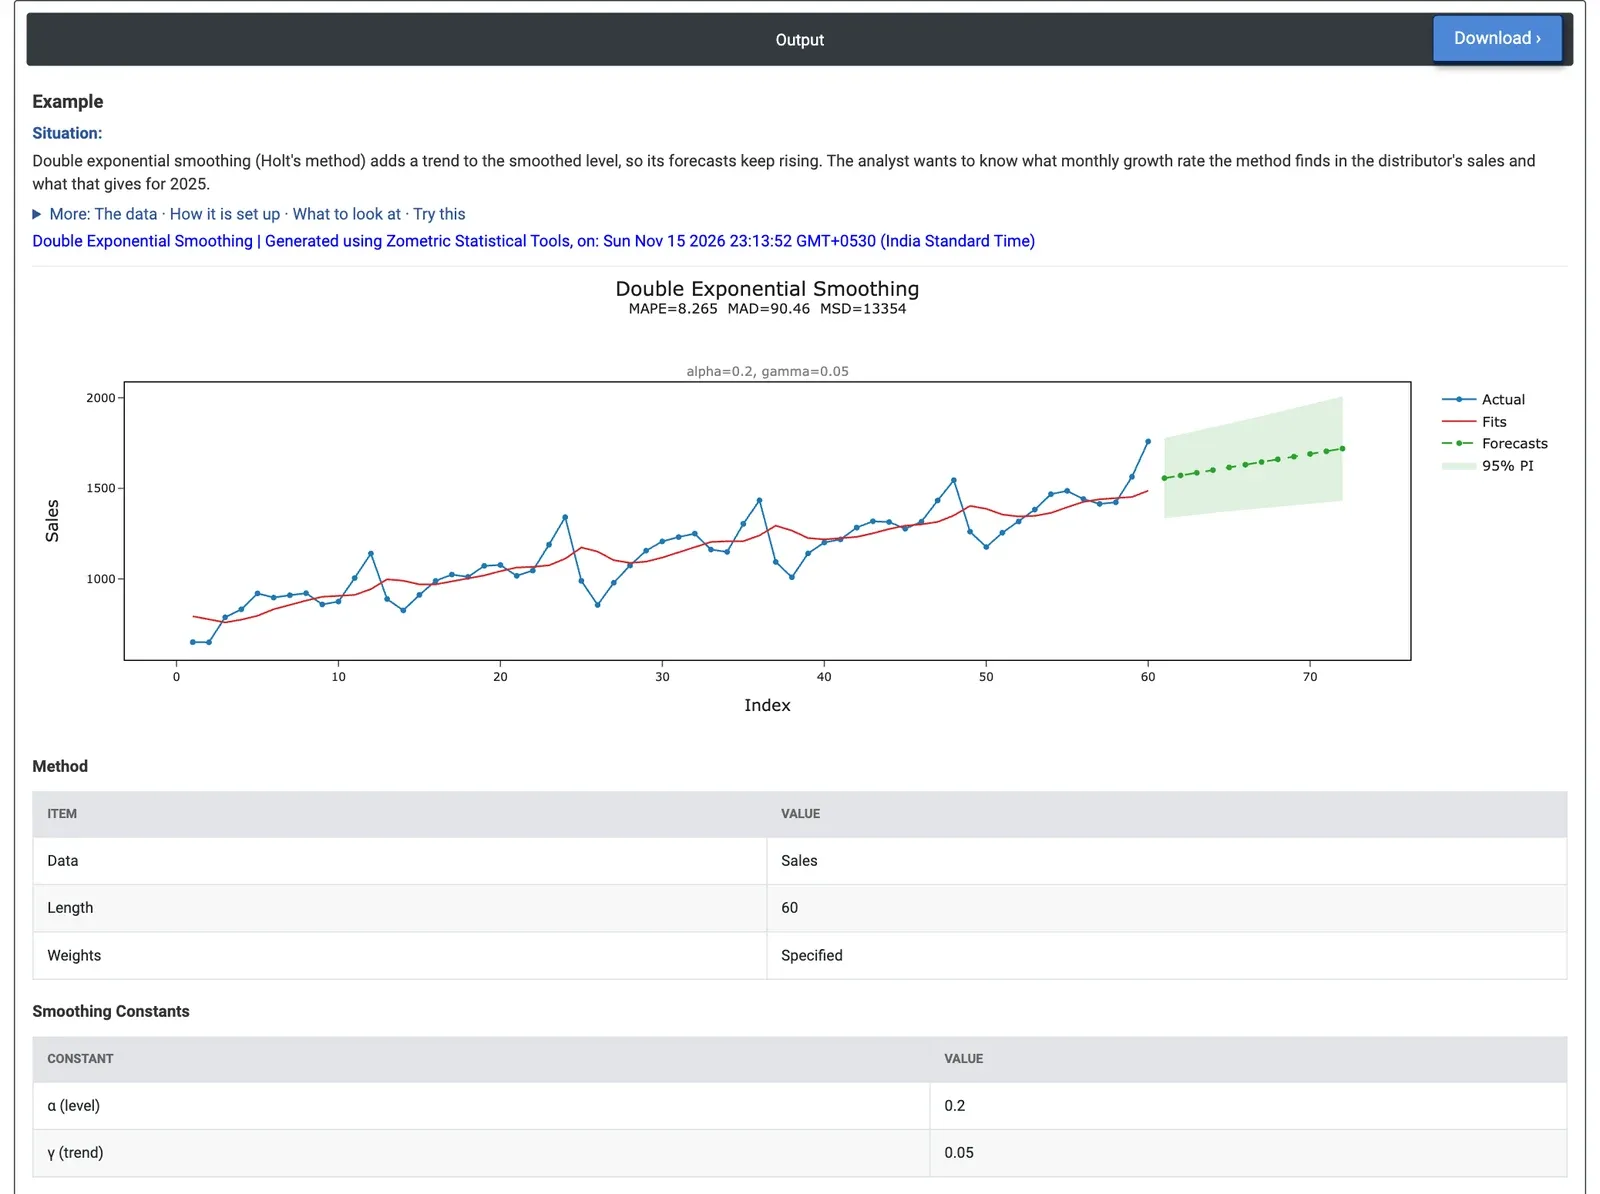
Figuur 2 — De methode van Holt op maandelijkse verkoop: de voorspellingen voor 2025 stijgen in een rechte lijn binnen een breder wordende 95%-band.
Uitgewerkt voorbeeld
Een distributeur van consumentenelektronica heeft 60 maanden aan verkochte aantallen (januari 2020 tot december 2024) die elk jaar groeien. De verkoopanalist wil weten welke maandelijkse groei de methode van Holt vindt en wat ze voor 2025 geeft. De analist selecteert Variable (Y) = Sales, voert Level weight (alpha) = 0.2 en Trend weight (gamma) = 0.05 in (een niveau dat de gegevens rustig volgt en een trend die langzaam verandert, zodat het seizoen de trend niet heen en weer gooit) en stelt Number of forecasts = 12 in.
Eind 2024 is de trend 14.85 eenheden per maand, dus de voorspellingen stijgen in een rechte lijn van 1,556 in januari 2025 tot 1,719 in december 2025. Het 95%-interval wordt met elke maand vooruit breder: 1,334 tot 1,778 voor januari en 1,431 tot 2,008 voor december. De MAPE is 8.3% (MAD 90.5), beter dan enkelvoudige afvlakking (9.4%) maar ver achter de methode van Winters (4.2%) en Decompositie (2.2%), omdat de methode geen seizoen kent. De voorspelling van 1,556 voor januari is waarschijnlijk te hoog: elk jaar daalt de verkoop sterk van december naar januari (1,759 in december 2024, maar 1,261 in januari 2024).
Met beide gewichten leeg zijn de optimale ARIMA-gewichten alpha 1.42 en gamma 0.0001. De fit verandert nauwelijks (MAPE 8.3%), maar de voorspellingen klimmen tot 3,301 in december 2025, omdat het niveau overreageert op de piek van december 2024. Optimale gewichten moeten op redelijkheid worden gecontroleerd; hier gooien de seizoensschommelingen ze uit evenwicht. Voor de beslissing: gebruik de methode van Holt voor een trend zonder seizoen, en de methode van Winters voor deze gegevens.
Veelgestelde vragen
Wanneer gebruikt u dubbele exponentiële afvlakking?
Gebruik haar voor een reeks met een gestage opwaartse of neerwaartse drift en zonder seizoenspatroon, zoals cumulatieve slijtage, een vraag die maand na maand groeit of een langzaam driftend procesgemiddelde. Gebruik voor gegevens met een seizoen de methode van Winters of Decompositie; in het uitgewerkte voorbeeld met seizoensgebonden verkoop had de methode van Holt een MAPE van 8.3% tegenover 4.2% voor de methode van Winters.
Wat doen de gewichten alpha en gamma?
Alpha is het niveaugewicht: een grotere alpha laat het niveau recente waarden nauwer volgen. Gamma is het trendgewicht: een grotere gamma laat de trend sneller veranderen. Opgegeven gewichten liggen tussen 0.0001 en 1. Als u beide leeg laat, worden optimale gewichten uit een ARIMA(0,2,2)-fit gebruikt, die buiten 0 tot 1 kunnen vallen.
Waarom worden de voorspellingsgrenzen bij de methode van Holt breder?
De grenzen zijn de voorspelling plus of min z x dₘ x MAD, waarbij z het kwantiel van de normale verdeling voor het betrouwbaarheidsniveau is, MAD de gemiddelde absolute fout van de fits is, en dₘ een factor is die groeit met het aantal perioden vooruit. De band wordt daardoor verderop in de toekomst breder.
Kunt u de optimale afvlakkingsgewichten vertrouwen?
Optimale gewichten moeten op redelijkheid worden gecontroleerd. In het voorbeeld waren de optimale gewichten alpha 1.42 en gamma 0.0001; de fit veranderde nauwelijks, maar de voorspellingen klommen tot 3,301 voor december 2025 omdat het niveau overreageerde op de piek van december 2024. De seizoensschommelingen hadden de gewichten uit evenwicht gebracht.