
Empirische CDF
De empirische CDF sorteert de waarden en zet elke waarde uit op (i − 0.5) / n als percentage, verbonden als trappen. Gebruik haar om groepen verder dan hun gemiddelden te vergelijken, het aandeel onderdelen onder een grens af te lezen, of gegevens te toetsen aan een gefitte verdeling zoals de normale of Weibull-verdeling. Een kolom By geeft één curve per groep en meerdere variabelen kunnen over elkaar heen worden gelegd.
Laatst beoordeeld
Belangrijkste conclusie
Een empirische CDF zet voor elke meetwaarde het percentage waarnemingen op of onder die waarde uit als trapcurve en toont zo in één keer de mediaan, spreiding, staarten en hiaten van de hele verdeling.
Op deze pagina
Doel
De empirische CDF zet voor elke meetwaarde het percentage waarnemingen op of onder die waarde uit. Het resultaat is een trapcurve die in één keer de hele verdeling toont: de mediaan, de spreiding, de staarten en eventuele hiaten. Gebruik haar om twee of meer groepen (machines, leveranciers, configuraties) verder dan hun gemiddelden te vergelijken, om het aandeel onderdelen onder een grens af te lezen, of om de gegevens te toetsen aan een gefitte verdeling.
Belangrijkste mogelijkheden
- Eén trapcurve per variabele, of per groep van één variabele wanneer een kolom By is gekozen.
- Meerdere variabelen over elkaar heen in één plot voor een directe vergelijking.
- Optionele gefitte verdeling als gestippelde lijn eroverheen: Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest of Largest Extreme Value, Logistic of Loglogistic.
- Percentageschaal van 0 tot 100 op de verticale as, zodat percentielen rechtstreeks van de curve kunnen worden afgelezen.
- Rijen kunnen vóór het plotten worden uitgesloten of behouden op rijnummer of op een voorwaarde.
Statistische methoden
Voor elke curve worden de niet-lege numerieke waarden gesorteerd, x₁ ≤ x₂ ≤ … ≤ xₙ, en wordt de i-de waarde uitgezet op de plotpositie pᵢ = (i − 0.5) / n, weergegeven als percentage. De punten worden als trap verbonden (eerst horizontaal, dan verticaal), zodat de curve bij elke waarneming met 100/n procent stijgt. De waarde waarbij een curve 50% kruist, is de mediaan van die groep; waar ze 90% kruist, is het het 90e percentiel.
Bij een kolom By en één variabele worden de rijen gesplitst naar de niveaus van de kolom By en krijgt elk niveau een eigen curve. Bij meerdere variabelen krijgt elke variabele een curve en wordt de kolom By genegeerd.
Wanneer een gefitte verdeling is gekozen, worden de parameters per curve afzonderlijk geschat (per groep, of per variabele), zoals in Minitab, en wordt elke gefitte CDF getekend over het bereik van de eigen gegevens. De normale verdeling gebruikt het steekproefgemiddelde en de standaardafwijking; de andere verdelingen gebruiken maximum likelihood (lognormaal, Weibull, exponentieel en loglogistisch met de drempel vast op 0, dus ze hebben positieve waarden nodig). De legenda toont de gefitte parameters van elke curve, zodat elke groep aan haar eigen model kan worden getoetst.
Invoervelden en opties
Veld | Beschrijving |
Variables | Eén of meer numerieke kolommen. Selecteer één variabele, of meerdere om hun curven over elkaar heen te leggen. |
By (grouping) column | Optioneel. Eén curve per niveau van deze kolom. Wordt alleen gebruikt wanneer één variabele is geselecteerd. |
Overlay fitted distribution | Standaard “--- (empirical only)”: geen gefitte lijn. Of een van Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic, Loglogistic. |
Title | Titel van de plot. Standaard “Empirical CDF”. |
Data Options: Subset (optional) | Exclude matching rows (standaard) of Include only matching rows; Row numbers (bijv. 3,7,12-15) en/of een Condition (bijv. Weight_kg > 100) selecteren de rijen. Heeft geen effect wanneer beide leeg zijn. |
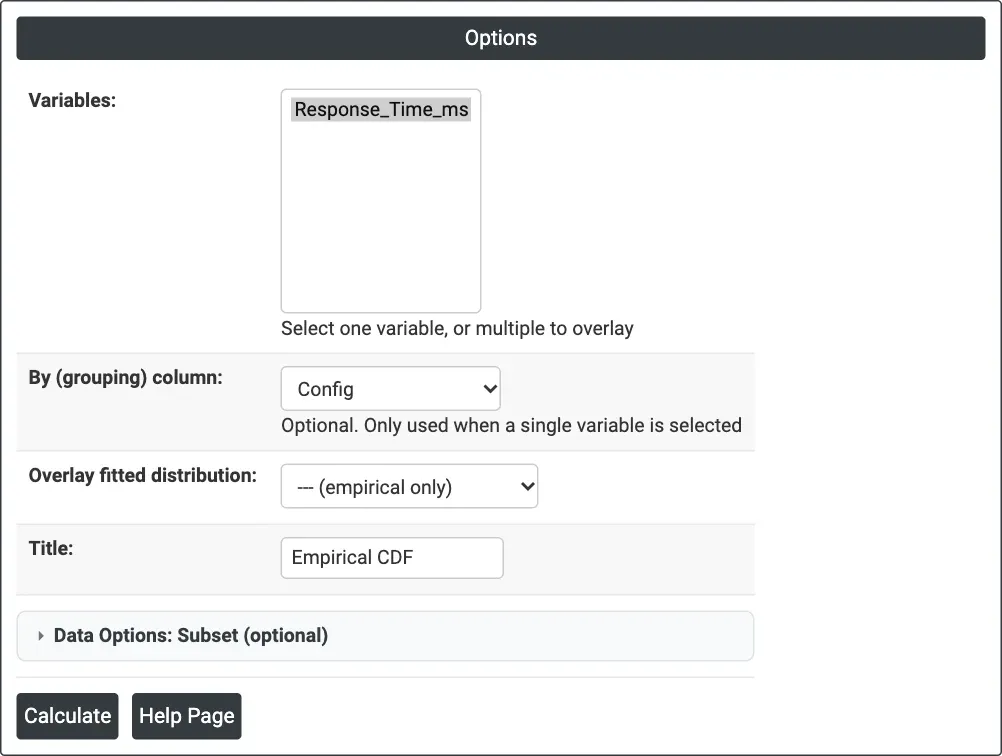
Figuur 1 — Opties voor het voorbeeld: Variables = Response_Time_ms, By (grouping) column = Config, geen gefitte verdeling.
Beschrijving van de uitvoer
- Empirical CDF — trapcurve van percentage tegen de variabele voor elke groep of variabele, met markeringen bij elke waarneming en een legenda die de curven benoemt; de gefitte verdeling, indien gekozen, is voor elke curve een gestippelde lijn in de kleur van de curve (zwart wanneer er maar één curve is), met haar parameters als label.
- PDF-export via Download.
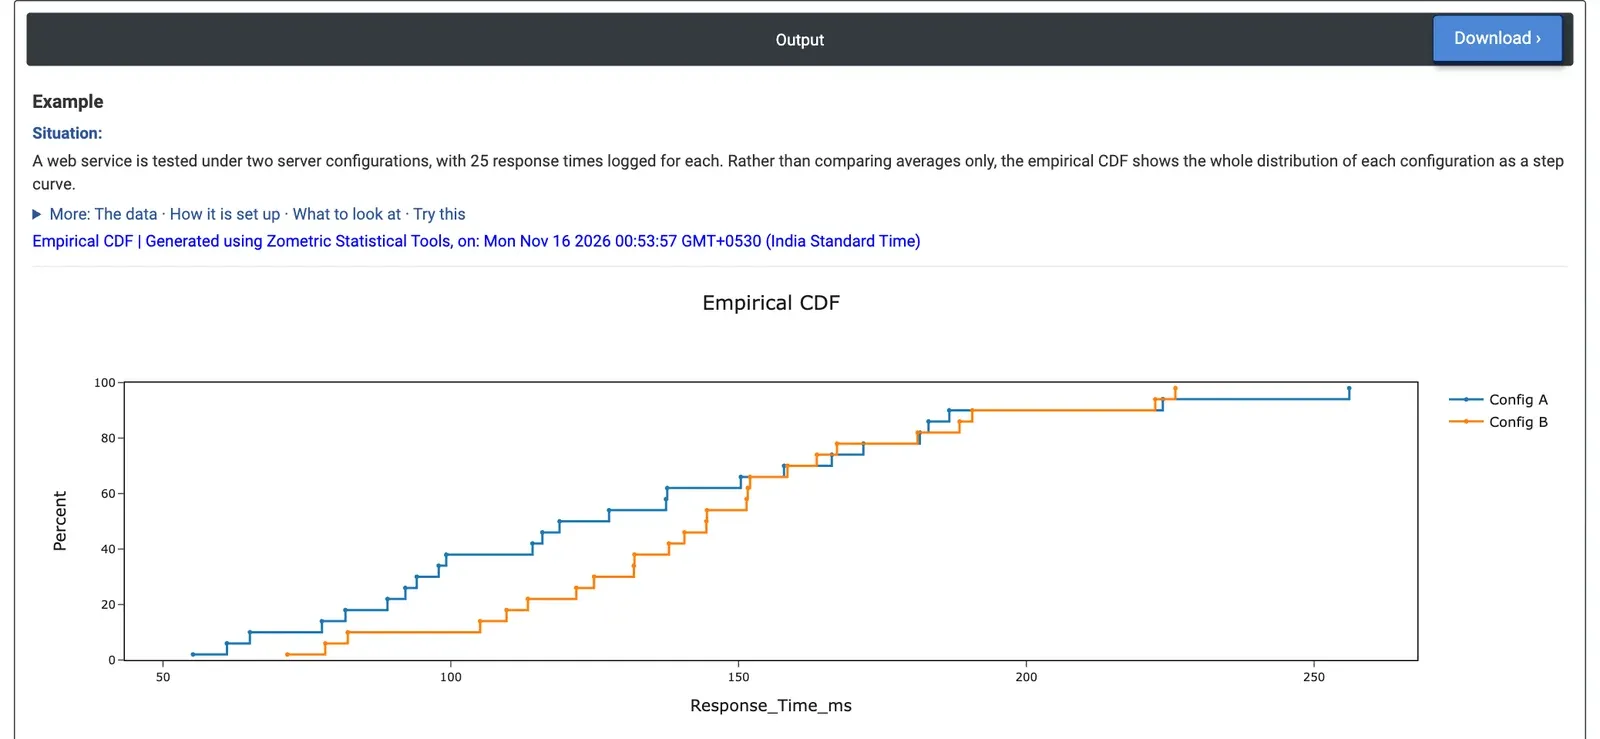
Figuur 2 — Empirische CDF van de responstijd voor Config A (blauw) en Config B (oranje), elk 25 verzoeken.
Uitgewerkt voorbeeld
Een IT-team test een webservice onder twee serverconfiguraties en registreert voor elk 25 responstijden (ms). De gemiddelden alleen (129.7 ms voor A, 143.6 ms voor B) wijzen erop dat A sneller is, maar het team wil weten hoe de hele verdeling zich verhoudt, vooral de trage verzoeken die gebruikers opmerken. Ze selecteren Response_Time_ms als variabele en Config als kolom By, zonder gefitte verdeling.
Als u bij 50% naar links afleest, is de mediaan 118.9 ms voor Config A en 144.4 ms voor Config B: over het grootste deel van het bereik ligt de curve van B rechts, dus een typisch verzoek is trager op B. Bij 150 ms is 64% van de verzoeken van A afgehandeld tegenover 56% van B. Bovenaan kruisen de curven: het traagste verzoek van A duurt 256.1 ms tegenover 225.9 ms voor het traagste van B, en de spreiding van A is groter (standaardafwijking 51.8 tegenover 39.7 ms). Bij beide configuraties valt 92% van de verzoeken binnen 200 ms. B is dus trager bij een typisch verzoek, terwijl A de langere staart heeft; de keuze hangt ervan af of de mediaan of het slechtste geval voor de service belangrijker is.
Als u Normal als overlay kiest, komt er voor elke configuratie een gestippelde normale curve bij, gefit aan haar eigen 25 waarden: gemiddelde 129.7 ms en standaardafwijking 51.8 ms voor A, gemiddelde 143.6 ms en standaardafwijking 39.7 ms voor B. Waar een trapcurve van haar gestippelde curve afwijkt, zijn de responstijden van die configuratie niet normaal.
Veelgestelde vragen
Hoe leest u een empirische CDF?
De curve stijgt bij elke waarneming met 100/n procent. Lees bij 50% naar links af om de mediaan van elke groep te vinden en bij 90% voor het 90e percentiel, of lees vanaf een grens omhoog af om het aandeel waarden eronder te zien. In het uitgewerkte voorbeeld was de mediane responstijd 118.9 ms voor Config A en 144.4 ms voor Config B.
Waarom groepen vergelijken met een empirische CDF in plaats van met gemiddelden?
Gemiddelden verhullen verschillen in spreiding en staarten. In het uitgewerkte voorbeeld had Config A de lagere gemiddelde en mediane responstijd, maar de curven kruisten bovenaan: het traagste verzoek van A duurde 256.1 ms tegenover 225.9 ms voor het traagste van B. De CDF toont of het typische geval of het slechtste geval verschilt.
Hoe toetst u gegevens aan een gefitte verdeling?
Kies een verdeling om eroverheen te leggen, zoals Normal, Lognormal, Weibull, Exponential, Logistic of een extreme-waardeverdeling. De parameters worden per curve afzonderlijk geschat en als gestippelde lijn getekend. Waar een trapcurve van haar gestippelde curve afwijkt, volgen de gegevens die verdeling niet. Lognormal, Weibull, Exponential en Loglogistic hebben positieve waarden nodig.
Hoe vergelijkt u groepen in Zometric Statistical Software?
Selecteer één variabele en een By (grouping) column om één trapcurve per niveau te krijgen, of selecteer meerdere variabelen om hun curven over elkaar heen te leggen; de kolom By wordt dan genegeerd. Met Data Options kunt u rijen vóór het plotten uitsluiten of behouden op rijnummer of op een voorwaarde.