
Gemengd-effectenmodel (Fit Mixed Effects Model)
Fit Mixed Effects Model toetst vaste categorische factoren en covariabelen en schat tegelijk variantiecomponenten voor willekeurige factoren zoals batches, operators of dagen. Gebruik het wanneer het negeren van willekeurige factoren de toetsen van de vaste factoren te optimistisch zou maken. Elke willekeurige factor heeft minstens 3 niveaus nodig. De uitvoer bevat variantiecomponenten, F-toetsen met vrijheidsgraden volgens Satterthwaite, coëfficiënten en een modeloverzicht met AICc en BIC.
Laatst beoordeeld
Belangrijkste conclusie
Een gemengd-effectenmodel analyseert een respons die afhangt van vaste factoren, waarvan u de niveaus vergelijkt, en willekeurige factoren uit een populatie; het toetst de vaste factoren en schat de willekeurige variantie.
Op deze pagina
Doel
Fit Mixed Effects Model analyseert een respons die afhangt van twee soorten factoren: vaste factoren, waarvan u de specifieke niveaus wilt vergelijken (twee machines, drie leveranciers, een nieuwe en een oude methode), en willekeurige factoren, waarvan de niveaus een steekproef uit een grotere populatie zijn (batches, monsters, operators, dagen). Het toetst de vaste factoren en schat hoeveel variantie elke willekeurige factor toevoegt. Gebruik het wanneer het negeren van de willekeurige factoren de toetsen van de vaste factoren te optimistisch zou maken, bijvoorbeeld wanneer dezelfde batches of onderdelen onder elke conditie worden gemeten.
Belangrijkste mogelijkheden
- Eén of meer vaste categorische factoren en continue covariabelen, met één of meer willekeurige factoren.
- Variantiecomponenten voor elke willekeurige factor en de fout, met % van het totaal, standaardfout, Z-toets en betrouwbaarheidsinterval.
- F-toetsen van de vaste effecten met noemervrijheidsgraden volgens Satterthwaite.
- Coëfficiënten met vrijheidsgraden volgens Satterthwaite, t-toetsen en betrouwbaarheidsintervallen.
- Modeloverzicht met S, R-sq, R-sq(adj), AICc, BIC en −2 log likelihood.
- Schatting met restricted maximum likelihood (REML) of maximum likelihood (ML).
- Data Options: een deelverzameling van de rijen nemen vóór de analyse.
Statistische methoden
Het model is y = Xβ + Σ Zᵢuᵢ + ε, waarbij Xβ de vaste factoren (sum-to-zero-codering −1/0/+1) en covariabelen bevat, elke willekeurige factor i onafhankelijke effecten uᵢ toevoegt met variantie σᵢ², en de fouten ε variantie σ² hebben. Willekeurige factoren zijn onafhankelijke variantiecomponenten (er worden geen interacties geschat). De varianties worden geschat met REML (standaard), dat rekening houdt met de vrijheidsgraden die de vaste effecten gebruiken en vrijwel zuivere variantiecomponenten geeft, of met ML, dat nodig is om modellen met verschillende vaste effecten te vergelijken via AICc of BIC. Rijen met een ontbrekende waarde worden weggelaten; elke willekeurige factor heeft minstens 3 niveaus nodig.
Gegeven de variantieschattingen zijn de vaste coëfficiënten gegeneraliseerde kleinste-kwadratenschattingen. Elke vaste term wordt getoetst met een F-toetsingsgrootheid waarvan de noemervrijheidsgraden uit de benadering van Satterthwaite komen, en elke coëfficiënt met een t-toets op vrijheidsgraden volgens Satterthwaite. Variantiecomponenten hebben standaardfouten uit de Fisher-informatie, een eenzijdige Z = Var / SE Var-toets of de component nul is, en een betrouwbaarheidsinterval dat op de logaritmische schaal wordt berekend, zodat het nooit negatief is. Bij weinig niveaus van een willekeurige factor heeft deze Z-toets weinig onderscheidend vermogen en is het interval breed.
R-sq vergelijkt de voorwaardelijke fits (vaste effecten plus voorspelde willekeurige effecten) met de totale variatie. S is de wortel uit de foutvariantie. AICc en BIC zijn kleiner voor betere modellen; bij REML vergelijken ze alleen modellen met dezelfde vaste effecten.
Invoervelden en opties
Veld | Beschrijving |
Response (Y) | Numerieke responskolom. Verplicht. |
Fixed factors (categorical) | Eén of meer kolommen waarvan de specifieke niveaus direct van belang zijn. Verplicht. |
Random factors (categorical) | Eén of meer kolommen waarvan de niveaus een aselecte steekproef uit een grotere populatie zijn (bijv. Field, Batch, Operator), gemodelleerd als onafhankelijke variantiecomponenten. Verplicht. |
Covariates (continuous) | Optionele numerieke kolommen, alleen als vaste hoofdeffecten ingevoerd. |
Confidence level | Standaard 95. |
Estimation method | Restricted maximum likelihood (REML), de standaardwaarde, of Maximum likelihood (ML). |
Data Options: Subset (optional) | Exclude matching rows (standaard) of Include only matching rows, op rijnummers en/of een voorwaarde. |
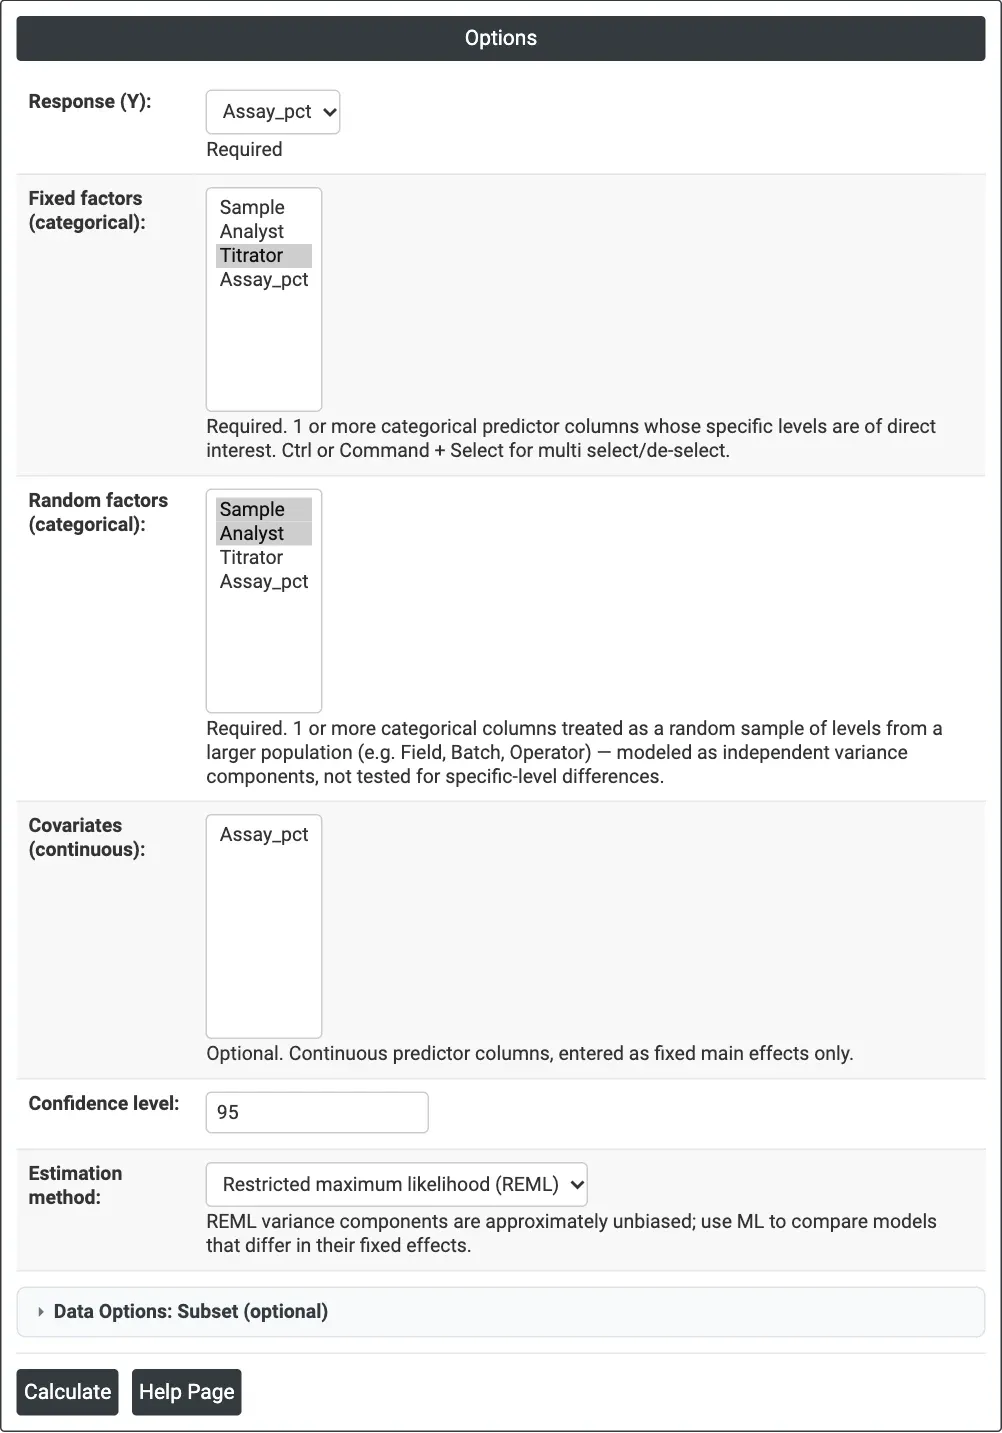
Figuur 1 — Opties voor het titratorvoorbeeld: Assay_pct als respons, Titrator als vaste factor, Sample en Analyst als willekeurige factoren, REML.
Beschrijving van de uitvoer
- Method — de methode voor het schatten van de variantie en de methode voor de vrijheidsgraden van de vaste effecten.
- Variance Components — Var, % of Total, SE Var, Z-Value, P-Value en betrouwbaarheidsinterval voor elke willekeurige factor, de fout en het totaal.
- Tests of Fixed Effects — DF Num, DF Den, F-Value en P-Value voor elke vaste factor en covariabele.
- Model Summary — S, R-sq, R-sq(adj), AICc, BIC en −2 log likelihood.
- Coefficients — Coef, SE Coef, DF, T-Value, P-Value en betrouwbaarheidsinterval.
- Er wordt een waarschuwing getoond als de optimalisatie niet volledig is geconvergeerd.
- PDF-export via Download.
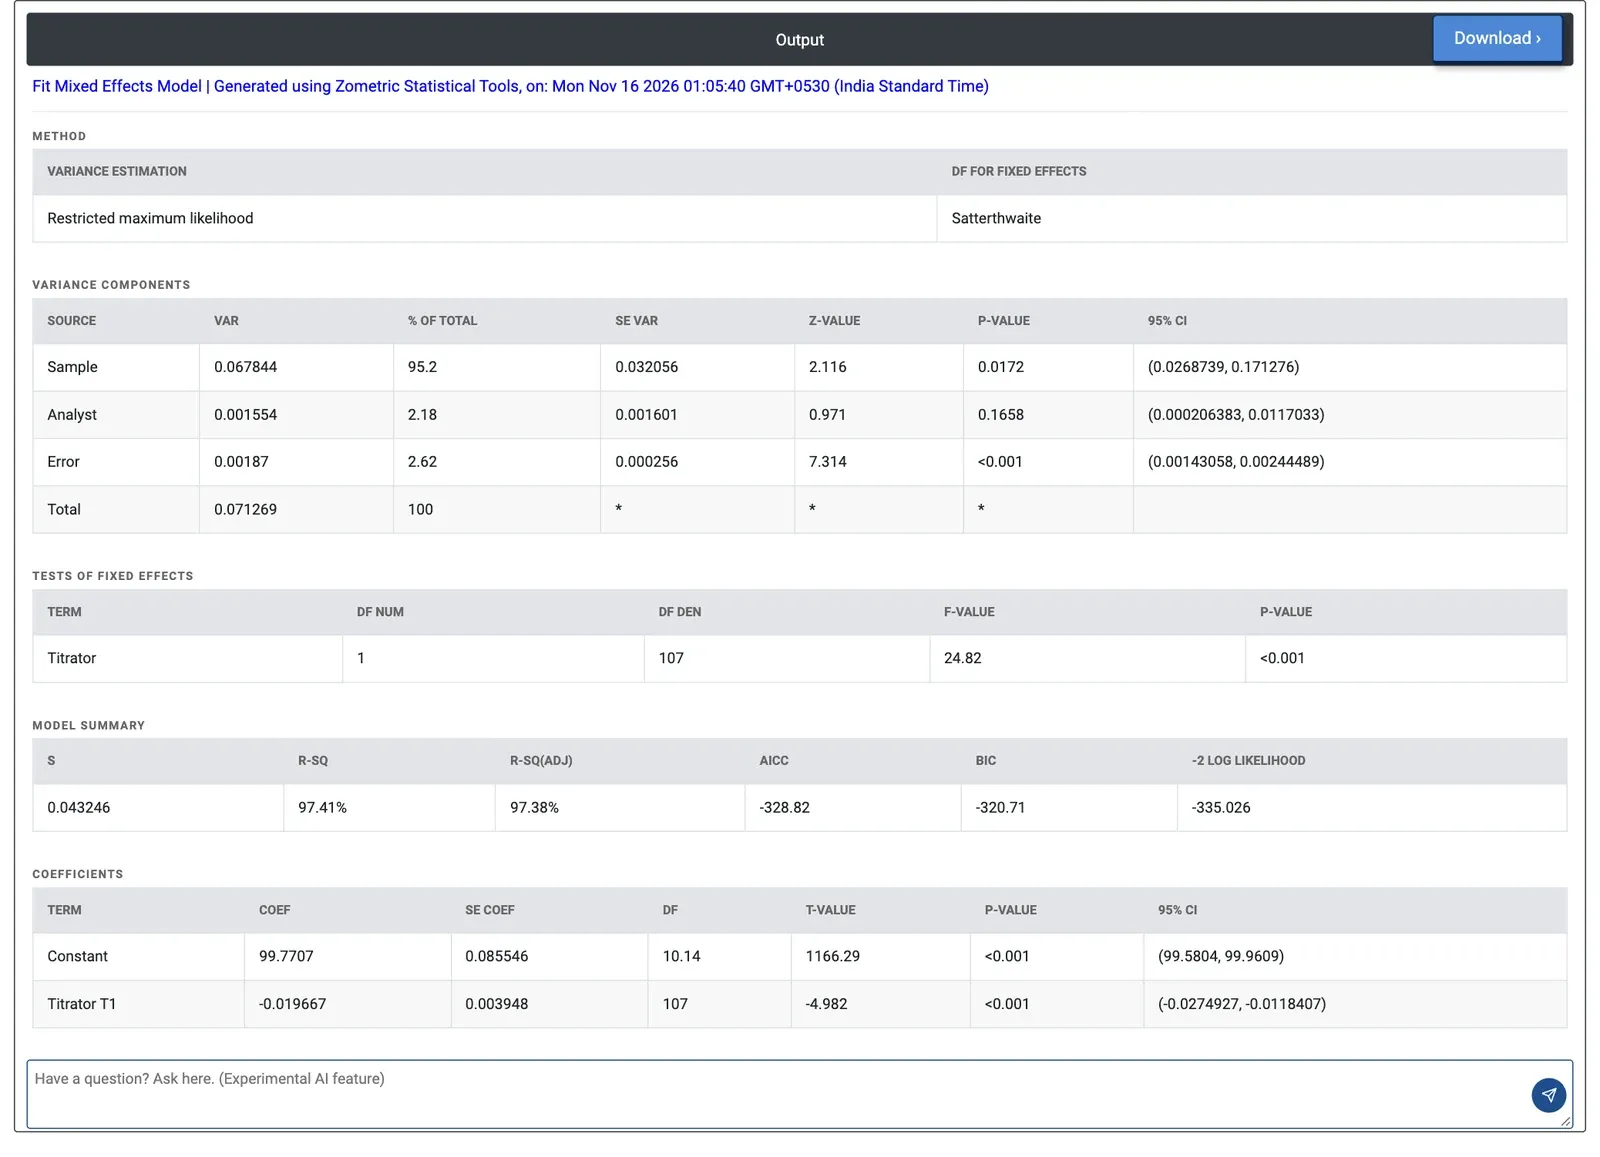
Figuur 2 — Gemengd model van de assayresultaten: monsters verklaren 95.2% van de variantie, en de twee titrators verschillen (F = 24.82, p < 0.001).
Uitgewerkt voorbeeld
Een laboratorium voor soda (natriumcarbonaat) meet de zuiverheid van het product (Assay_pct) op twee automatische titrators, T1 en T2. Tien monsters worden elk tweemaal door drie analisten op beide titrators gemeten: 120 resultaten. De vraag is of de twee titrators hetzelfde resultaat geven. De titrators zijn de twee instrumenten die het laboratorium bezit, dus Titrator is een vaste factor; de monsters en analisten vertegenwoordigen veel mogelijke monsters en analisten, dus zij zijn willekeurige factoren. Het laboratorium voert Assay_pct in als respons, Titrator als vaste factor en Sample en Analyst als willekeurige factoren, met REML. Load Example vult deze gegevens (soda-ash-assay-expanded-grr, dezelfde studie als het voorbeeld Gage R&R Study (Expanded)) en deze instellingen in.
De variantiecomponenten laten zien dat de monsters zelf het meest verschillen: 0.0678 (95.2% van het totaal, standaardafwijking ongeveer 0.26 procentpunt). De component voor de analist is klein, 0.00155 (2.18%), en niet significant verschillend van nul (p = 0.1658); de fout, de herhaalbaarheid van één resultaat, is 0.00187 (standaardafwijking 0.043).
Titrator is significant: F = 24.82 met 1 en 107 vrijheidsgraden, p < 0.001. De coëfficiënt voor T1 is −0.0197 met sum-to-zero-codering, dus T2 meet ongeveer 0.039 procentpunt hoger dan T1, dicht bij één standaardafwijking van de herhaalbaarheid. Omdat elk monster op beide titrators is gemeten, verbergt de spreiding tussen monsters dit verschil niet. Het laboratorium besluit de kalibratie van beide titrators te controleren aan de hand van een referentiestandaard.
Veelgestelde vragen
Wat is het verschil tussen een vaste factor en een willekeurige factor?
Een vaste factor heeft specifieke niveaus die u wilt vergelijken, zoals twee machines, drie leveranciers of een nieuwe en een oude methode. Een willekeurige factor heeft niveaus die een steekproef uit een grotere populatie zijn, zoals batches, monsters, operators of dagen. Een gemengd-effectenmodel toetst de vaste factoren en schat hoeveel variantie elke willekeurige factor toevoegt.
Wanneer gebruikt u een gemengd-effectenmodel?
Gebruik een gemengd-effectenmodel wanneer het negeren van de willekeurige factoren de toetsen van de vaste factoren te optimistisch zou maken, bijvoorbeeld wanneer dezelfde batches of onderdelen onder elke conditie worden gemeten. In het titratorvoorbeeld zijn tien monsters op beide titrators gemeten, zodat de spreiding tussen monsters het verschil tussen titrators niet verborg.
Gebruikt u REML of ML voor een gemengd model?
REML, de standaardwaarde, houdt rekening met de vrijheidsgraden die de vaste effecten gebruiken en geeft vrijwel zuivere variantiecomponenten. ML is nodig om modellen met verschillende vaste effecten te vergelijken via AICc of BIC. Bij REML vergelijken AICc en BIC alleen modellen met dezelfde vaste effecten.
Hoe interpreteert u de tabel met variantiecomponenten?
Elke willekeurige factor en de fout heeft een variantie, het percentage van het totaal, een standaardfout, een eenzijdige Z-toets of de component nul is, en een betrouwbaarheidsinterval dat op de logaritmische schaal wordt berekend zodat het nooit negatief is. Bij weinig niveaus van een willekeurige factor heeft de Z-toets weinig onderscheidend vermogen en is het interval breed.