
Volledig geneste ANOVA (Fully Nested ANOVA)
Volledig geneste ANOVA schat hoeveel variatie uit elk niveau van een hiërarchie komt, met twee tot vier geneste willekeurige factoren en herhaalmetingen als fout. Elke eenheid van een lager niveau moet bij slechts één eenheid van een hoger niveau horen. De uitvoer bevat een ANOVA-tabel (F en P alleen voor gebalanceerde ontwerpen), variantiecomponenten met % van het totaal, verwachte gemiddelde kwadraten, modeloverzicht en celgemiddelden.
Laatst beoordeeld
Belangrijkste conclusie
Volledig geneste ANOVA splitst de variatie in een meting op in de niveaus van een hiërarchie, zoals batches, monsters binnen batches en herhaalmetingen, om te tonen waar de meeste variatie vandaan komt.
Op deze pagina
Doel
Volledig geneste ANOVA splitst de variatie in een meting op in de niveaus van een hiërarchie, zoals batches, monsters binnen elke batch en herhaalmetingen binnen elk monster. Gebruik haar wanneer elke eenheid van een lager niveau bij slechts één eenheid van een hoger niveau hoort (monster 1 van batch 1 is niet hetzelfde materiaal als monster 1 van batch 2) en u wilt weten waar de meeste variatie vandaan komt, zodat u weet waar u moet ingrijpen: het proces, de bemonstering of de meting.
Belangrijkste mogelijkheden
- Twee tot vier geneste factoren, van de buitenste (bijv. Batch) tot de binnenste (bijv. Sample); herhaalmetingen binnen de binnenste factor vormen de fout.
- Eén analyse per respons wanneer meerdere responsen zijn geselecteerd.
- ANOVA-tabel met sequentiële kwadratensommen en F-toetsen van elk niveau tegen het niveau eronder.
- Variantiecomponenten met hun % van het totaal en standaardafwijkingen.
- Verwachte gemiddelde kwadraten, modeloverzicht en een tabel met gemiddelden en standaardafwijkingen voor elke cel.
- Verwerkt ongebalanceerde gegevens voor de variantiecomponenten; Data Options om de rijen te selecteren.
Statistische methoden
Alle factoren worden als willekeurig behandeld en elk is genest in de voorgaande. De kwadratensom van elke factor is de spreiding van zijn celgemiddelden rond de gemiddelden van het niveau erboven; de foutenkwadratensom is de spreiding van de metingen rond de gemiddelden van de binnenste cellen. Elke factor heeft (aantal cellen − aantal cellen erboven) vrijheidsgraden en de fout heeft N − aantal binnenste cellen.
Elke factor wordt getoetst tegen de volgende factor erbinnen, en de binnenste factor tegen de fout: F = MS(factor) / MS(volgende binnenste term). F en P worden alleen gegeven voor gebalanceerde ontwerpen (gelijke aantallen metingen in elke cel en gelijke aantallen subeenheden in elke eenheid); bij ongebalanceerde gegevens vermeldt de pagina dit en laat ze weg.
De variantiecomponenten volgen uit de verwachte gemiddelde kwadraten (ANOVA-methode): E(MS) van elke factor is σ²(fout) plus veelvouden van de componenten van die factor en de factoren erbinnen, zoals getoond in de tabel Expected Mean Squares, waarin (1), (2), … de factoren in nestingsvolgorde nummeren en het laatste nummer de fout is. Door deze vergelijkingen van de binnenste term naar buiten op te lossen, volgt elke component; een negatieve schatting wordt getoond met 0% van het totaal. % of Total is het aandeel van elke component in de opgetelde variantie en StDev de wortel ervan. Rijen met een ontbrekende respons- of factorwaarde worden weggelaten.
Invoervelden en opties
Veld | Beschrijving |
Responses | Een of meer numerieke kolommen. Vereist; één analyse per respons. |
Factor 1 (outermost) | Het hoogste niveau van de hiërarchie, bijv. Batch. Vereist. |
Factor 2 (nested in Factor 1) | Vereist, bijv. Sample binnen Batch. |
Factor 3 (nested in Factor 2) / Factor 4 (nested in Factor 3) | Optionele diepere niveaus; Factor 4 vereist Factor 3. |
Data Options: Subset (optional) | Exclude matching rows (standaard) of Include only matching rows, op rijnummers en/of een voorwaarde. |
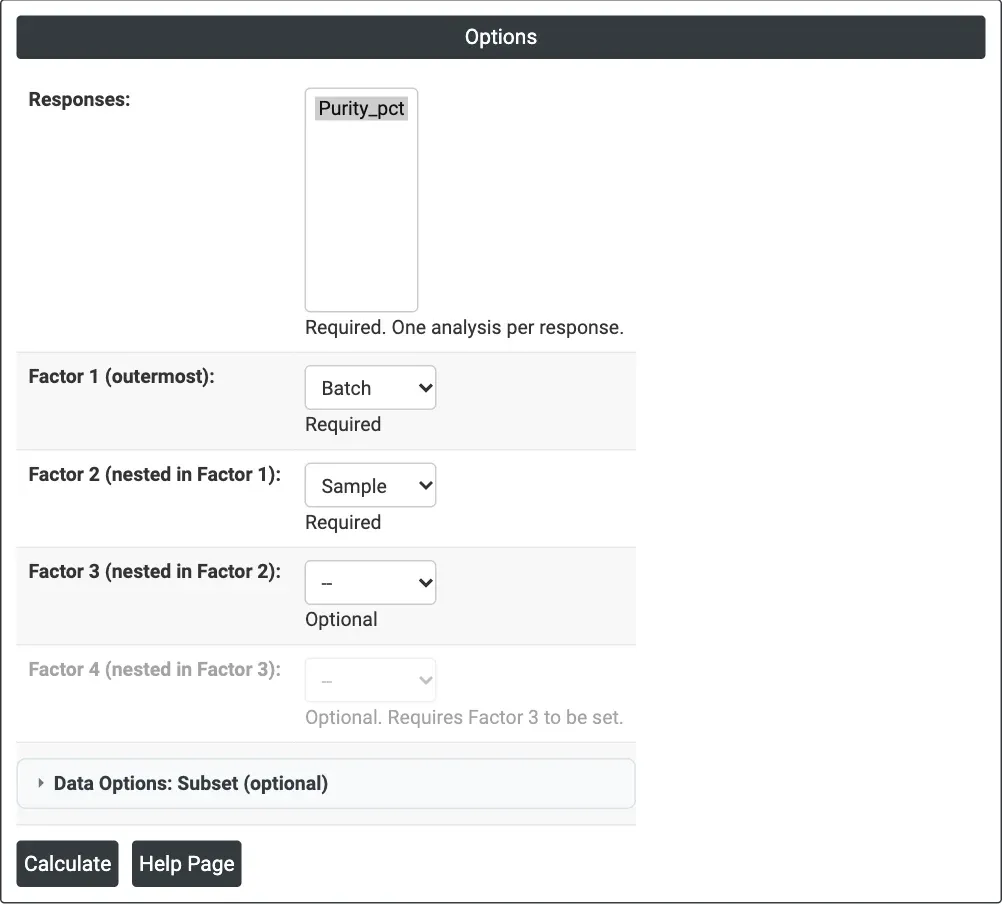
Figuur 1 — Opties voor het zuiverheidsvoorbeeld: Purity_pct als respons, Batch als Factor 1 en Sample (genest in Batch) als Factor 2.
Beschrijving van de uitvoer
- Analysis of Variance — DF, SS, MS, F en P voor elke factor, de fout en het totaal.
- Variance Components — Var Comp, % of Total en StDev voor elke factor, de fout en het totaal.
- Expected Mean Squares — de samenstelling van elk gemiddeld kwadraat in termen van de variantiecomponenten.
- Model Summary — S, R-sq en R-sq(adj).
- Means — N, gemiddelde en standaardafwijking van elke binnenste cel.
- PDF-export via Download.
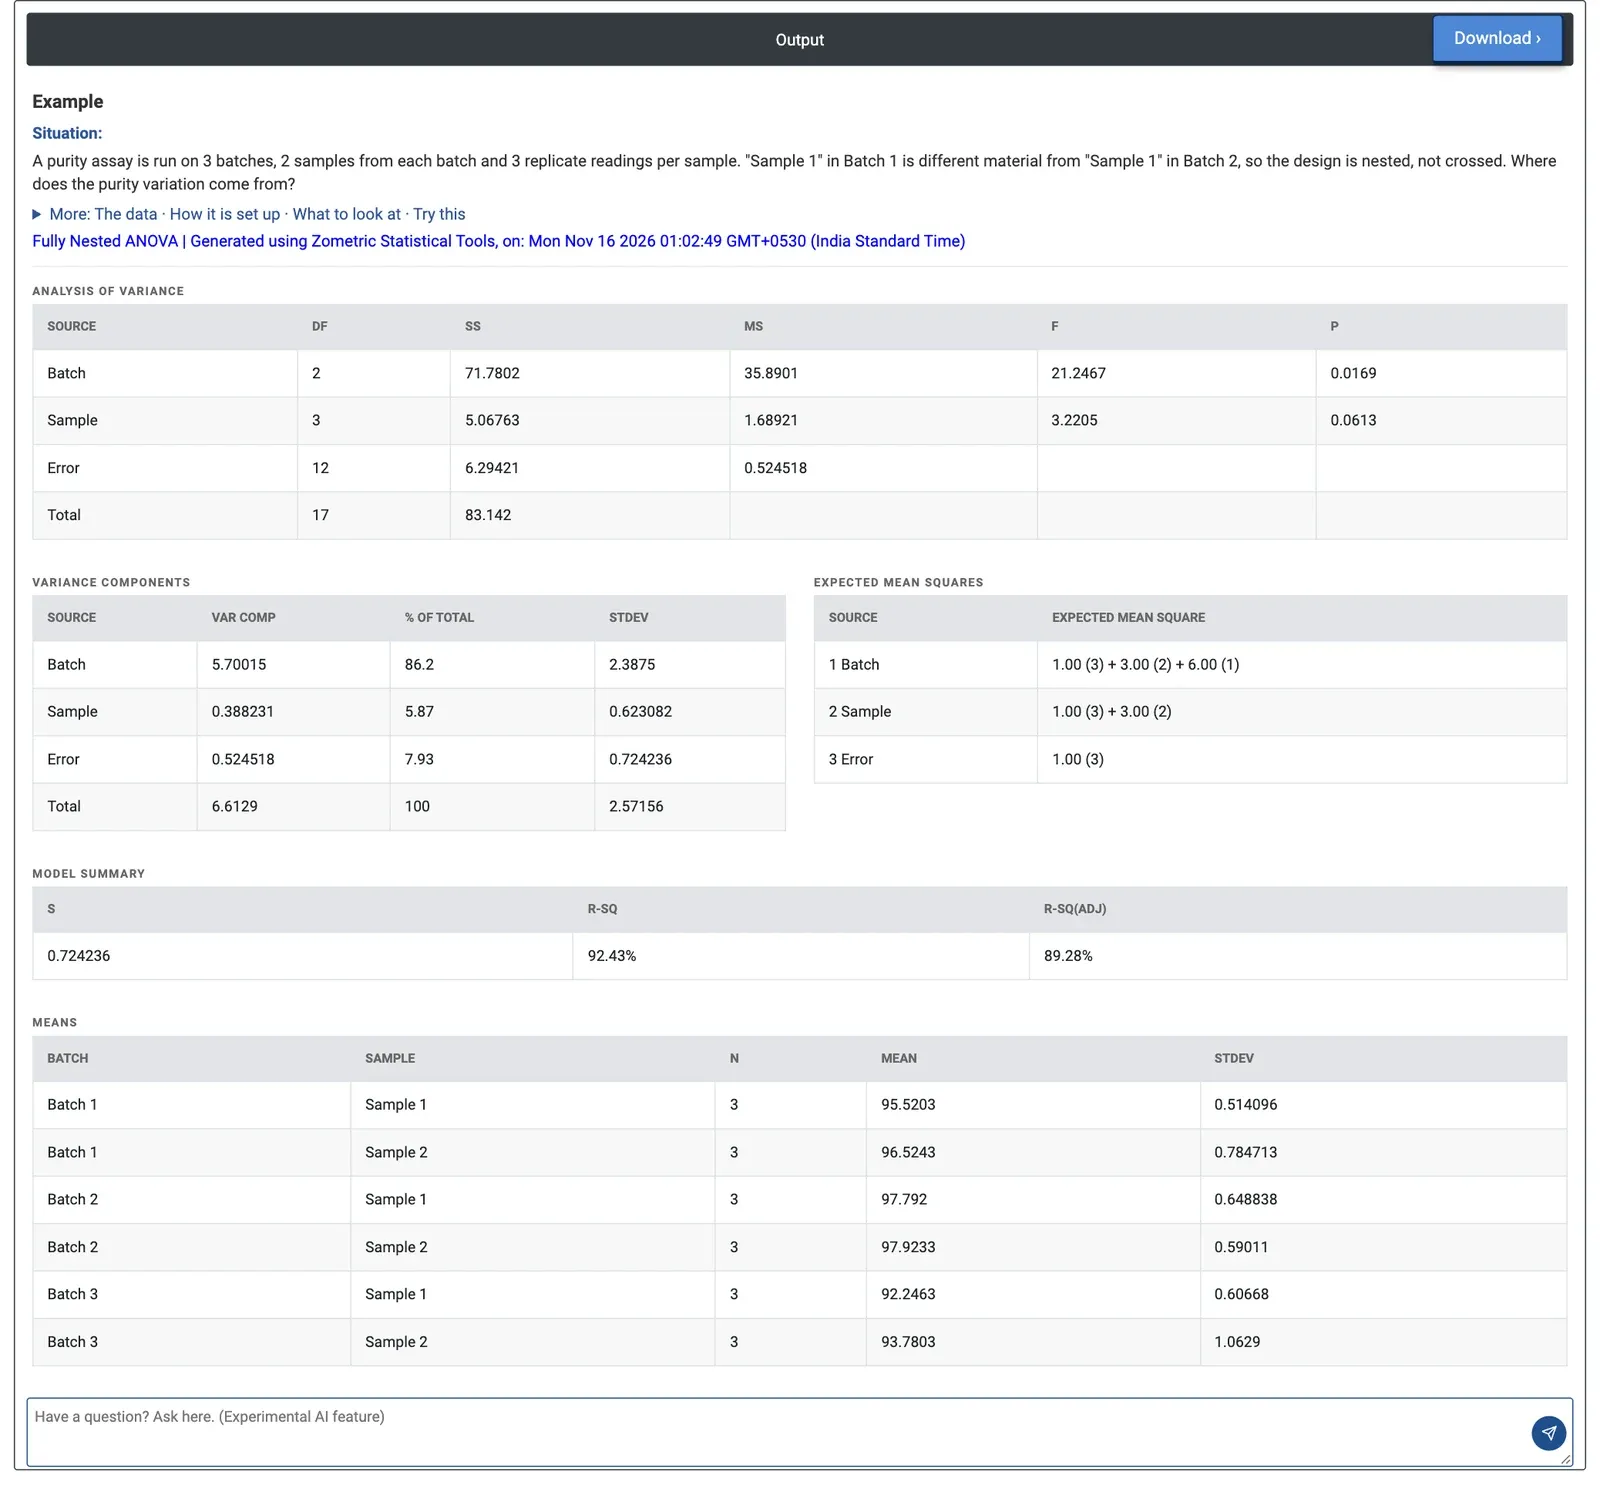
Figuur 2 — Geneste ANOVA van zuiverheid: de variatie tussen batches is 86.2% van het totaal; monsters binnen een batch voegen 5.87% toe en herhaalmetingen 7.93%.
Uitgewerkt voorbeeld
Een zuiverheidsassay wordt uitgevoerd op 3 batches, met 2 monsters per batch en 3 herhaalmetingen per monster: 18 resultaten. Het kwaliteitsteam wil weten of de spreiding in zuiverheid uit het batchproces, de bemonstering of de meting komt. Het selecteert Purity_pct als respons, Batch als Factor 1 en Sample als Factor 2; de herhaalmetingen vormen de fout.
De batches verschillen: F = 21.25 met 2 en 3 vrijheidsgraden, p = 0.0169 (Batch wordt getoetst tegen Sample binnen Batch). Monsters binnen een batch verschillen op het 5%-niveau niet significant (F = 3.22, p = 0.0613). Batch 3 scoort het laagst (celgemiddelden 92.25% en 93.78%) en Batch 2 het hoogst (97.79% en 97.92%).
De variantiecomponenten maken het beeld duidelijk: de variantie tussen batches is 5.70 (86.2% van het totaal, standaardafwijking 2.39 procentpunten), tussen monsters 0.388 (5.87%) en die van de herhaalmetingen 0.525 (7.93%, standaardafwijking 0.72). Betere bemonstering of een preciezere assay zou weinig veranderen; het team moet kijken naar wat er tussen batches verschilt.
Veelgestelde vragen
Wanneer gebruikt u een volledig geneste ANOVA?
Gebruik haar wanneer elke eenheid van een lager niveau bij slechts één eenheid van een hoger niveau hoort, bijvoorbeeld wanneer monster 1 van batch 1 niet hetzelfde materiaal is als monster 1 van batch 2, en u wilt weten waar de meeste variatie vandaan komt. Dat vertelt u of u moet ingrijpen in het proces, de bemonstering of de meting.
Hoe worden factoren getoetst in een volledig geneste ANOVA?
Alle factoren worden als willekeurig behandeld, elk genest in de voorgaande. Elke factor wordt getoetst tegen de volgende factor erbinnen, en de binnenste factor tegen de fout, dus F = MS(factor) / MS(volgende binnenste term). F en P worden alleen gegeven voor gebalanceerde ontwerpen; bij ongebalanceerde gegevens worden ze weggelaten, hoewel de variantiecomponenten nog steeds worden geschat.
Hoe interpreteert u variantiecomponenten in een geneste ANOVA?
Het % of Total van elke component is haar aandeel in de opgetelde variantie en haar StDev is de wortel ervan. In het zuiverheidsvoorbeeld was de variantie tussen batches 86.2% van het totaal, die tussen monsters binnen een batch 5.87% en die van herhaalmetingen 7.93%, dus betere bemonstering of een preciezere assay zou weinig veranderen en het team moet kijken naar verschillen tussen batches.
Hoeveel geneste factoren kan een volledig geneste ANOVA bevatten?
Twee tot vier geneste factoren, van de buitenste, zoals Batch, tot de binnenste, zoals Sample. Factor 1 en Factor 2 zijn vereist, terwijl Factor 3 en Factor 4 optioneel zijn, en Factor 4 vereist Factor 3. Herhaalmetingen binnen de binnenste factor vormen de fout en per geselecteerde respons wordt één analyse uitgevoerd.