
Algemeen lineair model (General Linear Model, GLM)
Het algemeen lineair model past vaste categorische factoren, optionele tweevoudige interacties en continue covariabelen aan met kleinste kwadraten, met gecorrigeerde (type III) of sequentiële kwadratensommen. Gebruik het wanneer eenweg-ANOVA niet volstaat of de gegevens onevenwichtig zijn. Het veronderstelt onafhankelijke, normaal verdeelde fouten met constante variantie. De uitvoer bevat de ANOVA-tabel, kleinstekwadratengemiddelden, coëfficiënten met VIF, meervoudige vergelijkingen en residuplots.
Laatst beoordeeld
Belangrijkste conclusie
Een algemeen lineair model (GLM) voert in één model een variantieanalyse uit met een of meer categorische factoren, hun tweevoudige interacties en continue covariabelen, ook bij onevenwichtige gegevens, en omvat tweeweg-ANOVA.
Op deze pagina
Doel
Het General Linear Model (GLM) voert in één model een variantieanalyse uit met een of meer categorische factoren, hun tweevoudige interacties en continue covariabelen. Gebruik het wanneer een eenweg-ANOVA niet volstaat: bijvoorbeeld wanneer de opbrengst kan afhangen van de machine, de operator, de manier waarop die twee samenwerken en ook van een gemeten omstandigheid zoals temperatuur, of wanneer de gegevens onevenwichtig zijn. Het omvat ook de klassieke tweeweg-ANOVA.
Belangrijkste mogelijkheden
- Een willekeurig aantal vaste categorische factoren, op verzoek met alle tweevoudige factorinteracties.
- Continue covariabelen opgenomen als hoofdeffecten (covariantieanalyse).
- Gecorrigeerde (type III) of sequentiële (type I) kwadratensommen; correcte toetsen voor onevenwichtige gegevens.
- Kleinstekwadratengemiddelden voor elke factor, gecorrigeerd voor de overige termen.
- Meervoudige vergelijkingen van de kleinstekwadratengemiddelden van één factor met Tukey, Fisher, Bonferroni, Sidak of Dunnett (tegen een controle), met groepsletters en een intervalplot van de verschillen.
- Coëfficiënten met VIF, modeloverzicht met R-sq(pred), ongebruikelijke waarnemingen en vier residuplots.
- Data Options: selecteer een deel van de rijen vóór de analyse.
Statistische methoden
Het model wordt aangepast met gewone kleinste kwadraten. Factoren gebruiken sum-to-zero-codering (−1, 0, +1), zodat elke coëfficiënt de afwijking van een niveau ten opzichte van het algemene gemiddelde is en de type III-toets van een hoofdeffect middelt over de niveaus van de overige factoren. Rijen met een ontbrekende waarde in een geselecteerde kolom worden weggelaten. Elke term wordt getoetst met F = Adj MS(term) / MS(Error) op zijn eigen vrijheidsgraden en die van de fout; bij sequentiële kwadratensommen wordt elke term getoetst na de termen erboven. De rij Total is de totale kwadratensom om het gemiddelde, waarop de gecorrigeerde kwadratensommen bij onevenwichtige gegevens niet hoeven uit te komen.
S = √MS(Error). R-sq(pred) = 1 − PRESS / SS Total, waarbij PRESS de gekwadrateerde leave-one-out-voorspelfouten optelt. Een kleinstekwadratengemiddelde is de voorspelling van het model voor een factorniveau, met de overige factoren gemiddeld over hun niveaus en de covariabelen op hun gemiddelde; anders dan ruwe gemiddelden wordt het niet vertekend door ongelijke groepsgroottes of verschillen in covariabelen.
Vergelijkingen gebruiken het verschil tussen kleinstekwadratengemiddelden met de standaardfout uit de covariantiematrix van de coëfficiënten. Tukey gebruikt de gestudentiseerde verdeling van de spreidingsbreedte voor alle paren; Fisher gebruikt afzonderlijke t-toetsen; Bonferroni en Sidak corrigeren de kritieke t-waarde voor het aantal paren; Dunnett vergelijkt elk niveau met een controle met de multivariate t-verdeling. Een interval dat nul niet bevat, of gemiddelden die geen groepsletter delen, wijzen op een significant verschil. Gestandaardiseerde residuen buiten ±2 worden gemarkeerd met R en hefboomwaarden boven 3p/n met X. Het model veronderstelt onafhankelijke, normaal verdeelde fouten met constante variantie: controleer de residuplots.
Invoervelden en opties
Veld | Beschrijving |
Response (Y) | Numerieke responskolom. Verplicht. |
Factors (categorical) | Een of meer categorische voorspellerkolommen. Verplicht. |
Covariates (continuous) | Optionele numerieke kolommen, alleen als hoofdeffecten opgenomen (geen interacties met factoren). |
Include all 2-way factor interactions | Standaard aangevinkt: voegt elke interactie tussen twee factoren toe. |
Confidence level | Standaard 95; gebruikt voor de vergelijkingen. |
Comparison procedure | None (default), Tukey, Fisher, Bonferroni, Sidak of Dunnett (vs. a control level). |
Comparison factor | Van welke factor de kleinstekwadratengemiddelden worden vergeleken; verplicht als een procedure is gekozen. |
Control group level (Dunnett) | Controleniveau voor Dunnett; leeg gebruikt het eerste niveau. |
Grouping information / Interval plot for differences of means | Standaard aangevinkt: tabel met groepsletters en plot van de vergelijkingsintervallen. |
Sum of squares for tests | Adjusted (Type III, default) of Sequential (Type I). |
Residual versus fit graph / Residual versus order graph / Histogram / Probability plot | Residuplots; allemaal standaard aangevinkt. |
Data Options: Subset (optional) | Exclude matching rows (standaard) of Include only matching rows, op basis van rijnummers (bijv. 3,7,12-15) en/of een voorwaarde (bijv. Temperature_C > 185). |
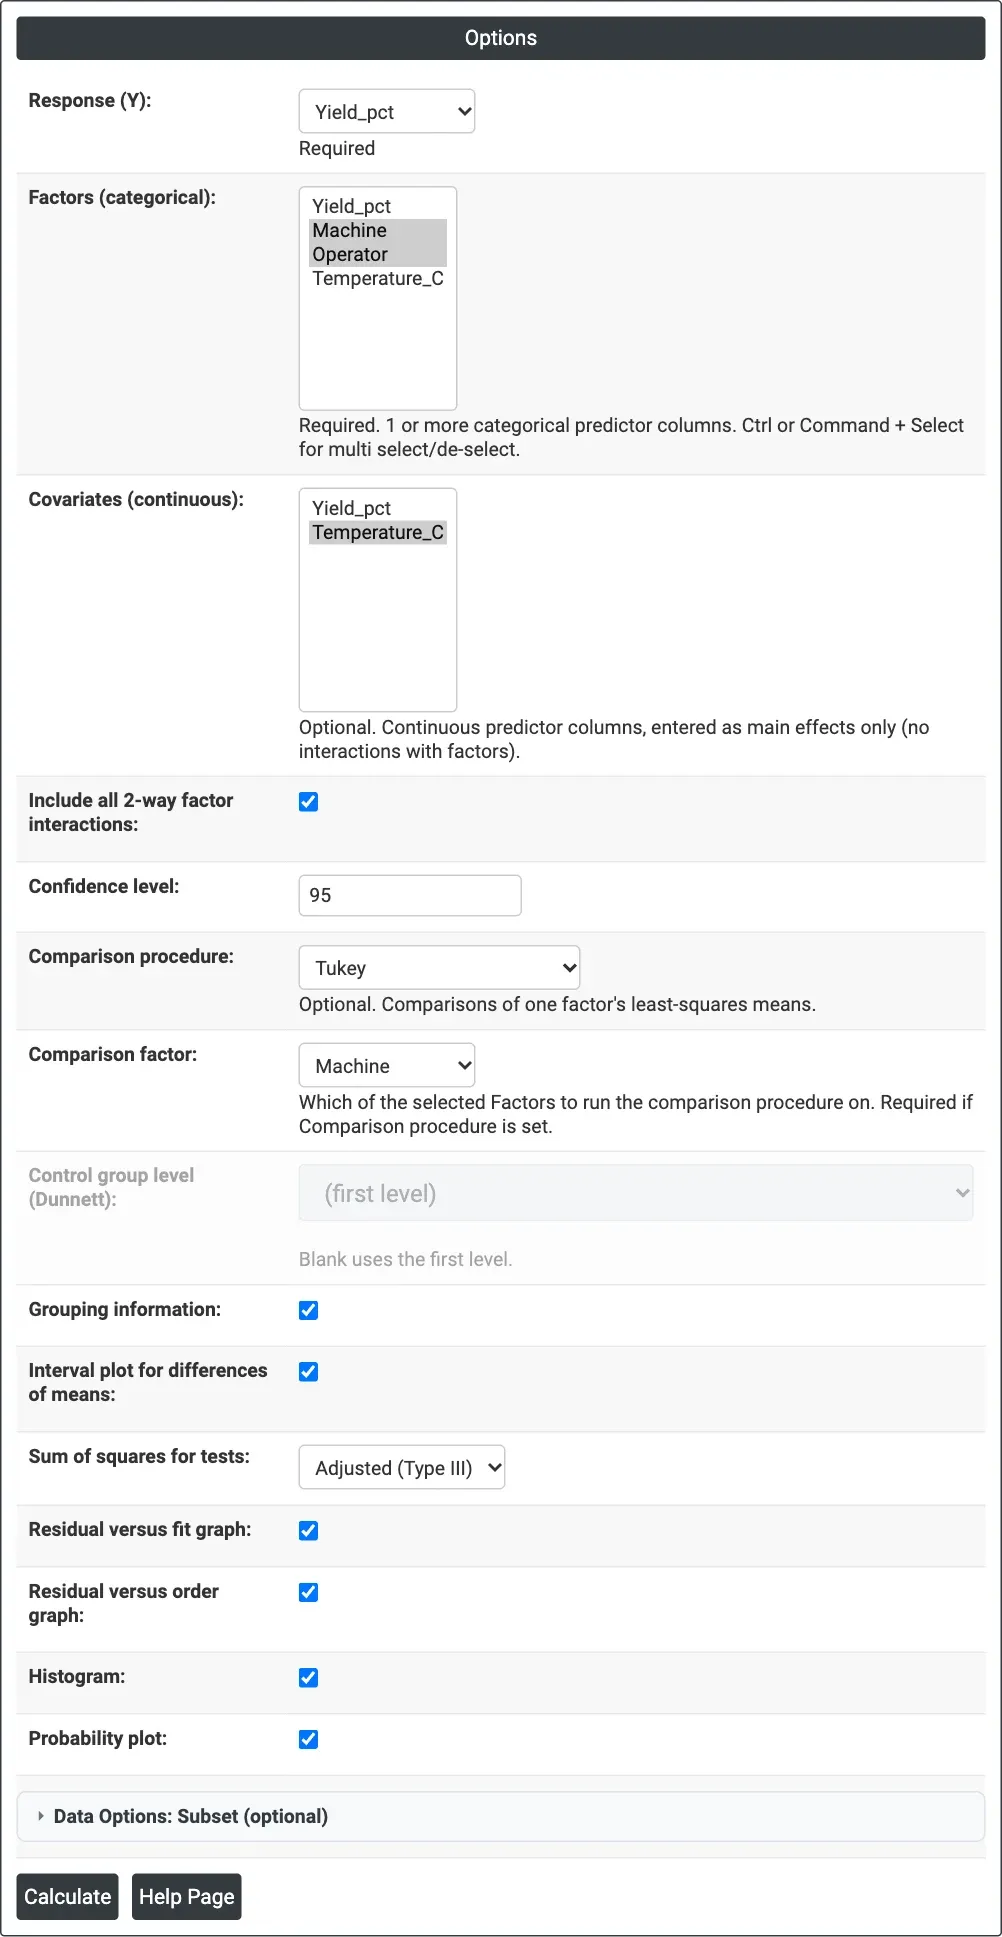
Figuur 1 — Opties voor het opbrengstvoorbeeld: Yield_pct met de factoren Machine en Operator, hun interactie, covariabele Temperature_C en Tukey-vergelijkingen van de machines.
Beschrijving van de uitvoer
- Method — factorcodering en type kwadratensommen.
- Factor Information — type, aantal niveaus en niveauwaarden van elke factor.
- Analysis of Variance — DF, Adj SS (of Seq SS), Adj MS, F-Value en P-Value voor elke term, de fout en het totaal.
- Model Summary — S, R-sq, R-sq(adj) en R-sq(pred).
- Least-Squares Means — N en LS mean van elk niveau van elke factor.
- Coefficients — Coef, SE Coef, T-Value, P-Value en VIF.
- Fits and Diagnostics for Unusual Observations — alleen getoond wanneer die er zijn.
- Grouping Information, Simultaneous (of Individual) Tests for Differences of Means en de intervalplot — wanneer een vergelijkingsprocedure is gekozen.
- Versus Fit, Versus Order, Residuals Histogram en Probability Plot.
- PDF-export via Download.
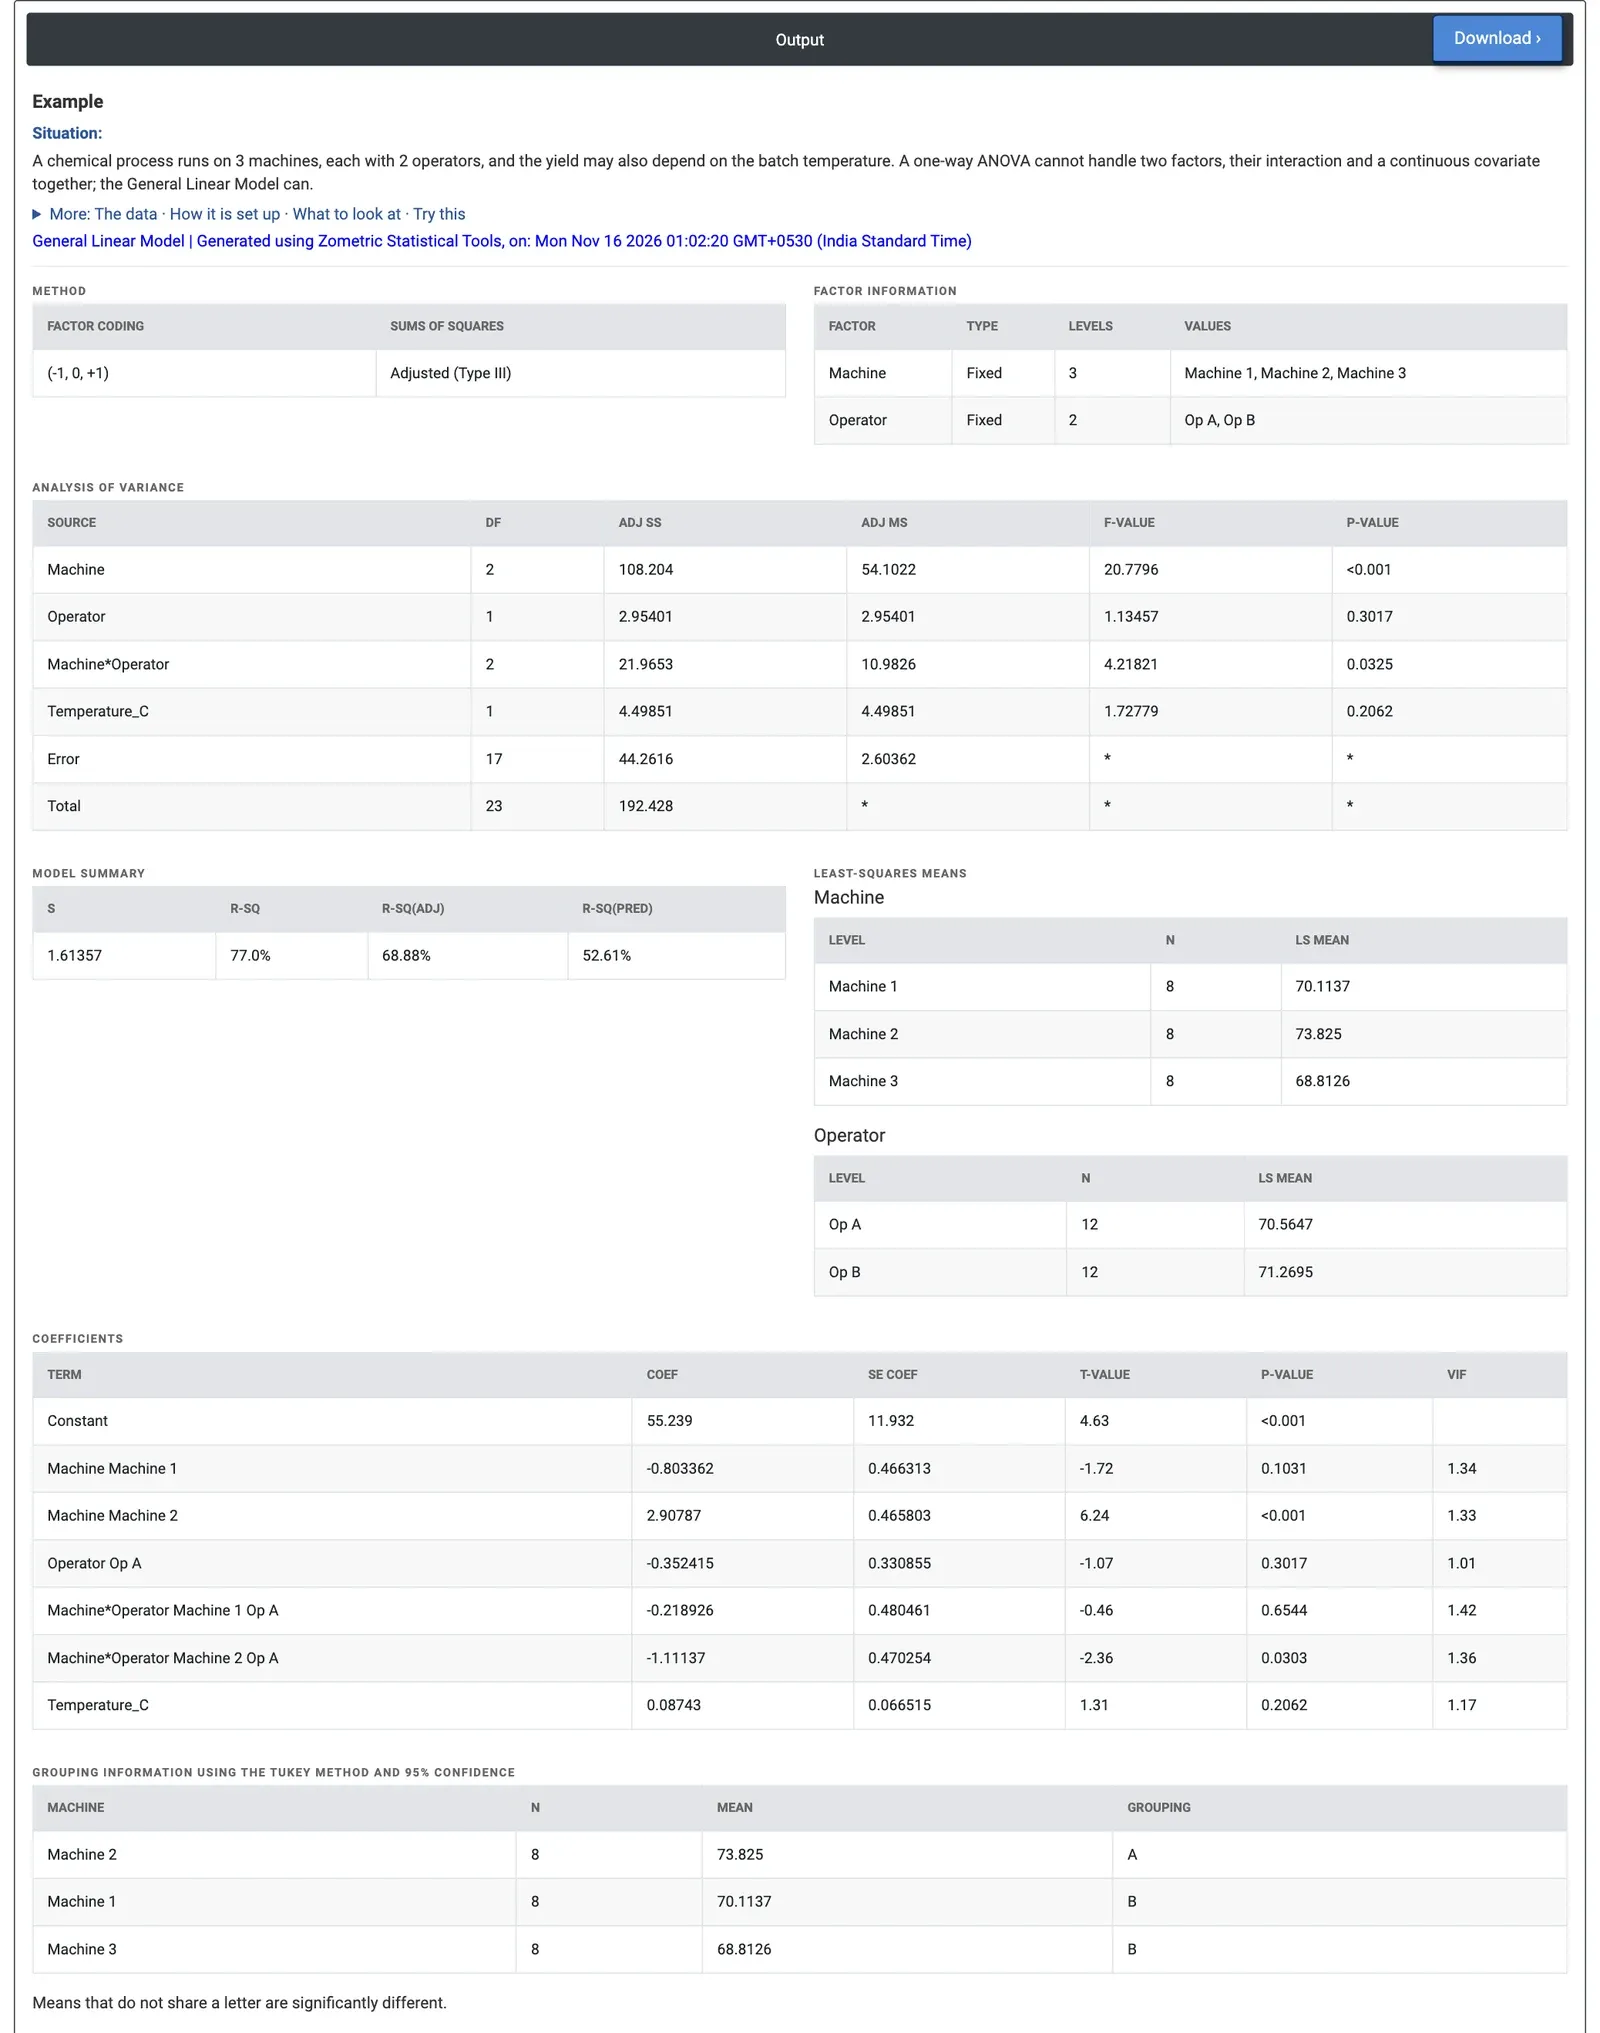
Figuur 2 — GLM-resultaten voor de opbrengst: Machine is significant (p < 0.001), net als de interactie Machine*Operator (p = 0.0325); Machine 2 heeft het hoogste LS-gemiddelde, 73.83%.
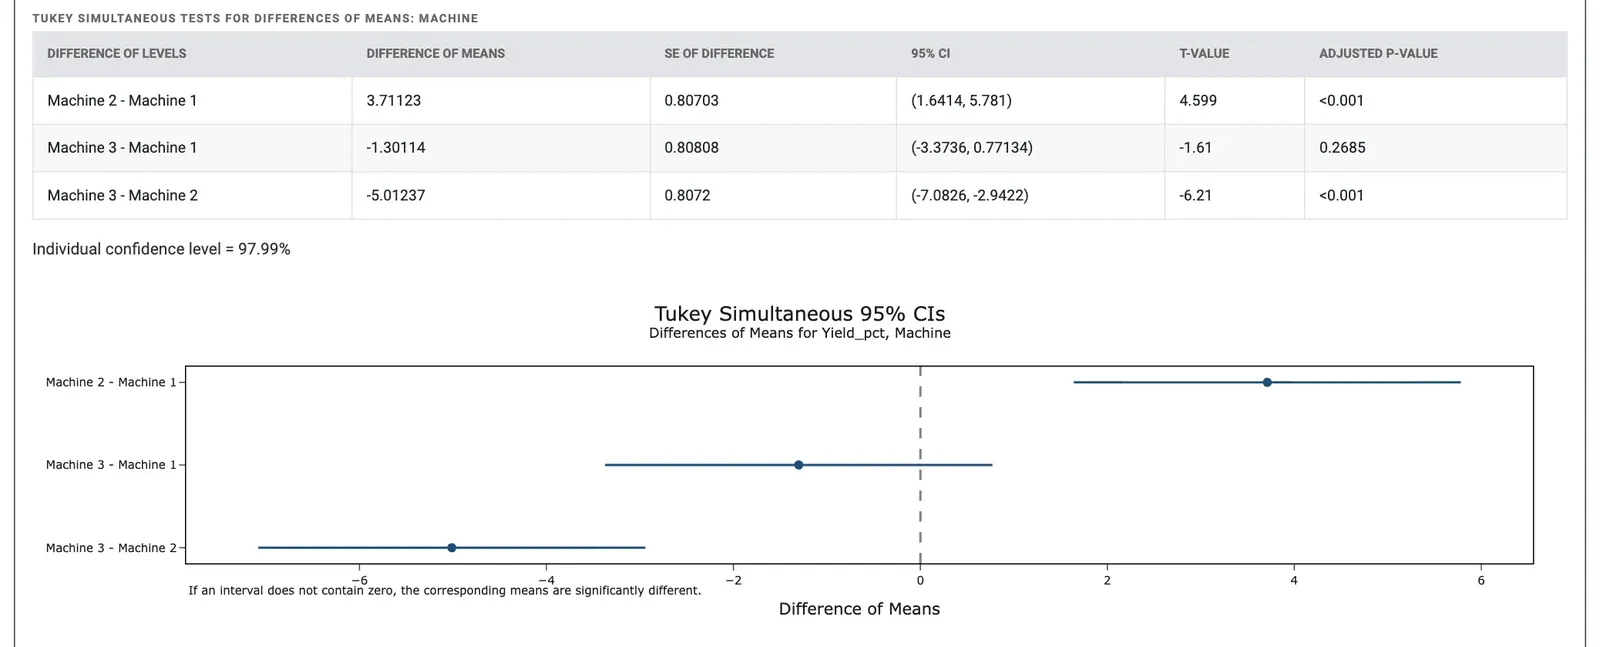
Figuur 3 — Tukey-vergelijkingen van de machines: Machine 2 verschilt van beide andere; het interval voor Machine 3 − Machine 1 bevat nul.
Uitgewerkt voorbeeld
Een chemisch proces draait op drie machines, elk met twee operators (Op A en Op B), en de batchopbrengst kan ook afhangen van de batchtemperatuur (170 tot 190 °C). Er zijn 24 batches, vier per machine en operator. De ingenieur kiest Yield_pct als respons, Machine en Operator als factoren met hun interactie, Temperature_C als covariabele en vraagt om Tukey-vergelijkingen van de machines.
De machines verschillen duidelijk (F = 20.78, p < 0.001). De interactie Machine*Operator is ook significant (F = 4.22, p = 0.0325): Op B haalt meer uit Machine 1 en 2, maar minder uit Machine 3. Operator op zichzelf (p = 0.3017) en temperatuur (p = 0.2062) hebben in het onderzochte bereik geen significant effect. Het model verklaart 77.0% van de variatie (R-sq(adj) 68.88%), met S = 1.61 procentpunt; R-sq(pred) is lager, 52.61%, dus voorspellingen voor nieuwe batches zijn minder nauwkeurig dan de pasvorm doet vermoeden.
De kleinstekwadratengemiddelden zijn 73.83% voor Machine 2, 70.11% voor Machine 1 en 68.81% voor Machine 3. Tukey plaatst Machine 2 alleen in groep A: die levert 3.71 punten meer op dan Machine 1 (95%-BI 1.64 tot 5.78) en 5.01 meer dan Machine 3, beide met gecorrigeerde p < 0.001, terwijl Machine 1 en 3 niet verschillen (gecorrigeerde p = 0.2685). De ingenieur onderzoekt wat er bij Machine 2 anders is en kijkt vanwege de interactie naar de combinatie van operators op Machine 3 voordat de methode wordt gestandaardiseerd.
Veelgestelde vragen
Wanneer gebruikt u een algemeen lineair model in plaats van eenweg-ANOVA?
Gebruik een algemeen lineair model wanneer een eenweg-ANOVA niet volstaat, bijvoorbeeld wanneer de opbrengst kan afhangen van de machine, de operator, de manier waarop die twee samenwerken en een gemeten omstandigheid zoals temperatuur, of wanneer de gegevens onevenwichtig zijn. Het verwerkt meerdere categorische factoren, tweevoudige interacties en continue covariabelen in één model en omvat ook de klassieke tweeweg-ANOVA.
Wat zijn kleinstekwadratengemiddelden in een GLM?
Een kleinstekwadratengemiddelde is de voorspelling van het model voor een factorniveau, met de overige factoren gemiddeld over hun niveaus en de covariabelen op hun gemiddelde. Anders dan ruwe gemiddelden wordt het niet vertekend door ongelijke groepsgroottes of verschillen in covariabelen. Meervoudige vergelijkingen in de GLM vergelijken deze kleinstekwadratengemiddelden tussen niveaus van één factor.
Welke methode voor meervoudige vergelijkingen gebruikt u in een GLM?
Tukey vergelijkt alle paren met de gestudentiseerde verdeling van de spreidingsbreedte; Fisher gebruikt afzonderlijke t-toetsen; Bonferroni en Sidak corrigeren de kritieke t-waarde voor het aantal paren; Dunnett vergelijkt elk niveau met een controle. Een interval dat nul niet bevat, of gemiddelden die geen groepsletter delen, wijzen op een significant verschil.
Wat zijn de aannames van een algemeen lineair model?
Het model veronderstelt onafhankelijke, normaal verdeelde fouten met constante variantie, wat u controleert met de residuplots: residuen tegen gefitte waarden, tegen volgorde, histogram en waarschijnlijkheidsplot. Gestandaardiseerde residuen buiten plus of min 2 worden gemarkeerd met R, en waarnemingen met een hefboomwaarde boven 3p/n worden als ongebruikelijk met X gemarkeerd.